記事の質を高めているのに、検索結果に思うように現れない。そのとき、記事の内容より先に確認したいのが、サイトの技術的な土台です。どれだけ質の高いコンテンツを作っても、検索エンジンがそのページにたどり着けなかったり、正しく読み取れなかったりすれば、評価の土俵にすら上がれません。
テクニカルSEOとは、検索エンジンが自社サイトを正しく発見・巡回(クロール)し、検索結果に登録(インデックス)できるよう、技術的な土台を整えることです。本記事では、企業の担当者が実務で確認すべき項目を7つの領域に整理し、「テクニカルSEOには何があり、どこから手を付ければよいか」という全体地図を示します。
個々の施策(たとえば特定ページの表示速度改善の具体的な実装方法)には踏み込まず、7領域と基本の確認方法までを扱います。URL単位の監査、サイト移行、各実装の詳細は、各領域で案内する個別の記事で扱います。
なお、生成AI検索(ChatGPT検索やGoogleのAI Overviews等)の技術対策は、通常のGoogle検索向けのテクニカルSEOと重なる部分がありつつも、AI系クローラー固有の論点が別にあります。たとえば、OAI-SearchBotなどAI別クローラーへの対応や、AIクローラーの多くがJavaScriptを実行しない点です。この記事では通常のGoogle検索向けの対策に絞り、AI検索クローラー固有の論点には深入りしません。
なぜテクニカルSEOが土台になるのか
この節では、テクニカルSEOをコンテンツSEOとどう位置づけ、どの順で取り組むかを整理します。
コンテンツSEO(キーワード選定や記事の質の向上)とテクニカルSEOは、しばしば対比的に語られますが、実際には順序の話です。検索エンジンがページをクロールできず、あるいはインデックスに登録できなければ、そのページがどれだけ優れた内容でも検索結果には表示されません。テクニカルSEOは、コンテンツの価値を検索エンジンに届けるための「配管」にあたる部分です。
テクニカルSEOの項目には、今日すぐ確認できるものと、改修に時間がかかるものが混在しています。前者の例はrobots.txt(クローラーのアクセスを制御するファイル)の設定ミス、後者の例はサイト構造の再設計やレンダリング方式の見直しです。全体像を把握しないまま個別の施策に飛びつくと、影響の小さい作業に時間を使ってしまいかねません。
そこで、まず自社サイトが7領域それぞれでどの状態にあるかを棚卸しし、影響が大きく着手しやすい項目から手を付けるのが実務上の進め方です。
テクニカルSEOの全体マップ:確認すべき7領域
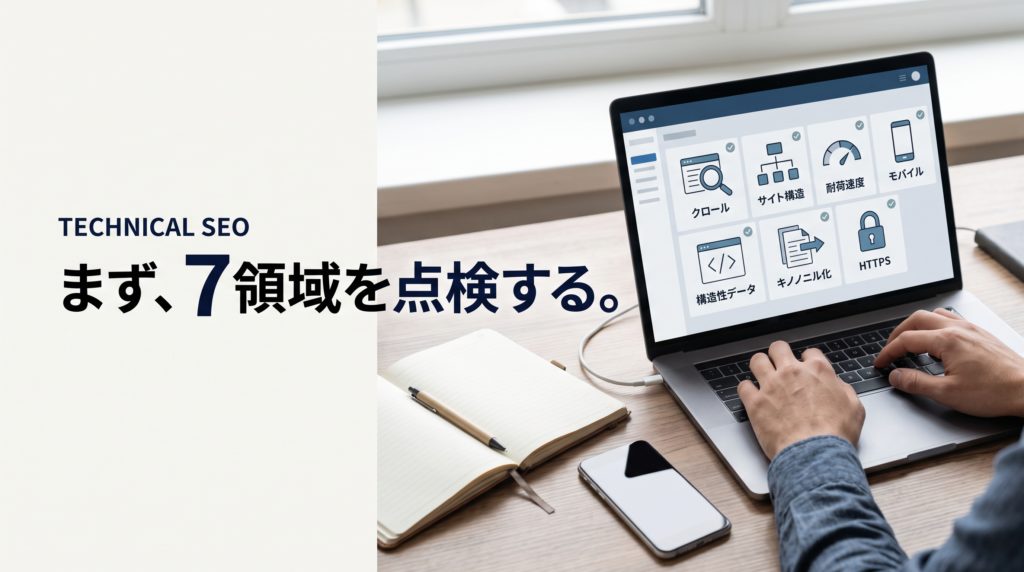
企業担当者が確認すべきテクニカルSEOは、大きく次の7領域に整理できます。図で全体を確認してから、各領域が問う内容を一覧で見ていきましょう。
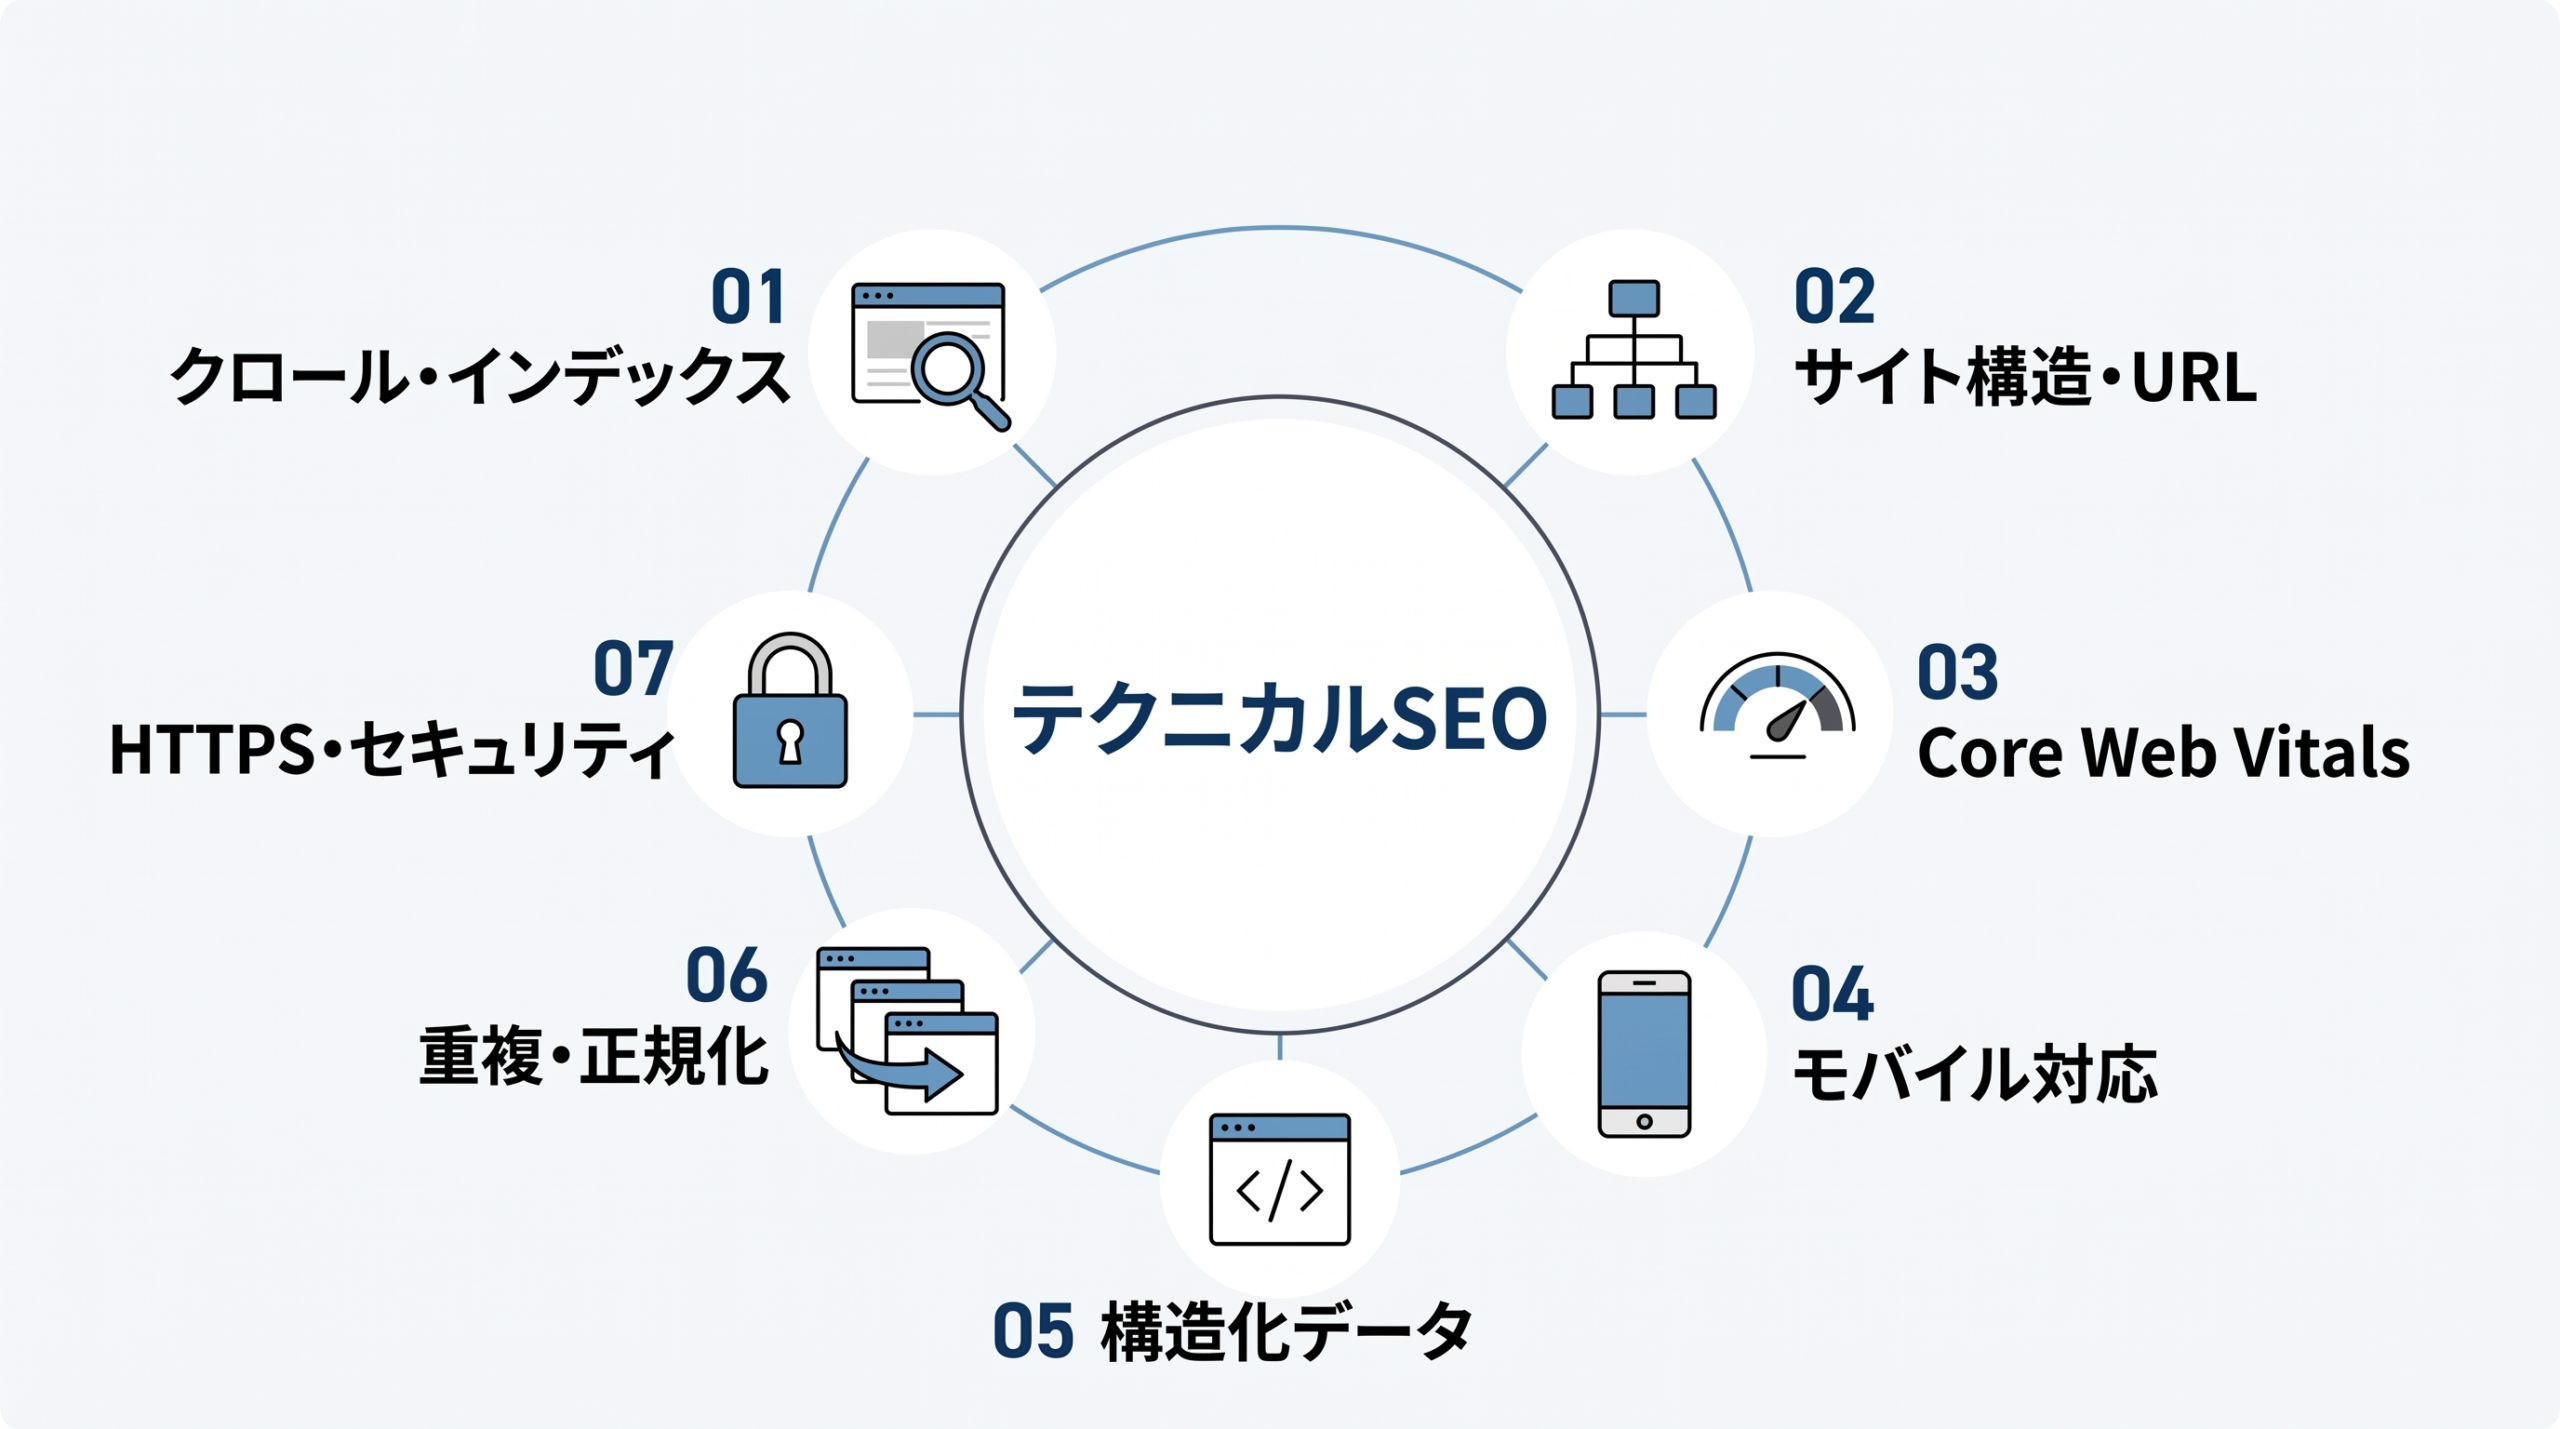
- クロールとインデックス登録:ページが検索エンジンに発見され、検索結果に登録されているか
- サイト構造とURL設計:サイト全体のテーマ構造が検索エンジンに伝わるか
- 表示速度とCore Web Vitals:ページ体験の指標が目安を満たしているか
- モバイル対応:スマートフォン向けの表示がデスクトップ版と同等か
- 構造化データ:ページ上の内容が正しくマークアップされているか
- 重複コンテンツと正規化:同じ内容の複数URLのうち、どれを正規として示すか
- セキュリティ(HTTPS等):サイト全体がHTTPSで提供されているか
テクニカルSEOを含むSEO全体の考え方は、「SEO対策完全ガイド」で整理しています。
1|クロールとインデックス登録:ページは検索エンジンに届いているか
この領域で確かめるのは、対象ページがGoogleに発見・クロールされ、検索結果に登録される状態になっているかどうかです。
まず、Search Consoleの「ページのインデックス登録」レポートで、除外されているページがないかを定期的に確認してください。新規公開や大幅更新をしたページは、URL検査ツールでインデックス登録をリクエストし、XMLサイトマップが最新の状態でSearch Consoleに送信されているかもあわせて確認します。
Search Consoleを初めて設定する場合は、Google Search Consoleの登録方法と基本指標で、所有権確認から最初に見る指標まで確認できます。
確認が必要なのは、クロールされるかどうかだけではありません。JavaScriptで表示内容を組み立てるサイトでは、Googleが内容を読み取るまでの処理段階も押さえておく必要があります。Googleは、JavaScriptを使ったWebアプリのページを「クロール」「レンダリング」「インデックス」の3段階で処理すると公式に説明しています。
流れは次のとおりです。Googleはまず、HTTPレスポンスのHTMLから一次的にURLを抽出します。200ステータスのページはレンダリング待ちのキューに登録され、JavaScript実行後のHTMLから改めてリンクが抽出されます。レンダリングには「evergreen版のChromium」が使われるとされていますが、キュー待ちによって、反映までに時間差が生じる場合があります。
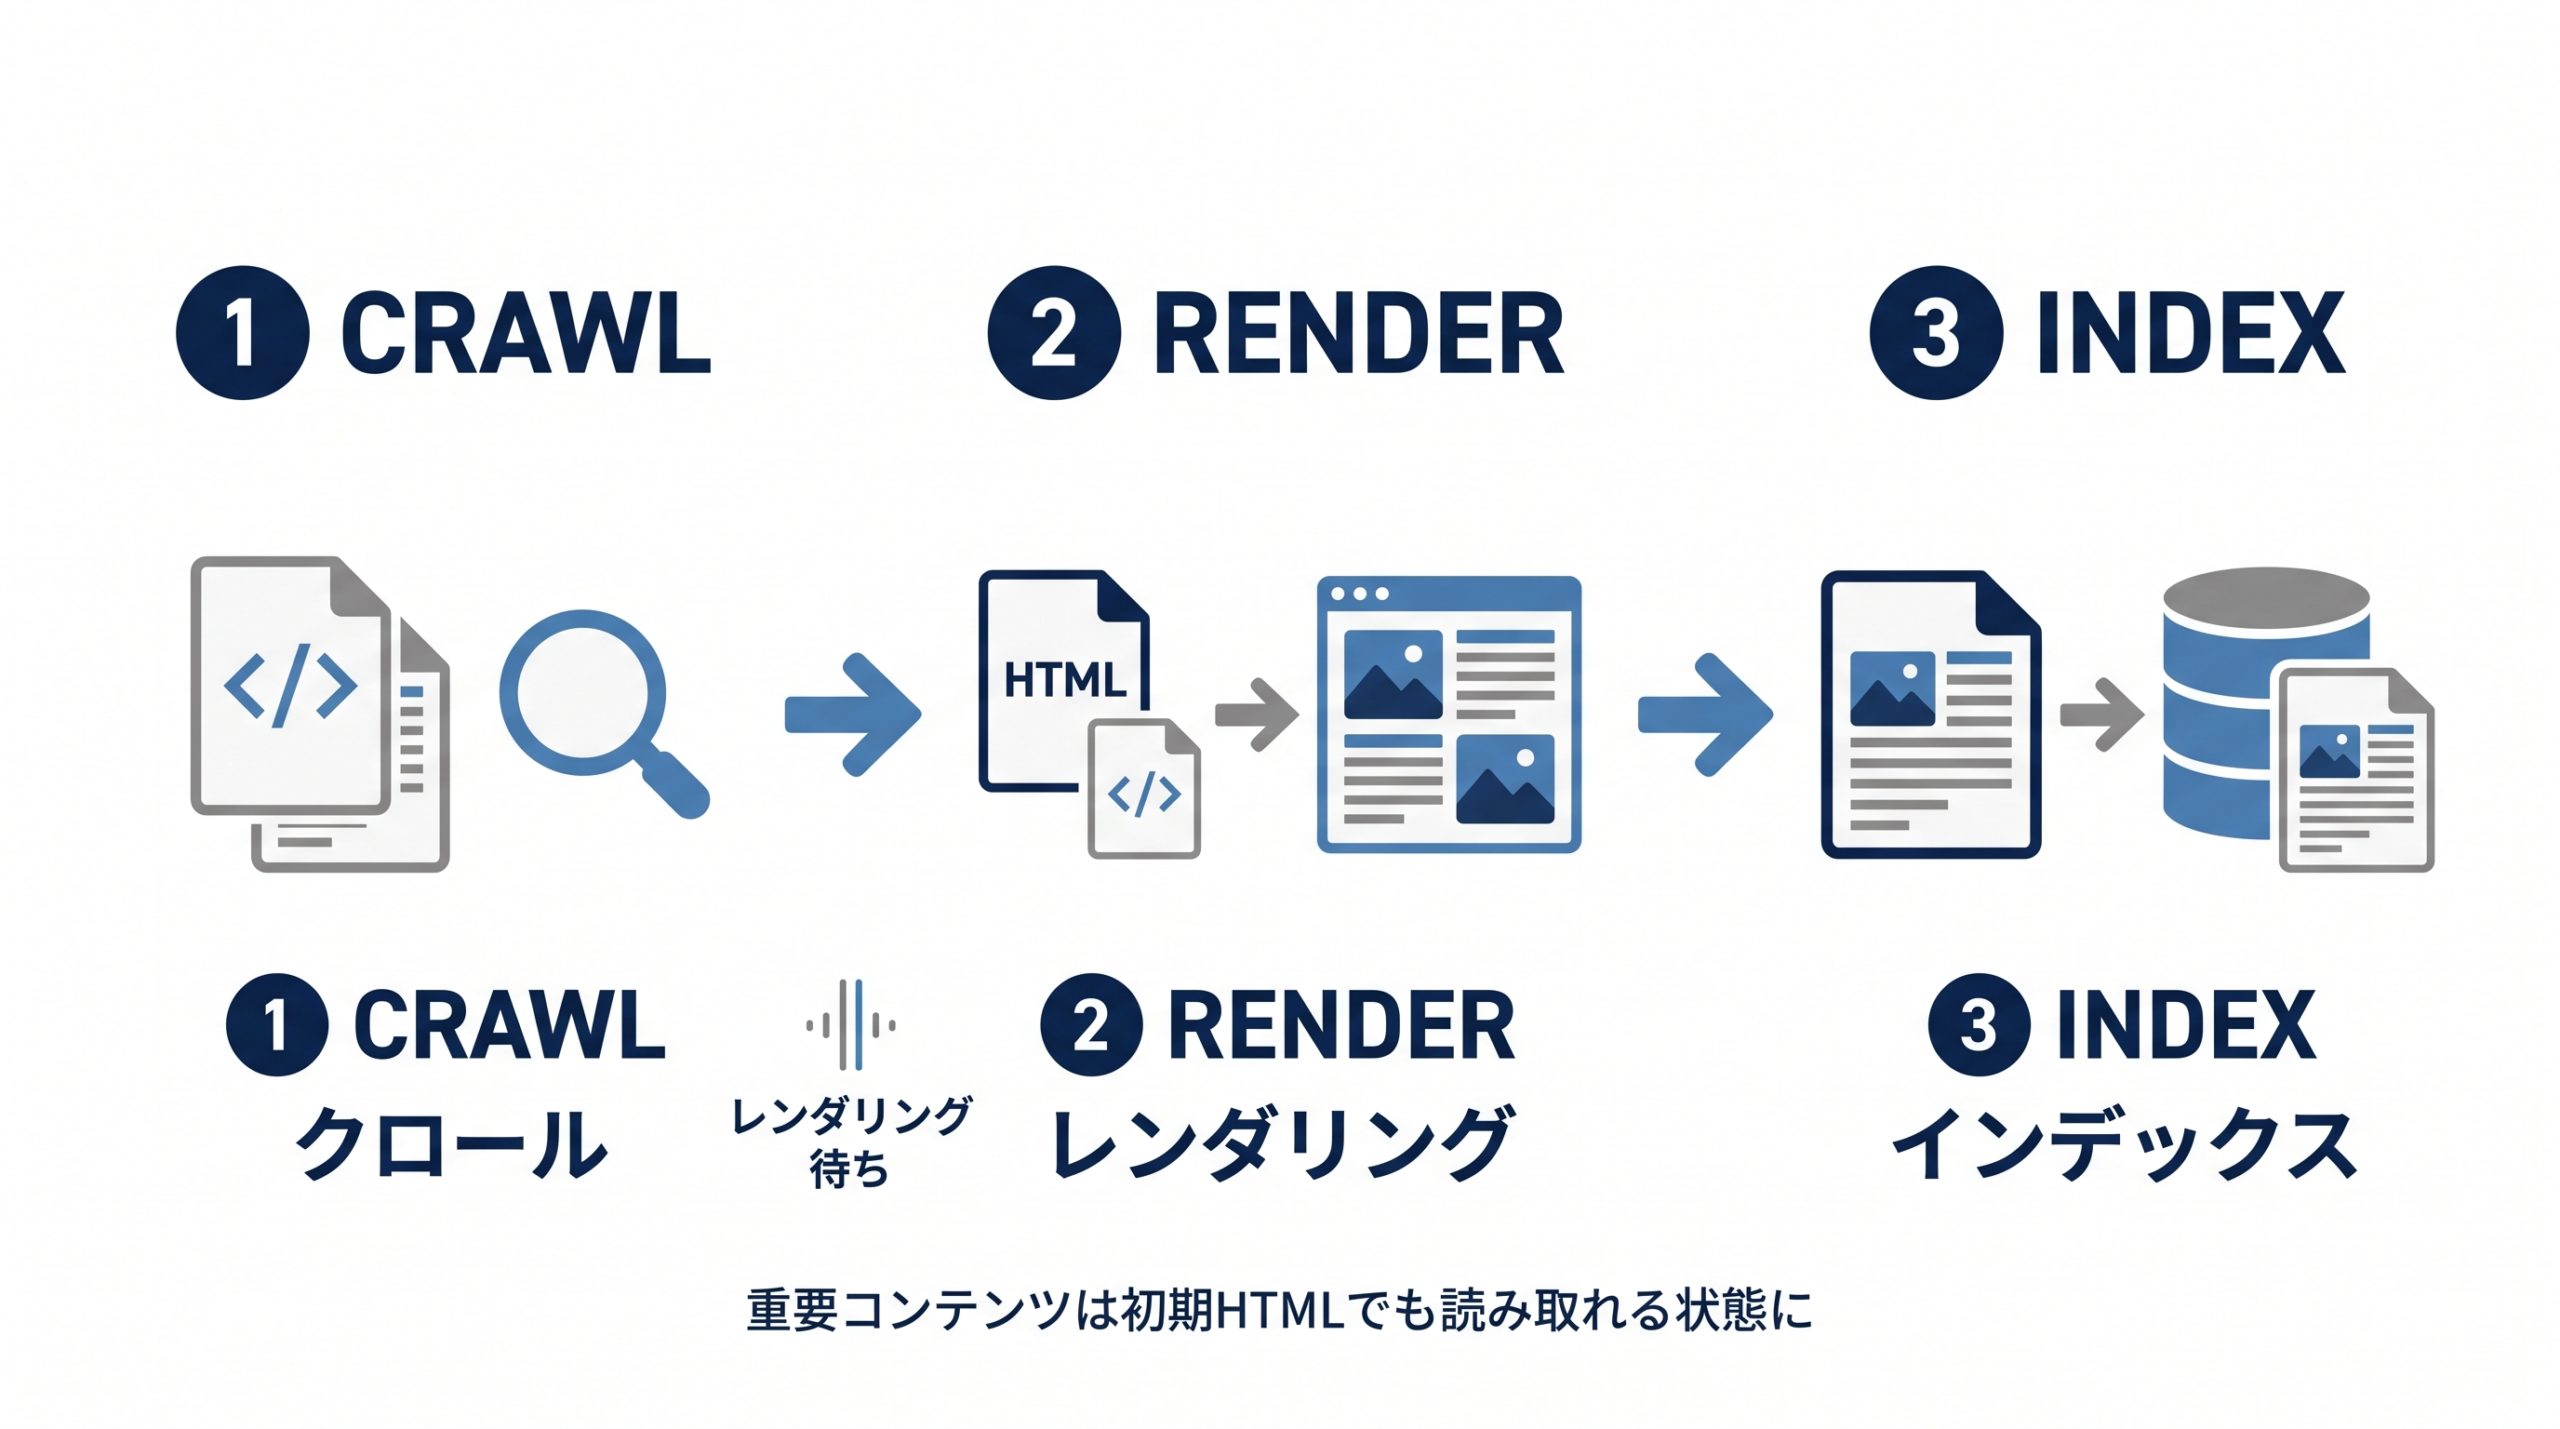
Google公式ドキュメントは、「サーバーサイドレンダリングやプリレンダリングは、依然として有効な考え方である。すべてのボットがJavaScriptを実行できるわけではないため」とも明記しています。そのため、重要なコンテンツはJavaScriptの実行に依存せず、初期HTMLの時点で読み取れる状態にしておくことが望まれます。AI検索クローラーの多くはJavaScriptをそもそも実行しないため、AI検索向けの技術対策では、この点の優先度はさらに高くなります。
もう一つ、規模によって意識が変わる概念に「クロールバジェット」があります。Google公式ガイドによれば、主な対象は、100万ページ以上あり週1回程度更新される大規模サイトと、1万ページ以上で日単位に急速に変化するサイトです。中小規模のサイトでは通常、意識する必要はありません。対象規模に該当する場合は、次の対策がクロールバジェットの効率化につながります。
- 重複コンテンツの統合
- robots.txtでの低価値ページのブロック
- 削除済みページへの404/410ステータスの返却
- サーバー応答速度の改善
サイトの状況によっては、次の記事で詳しい手順を確認できます。
- サイト内検索によって大量の検索結果URLが生成される場合は、サイト内検索結果ページのSEO監査方法で、index・noindex・クロール制御・発見経路をURLタイプ単位で確認できます。
- 404・soft 404は、件数をゼロにするのではなく、URLごとに移転・完全削除・内部リンク切れ・誤判定を分類して処置を分けます。具体的な判断手順は[404・soft 404のSEO監査方法](https://rebranding.co.jp/media/404-soft-404-seo-audit/)で解説しています。
- noindex・robots.txt・canonical・リダイレクトなどの事故は、事後の監査だけでなく、公開前の承認ゲートで防ぐことが重要です。GO/HOLDまで含む確認方法は[SEOリリース前チェックの作り方](https://rebranding.co.jp/media/seo-pre-release-checklist/)で解説しています。
2|サイト構造とURL設計:検索エンジンにサイトの構造は伝わるか
この領域で整えるのは、検索エンジンがサイト全体のテーマ構造を理解しやすい状態です。そのために、親子関係が明確なURL階層と、トピックごとにまとまった内部リンク構造を整えます。重要なページほど、トップページから少ないクリック数でたどり着ける位置に配置するのが基本です。あわせて、次の項目も基本の確認対象です。
- パンくずリストの設置
- カテゴリ構造とURLパスの整合
- 意味のあるURLスラッグ(無意味なID文字列を避ける)
一覧ページを分割している場合は、2ページ目以降の発見性やcanonicalの確認が必要です。具体的な手順は、[ページネーションのSEO監査方法](https://rebranding.co.jp/media/pagination-seo-audit/)で、URL・内部リンク・クロールまで順番に監査できます。
内部リンクを実際に点検し、修正対象の優先順位を決めるには、孤立ページ・リンク深度・被内部リンク数・アンカーテキストを見ます。具体的な監査手順は、「SEO内部リンクの監査方法|孤立ページ・リンク深度・アンカー偏りをどう直すか」で詳しく解説しています。
サイト構造を検索エンジンに伝える手段として、XMLサイトマップがあります。XMLサイトマップは、検索エンジンに「検索結果に表示したいURL」を伝えるための、最も汎用性の高い形式です。ただしGoogle公式ガイドは、「サイトマップの送信は単なるヒントに過ぎず、Googleが必ずクロール・使用することを保証するものではない」と明記しています。送信すれば必ず使われるわけではないことを前提に、次の点を押さえて運用します。
- 含める情報は、完全修飾(絶対パス)のURLと最終更新日(lastmod)が基本です。priorityやchangefreqの値はGoogleが無視するため、記載する価値は限定的です。
- 主要コンテンツを変更したタイミングで、lastmodを更新します。
- UTF-8エンコーディングで、1ファイルあたり50MB以下・5万URL以下という制限内に収めます。
サイトリニューアルでURL変更やCMS移行が発生する場合は、サイトリニューアルでSEO評価を落とさない移行方法で、URL対応表・301・canonical・計測・公開手順を確認できます。移行後にリダイレクト・canonical・サイトマップ・順位変動を確認する場合は、サイト移行後のSEO監査方法で確認できます。
3|表示速度とCore Web Vitals:基準を満たしているか
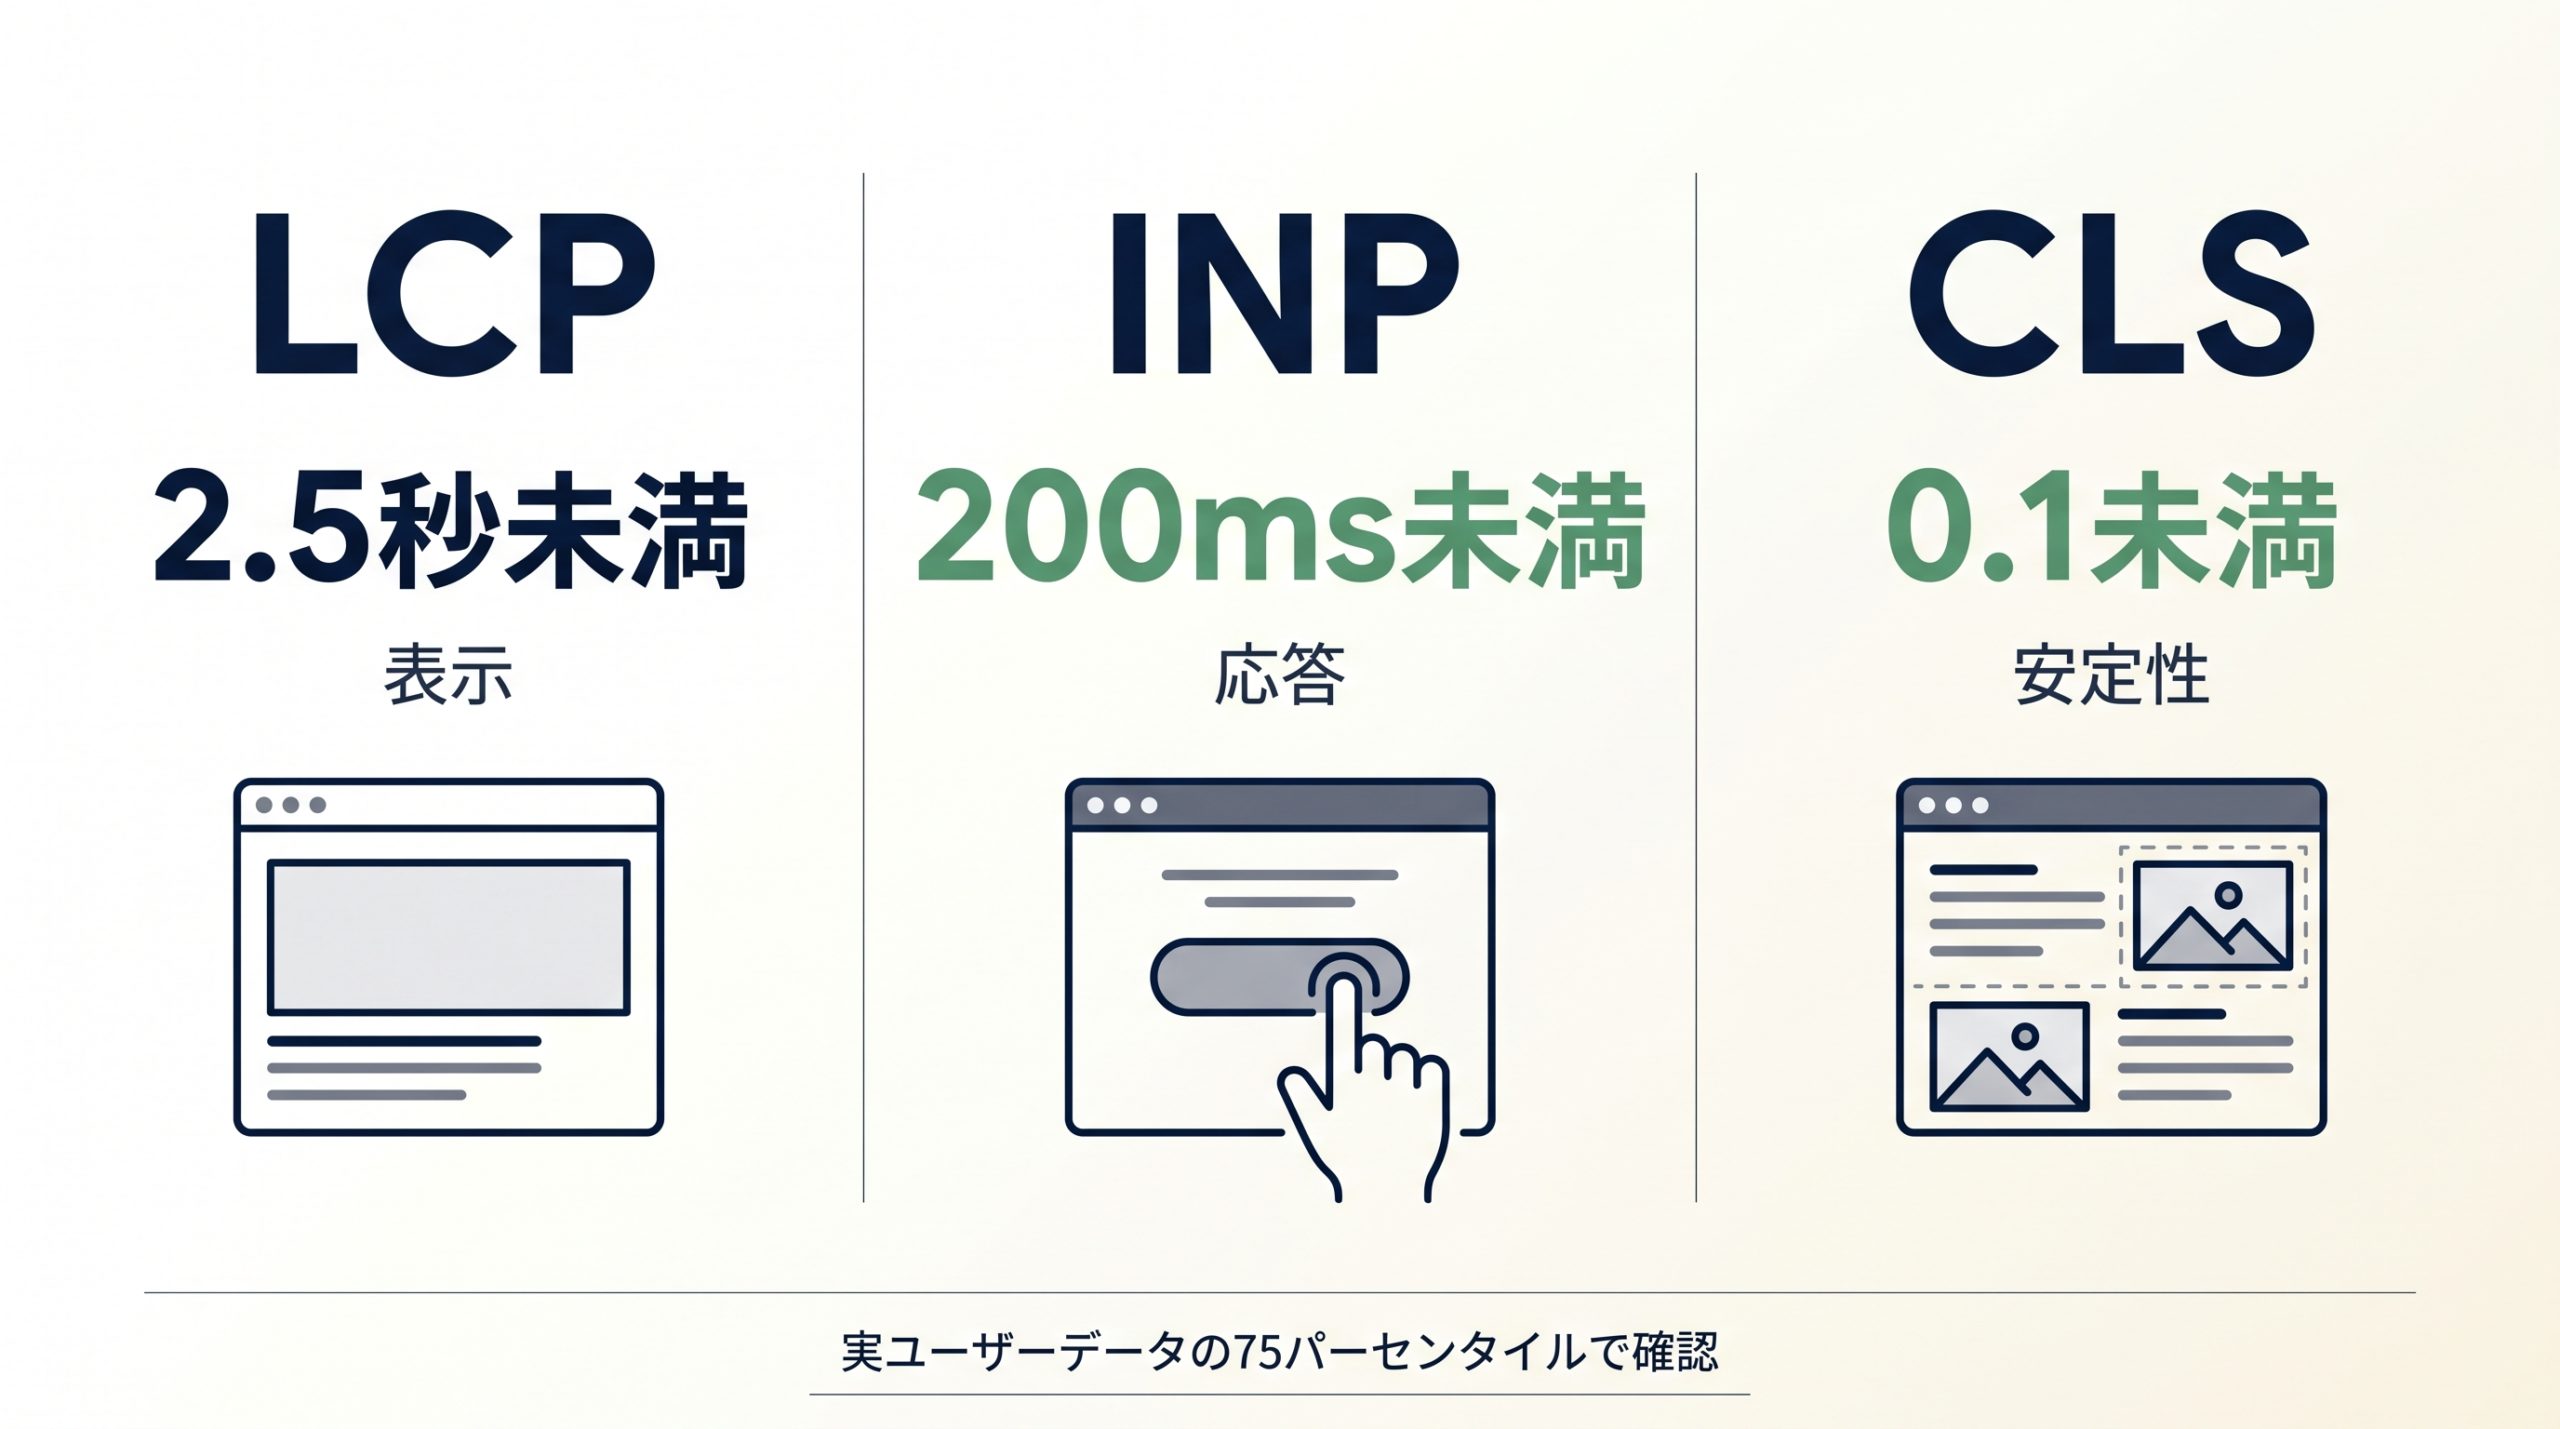
この領域では、Googleがページ体験の指標として公開している次の3つを確認します。
- LCP(最大コンテンツの描画時間):目安2.5秒未満
- INP(応答性):目安200ミリ秒未満
- CLS(レイアウトのずれ):目安0.1未満
これらは、実際の訪問者データ(Chrome User Experience Report)の75パーセンタイル値を、過去28日間のローリングウィンドウで評価します。PageSpeed InsightsやSearch Consoleの「ウェブに関する主な指標」レポートで、自社サイトがこの基準を満たしているかを定期的に確認してください。
表示速度は単独の指標というより、画像の最適化、不要なJavaScript・CSSの削減、サーバー応答速度、キャッシュ設定など、複数の要因が絡み合う総合指標です。そのため、個々の改善施策の優先順位は、PageSpeed Insightsの診断結果に沿って決め、影響の大きい項目から着手するのが実務的です。多くの場合は、画像サイズと未使用JavaScriptの削減が該当します。
本記事ではCore Web VitalsをテクニカルSEOの7領域の一つとして位置づけ、主要指標と基本的な確認方法までを扱います。LCP・INP・CLSそれぞれの悪化原因を切り分け、修正難易度と影響度から優先順位を付け、変更後に再検証する具体的な診断手順は、「Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け」で詳しく扱います。
画像資産に限定して、画像URL、alt、遅延読み込み、画像検索まで点検する場合は、画像SEOの監査方法で監査手順を整理しています。
4|モバイル対応:スマートフォン向けの表示で内容が欠けていないか
Googleは2020年に、全ウェブサイトを対象としたモバイルファーストインデックス(スマートフォン向け表示を評価の基準とする方式)への移行が完了したと発表しています。つまり、モバイル版の表示と内容が確認の出発点になります。Google公式のベストプラクティスは、次の2点を求めています。
- モバイル版のコンテンツがデスクトップ版と同等であること(テキスト・画像・動画・リンクを含む)
- タイトルやディスクリプション、robots metaタグ、構造化データが、モバイル版とデスクトップ版で一致していること
特に避けるべきなのは、ユーザーの操作(タップ・スワイプ等)をきっかけに主要コンテンツを遅延読み込みする実装です。Googlebotがその操作を再現しないため、存在しないコンテンツとして扱われるリスクがあるとされています。
確認の基本は、スマートフォン実機またはブラウザのモバイルエミュレーションで表示を確かめることです。加えて、Search Consoleでモバイル版とデスクトップ版のインデックス状況に差がないかをチェックしましょう。
5|構造化データ:ページの内容を正しく伝えられているか
構造化データ(schema.org形式のマークアップ)は、検索結果でのリッチリザルト(星評価・パンくずリスト・FAQ等の拡張表示)の表示に使われます。Google公式ガイドが対応形式として挙げているのは、次の3形式です。
- JSON-LD(<script>タグへの埋め込み。実装・保守が容易なため推奨)
- Microdata
- RDFa
Google公式の事例では、リッチリザルトとして表示されたページは、非リッチリザルトのページと比べてクリックスルー率が高くなる(Nestléの事例で82%高い)、リッチリザルト対応後に訪問数が増加した(Food Networkの事例で35%増加)としています。これらは個別の事例であり、どのサイトでも同じ結果になることを保証するものではありません。
実装にあたって重要なのは、「構造化データはそのページに実際にあるコンテンツを説明するものでなければならない」という原則です。ページ上に存在しない情報や、ユーザーには非表示の情報をマークアップに含めることは避けます。実装後は、Googleのリッチリザルトテストで検証することが推奨されています。
どの構造化データを優先的に実装すべきかという詳細な優先順位は、この記事の範囲外です。必要に応じて、個別の記事を参照してください。
求人ページでは、給与・勤務地・期限など本文とJobPostingの不一致を求人単位で確認するJobPosting構造化データの監査方法もあわせて実施してください。
6|重複コンテンツと正規化:どのURLを正規として示すか
同一または類似のコンテンツが複数のURLで存在する状態を、重複コンテンツと呼びます。原因はさまざまで、主に次のようなものがあります。
- 地域別バリエーション
- デバイス別バージョン
- HTTP/HTTPSの混在
- ソート・フィルタリング機能によるパラメータ違いのURL
- 意図せず公開されたテスト用ページ
Google公式ガイドは、こうした重複がある場合にGoogleが「収集したシグナルに基づいて、検索ユーザーにとって最も完全で有用と客観的に判断したページ」を正規URLとして選ぶと説明しています。判断材料となるシグナルには、HTTP/HTTPSの別、リダイレクトの有無、サイトマップへの記載、rel=”canonical”タグ(重複するページの代表URLを示す指定)が含まれます。
注意したいのは、Google公式ガイドが「正規URLの示唆はヒントであり、ルールではない(indicating a canonical preference is a hint, not a rule)」と明記している点です。つまり、rel=”canonical”タグを設置しても、Googleが別のURLを正規と判断する可能性があります。そのため実務では、次の3つの手段を組み合わせて、正規化の意図を明確に示すことが基本です。
- rel=”canonical”タグを設置する
- 恒久的に統合する場合は、301リダイレクトを設定する
- サイトマップには正規URLのみを記載する
7|セキュリティ(HTTPS等):サイト全体がHTTPSになっているか
Googleは2014年8月に、HTTPS(サイト全体のSSL/TLS暗号化)をランキングシグナルとして採用したことを公式に発表しています。発表当初は、「全世界のクエリの1%未満に影響する軽量なシグナルであり、高品質なコンテンツなど他のシグナルより比重は小さい」と説明されていました。
発表から10年以上が経過した現在、GoogleのTransparency Report(HTTPS暗号化状況の公開データ)によれば、OS別のHTTPS利用率は2015年時点の30〜45%から2020年には95〜99%まで上昇し、その後は高い水準で推移しています。つまり現在では、HTTPS化はランキングで優位に立つための施策というより、大半のサイトが満たしている「前提条件」に近い位置づけです。
さらに2026年には、Chromeブラウザ側でも動きがあります。Google Chromeセキュリティチームは、「Always Use Secure Connections」設定を段階的にデフォルト化する方針を明らかにしています。導入は次の予定とされています。
- 2026年4月(Chrome 147):「セーフブラウジングの保護強化」設定を有効にしている10億人以上のユーザー向けに先行導入
- 2026年10月(Chrome 154):全ユーザーへの展開が始まる予定
この設定が有効になると、ChromeはHTTPS接続を優先的に試み、HTTPSに対応していない公開サイトへのアクセス時には確認画面を表示するようになります。ローカルルーターや社内イントラネットなど非公開のネットワークは対象外とされています。自社サイトがまだ独自ドメイン全体でHTTPS化されていない場合や、一部ページ・サブドメインにHTTPの混在(混在コンテンツ)が残っている場合は、この変更を待たずに、優先的に確認・対応すべき項目です。
よくある誤解:構造化データや表示速度だけで十分か
テクニカルSEOというと、「構造化データを増やせば良い」「表示速度さえ速ければ十分」といった特定の施策に注目が集まりがちですが、これらは全体のごく一部にすぎません。構造化データはリッチリザルト表示のための補助であり、クロール・インデックスという土台が整っていなければ、そもそも評価の対象になりません。
そのため、まず優先すべきは、クロール可能性や重複コンテンツの整理といった基礎の底上げです。個別の施策はその土台の上に積み上げるものと捉えるのが、実務上の姿勢です。
まとめ:最初の一歩は7領域の棚卸し
テクニカルSEOは、単一の施策ではなく、クロール・インデックスの最適化からセキュリティの基本までを含む一連の仕組みです。判断の軸は、検索エンジンがページを見つけ、正しく読み取り、検索結果に登録できる状態になっているかどうかです。
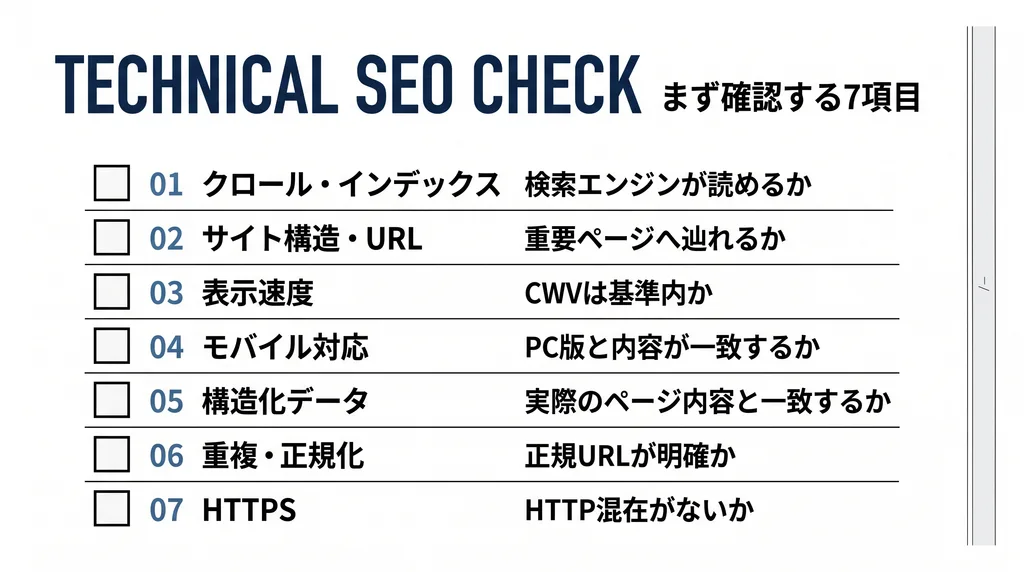
最初の一歩は、自社サイトが今どの段階にあるかを7領域で棚卸しすることです。次の項目で現状を確かめ、影響が大きく着手しやすいものから手を付けましょう。
- クロールとインデックス登録:Search Consoleで除外されているページがないか。重要なコンテンツが初期HTMLの時点で読み取れるか
- サイト構造とURL設計:重要なページにトップページから少ないクリック数でたどり着けるか。XMLサイトマップが最新か
- 表示速度とCore Web Vitals:LCP・INP・CLSが目安を満たしているか
- モバイル対応:モバイル版とデスクトップ版で、コンテンツやタイトル、構造化データが一致しているか
- 構造化データ:ページ上にある内容だけをマークアップし、リッチリザルトテストで検証したか
- 重複コンテンツと正規化:rel=”canonical”、301リダイレクト、サイトマップの正規URLで、正規化の意図をそろえて示せているか
- セキュリティ(HTTPS等):サイト全体がHTTPSになり、HTTPの混在が残っていないか
個別の論点をさらに詳しく検証したい場合は、テーマごとの専門記事を参照してください。次の3本は、実務の手順を解説しています。
- 構造化データの実装後に、エラー・内容不一致・重複を検証する手順:「構造化データのSEO監査方法|実装後のエラー・内容不一致・重複を検証する手順」
- ログやURL群から無駄なクロールを見つけ、改善の優先度を決める手順:「クロールバジェットを監査する方法|ログ・URL群・無駄クロールから改善優先度を決める」
- レンダリング・内部リンク・インデックスの差分を確認する手順:「JavaScript SEOの監査方法|レンダリング・内部リンク・インデックス差分を確認する」
‹ 親記事: SEO対策完全ガイド|SEOとは?仕組み・やり方・優先順位からAIO時代のSEOまで解説【2026年版】
このテーマの記事
- › INDEX削除(インデックス削除)とは?検索結果から消える仕組みと対処法
- › Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け
- › SEO内部リンクの確認方法|孤立ページ・深度・アンカー偏りを改善
- › ページがインデックスされない原因は?Search Consoleで未登録・除外・重複URLを確認
- › JavaScript SEOの確認方法|表示・内部リンク・登録状況
- › クロールバジェットの確認方法|無駄なクロールと改善優先度
- › 構造化データの確認方法|エラー・本文との不一致・重複を検証
- › 多言語ページの言語・地域指定を確認|相互参照・正規URLをチェック
- › 絞り込み検索のSEO確認方法|URL増加・クロール・重複を防ぐ
- › SEOリダイレクトの確認方法|多段転送・ループ・誤転送を検出
- › robots設定のSEO確認方法|クロール許可と登録制御の矛盾を確認
- › ページネーションのSEO確認方法|正規URL・内部リンク・クロール
- › サイト移行後のSEO確認方法|転送・正規URL・順位変動を確認
- › 404・soft 404のSEO確認|リンク切れ・消失URLを修正
- › SEOリリース前チェックの作り方|noindex・canonical・robots・リダイレクトの事故を防ぐ
- › 画像SEOの確認方法|alt・画像URL・遅延読み込みを確認
- › 求人ページの構造化データを確認|給与・勤務地・期限の不一致
- › サイト内検索ページのSEO確認|noindex・クロール・重複URL
- › サイトリニューアルでSEO評価を落とさない移行方法|URL・301・計測・公開手順
- › サービス終了ページは削除すべき?301・404/410・残す場合のSEO判断基準
- › SEOに強いURL・ディレクトリ設計|階層・命名・変更時の注意点
- › サブディレクトリとサブドメインの違い|SEO・運用の判断基準
- › リッチリザルトとは?種類・構造化データ・表示確認方法を解説
- › Google Search Consoleとは?登録方法と最初に見る4つの指標