大規模なEC・求人・不動産・メディアサイトでは、Googleのクローラー(ページを巡回して内容を取得するプログラム)であるGooglebotが、商品や記事ではなく、絞り込み条件、並べ替え、内部検索、重複URLばかりを取得していることがあります。ただし、クロール数が多いだけでは問題とは判断できません。確認の軸は、サーバーログでGooglebotの実際のリクエストを調べ、クロールさせたいURLの集合と突き合わせることです。
クロールバジェット(Googleがサイトから取得するURL量の目安)がどう使われているかを調べる作業が、クロールバジェット監査です。URL群ごとのリクエスト配分、HTTPステータス、応答時間、更新後の再クロールまでを比較します。
この記事では、まず監査が必要なサイトかを見極め、無駄クロールの発生源を特定し、影響度と修正難易度から着手順を決め、変更後の効果を検証するまでの流れを説明します。
自社サイトにクロールバジェット監査は必要か
最初に決めるのは、そもそも監査に取り組むべきサイトかどうかです。クロールバジェットは、すべてのサイトで優先すべき課題ではありません。
Googleは、主な対象として「重複のないページが100万以上で週次更新」「1万ページ以上で毎日更新」「URLの大部分が『検出-インデックス未登録』」のいずれかに該当するサイトを挙げています。数値は厳密なしきい値ではなく、規模の目安です。
クロールバジェットの意味も押さえておきます。Googleの説明では、クロールバジェットは、Googleがサーバーに負荷をかけずに取得できる量である「クロール能力の上限」と、Googleが取得する必要性を判断する「クロールの必要性」で決まります。そのため、サーバーを高速化してクロール能力の上限を上げても、重複や低価値ページが多く、クロール需要が低ければ、重要ページの取得は増えません。
自社サイトが対象かどうかは、次の表で確認します。
| 確認項目 | 監査の必要性が高い状態 | 主な確認データ |
|---|---|---|
| URL規模と更新量 | 1万URL以上で日次更新、または100万URL以上で週次更新 | CMS・データベース・XMLサイトマップ |
| 未登録URL | 「検出-インデックス未登録」が広いURL群で増えている | Search Console |
| URL増殖 | 絞り込み、並べ替え、検索、セッションIDなどでURLが大量生成される | URL一覧・クロールデータ |
| 発見速度 | 新規・更新ページのクロールが事業上の必要時期に間に合わない | 公開日時・ログの初回取得日時 |
| サーバー状態 | Googlebotへの5xx、429、タイムアウト、応答遅延がある | クロール統計・サーバーログ |
表の項目に当てはまるサイトは、次の節から監査の進め方に入ります。一方、数百ページ程度で、新規ページが速やかにクロールされている場合は、クロールバジェットよりも、コンテンツ品質、内部リンク、インデックス可否の確認を優先します。
監査では何を突き合わせるか|Search Console・サーバーログ・URL台帳
クロールバジェット監査は、1つのツールだけでは完結しません。Search Consoleは、Google側から見た傾向をつかむ入口です。サーバーログは、Googlebotが実際に取得したURLの記録です。URL台帳は、各URLを「クロールさせたいか」で判定する基準として使います。
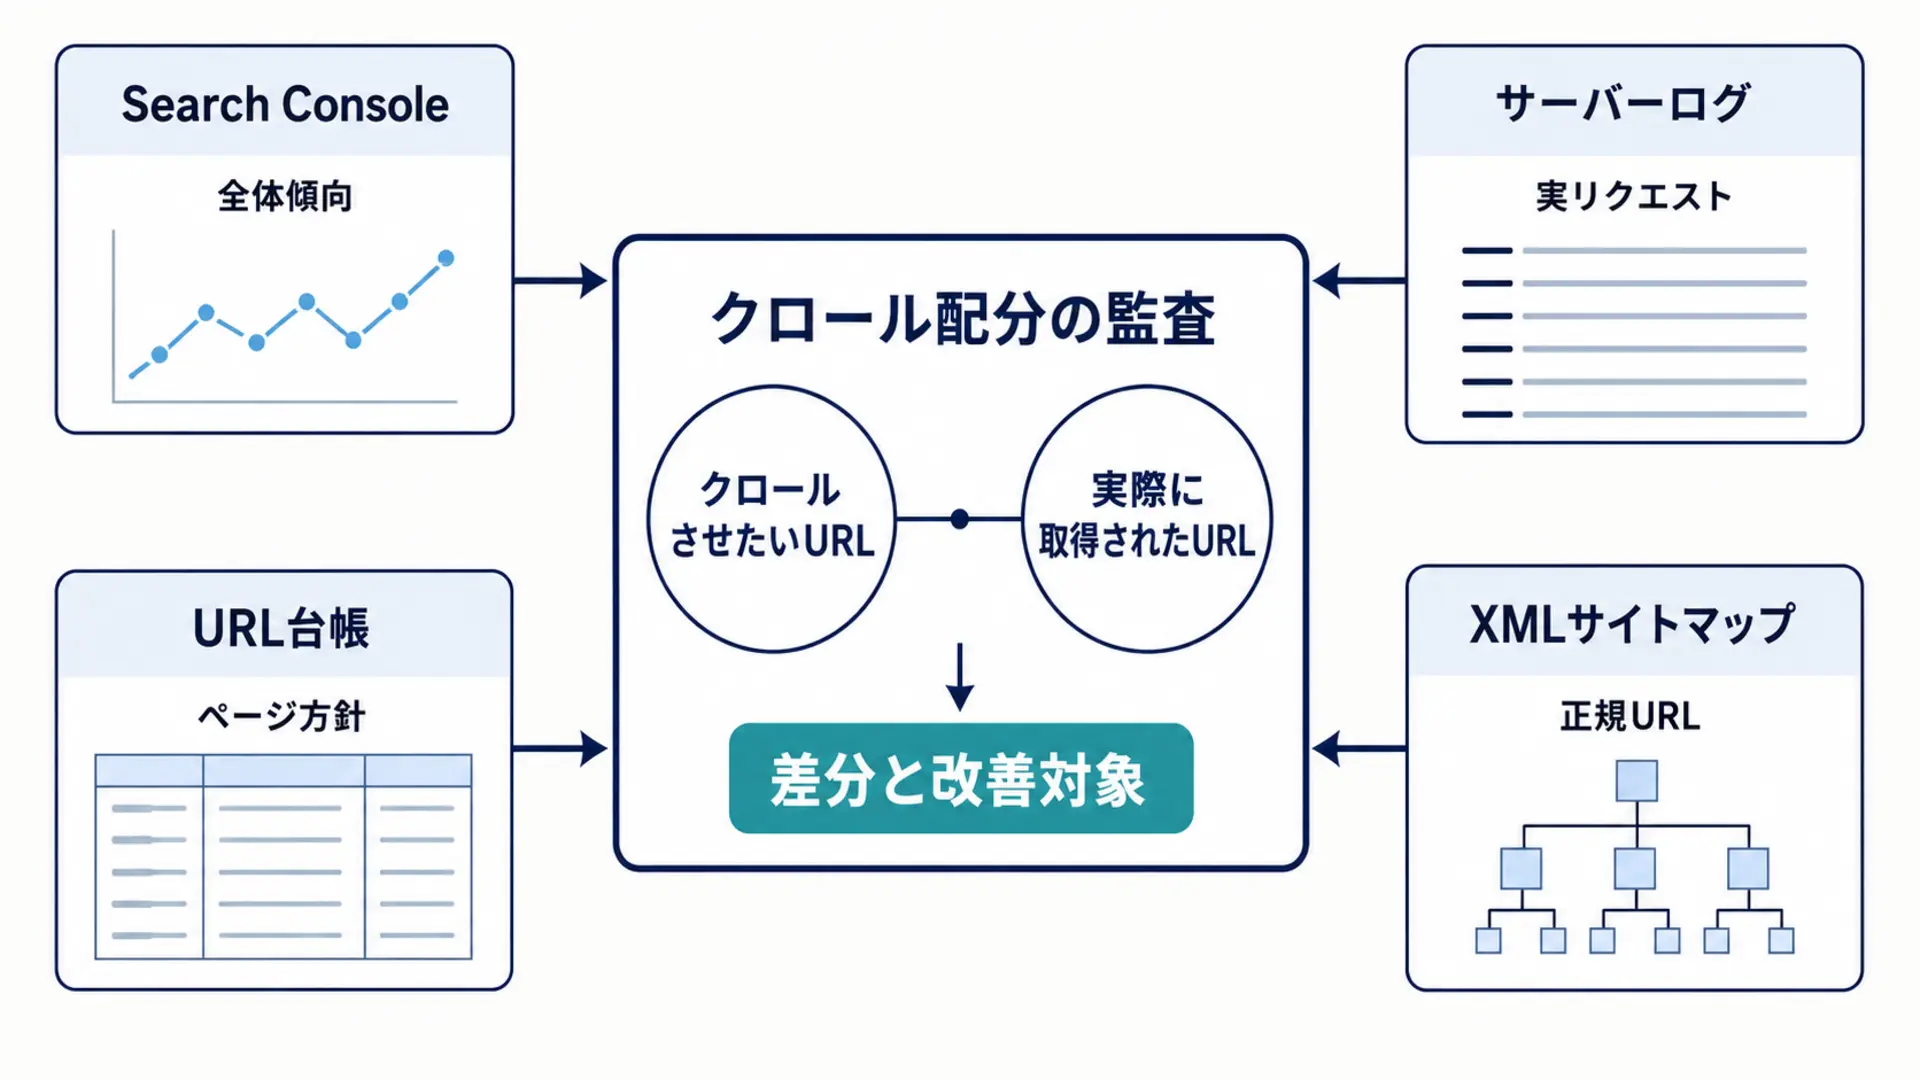
Search Consoleで全体傾向を捉え、サーバーログの実リクエストをURL台帳とサイトマップの方針に照らすことで、改善対象となる差分を特定します。
各データで分かることと分からないことは、次の表のとおりです。
| データ | 分かること | 分からないこと・注意点 |
|---|---|---|
| Search Consoleのクロール統計 | リクエスト総数、応答サイズ、応答時間、ステータス別・目的別の傾向 | 個別URLを完全に一覧化する用途には向かない |
| サーバー/CDNログ | 取得URL、時刻、ユーザーエージェント、IP、HTTPステータス、応答時間 | URLの事業価値や正規URLかどうかは別途付与が必要 |
| URL台帳 | 正規URL、テンプレート、公開状態、インデックス方針、更新頻度 | 実際にGooglebotが取得したかは分からない |
| XMLサイトマップ | クロールさせたい正規URLと最終更新日 | サイト内の不要URLや孤立URLは網羅しない |
| 外部クローラー | 内部リンクから到達できるURL、canonical、robots、ステータス | Googlebotの実行動作そのものではない |
どのデータも、単独ではクロール配分の全体像を示せません。たとえばサーバー/CDNログは取得の事実を示しますが、URLの事業価値や正規URLかどうかは別途付与が必要です。URL台帳は、方針は示しても、実際にGooglebotが取得したかは分かりません。そのため、ログとURL台帳を軸に突き合わせます。
ログの準備として、最低限、日時、リクエストURL、HTTPメソッド、ステータス、応答時間、ユーザーエージェント、接続元IPが必要です。CDNとオリジンサーバーの両方にログがある場合は、二重集計を避けるため、Googlebotへの最終レスポンスを確認できる側を基準にします。
集計の前に、Googlebotのリクエストかどうかも確認します。ユーザーエージェント名だけで判定してはいけません。文字列は偽装できるためです。Googleが公開するIP範囲と照合するか、逆引きと正引きを組み合わせて確認します。逆引き先がgooglebot.com、google.com、googleusercontent.comのいずれかで終わり、正引きで元のIPに戻ることを確認してから、集計対象にします。
STEP1|監査期間とクロールさせたいURL集合を固定する
STEP1では、比較の土台になる監査期間と、URLの分類を決めます。
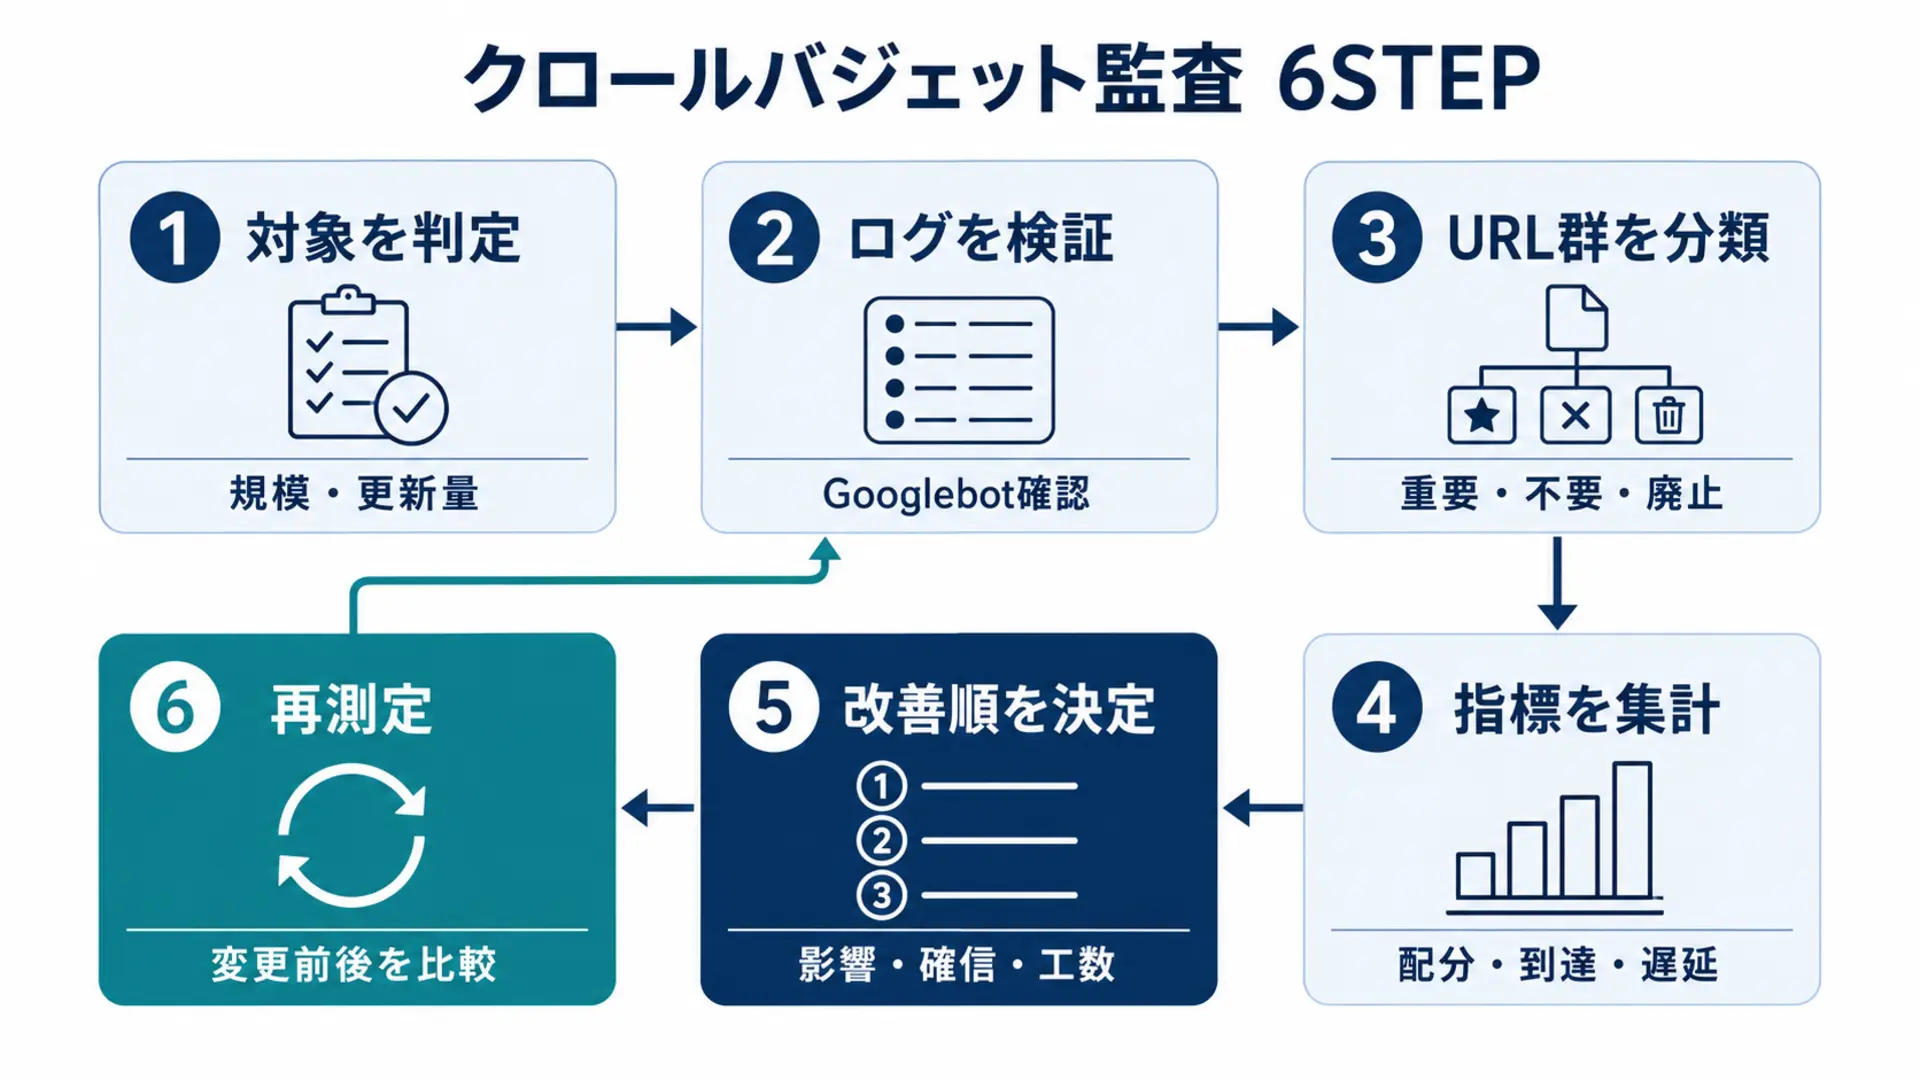
クロールバジェット監査は、対象判定から始め、Googlebotの実ログを基に改善し、同じ条件で再測定する6段階で進めます。この記事では、この流れを前の2節とSTEP1〜5に分けて説明します。
監査期間は、通常は直近28日を起点にします。曜日差や更新サイクルが長い場合は、56日または90日に広げます。サイト移転、障害、大量公開、robots.txt変更があった期間は、平常時と分けて記録します。
次に、URL台帳を用意します。台帳には、少なくとも次の項目を持たせます。
- 正規化後URL
- URLテンプレートまたはディレクトリ
- ページ種別
- HTTPステータス
- canonical指定先
- robots.txtの許可・拒否
- meta robotsの状態
- XMLサイトマップ掲載有無
- インデックスさせたいか
- 更新頻度
- SEOまたは事業上の優先度
URLは「重要URL」「維持URL」「条件付きURL」「不要URL」「廃止URL」の5つに分類すると、ログとの比較が容易になります。この分類が、次のSTEP2でログを集計するときの区分になります。
重要URLは、新商品、募集中求人、主要カテゴリなど、発見や更新反映を急ぐページです。条件付きURLは検索需要のある一部の絞り込みページ、不要URLは並べ替えやトラッキングパラメータ、廃止URLは削除済み商品などを想定します。
STEP2|Googlebotの実ログをURL群別に集計する
STEP2では、確認済みGooglebotのログを、URL群ごとの数字に変えます。確認済みGooglebotのログだけを抽出し、URLを正規化してテンプレート単位にまとめます。クエリパラメータを機械的に削除すると、問題のある組み合わせURLを見失うため、原URLと正規化URLの両方を保持してください。
集計した数字は、次の5つの中心指標で見ます。
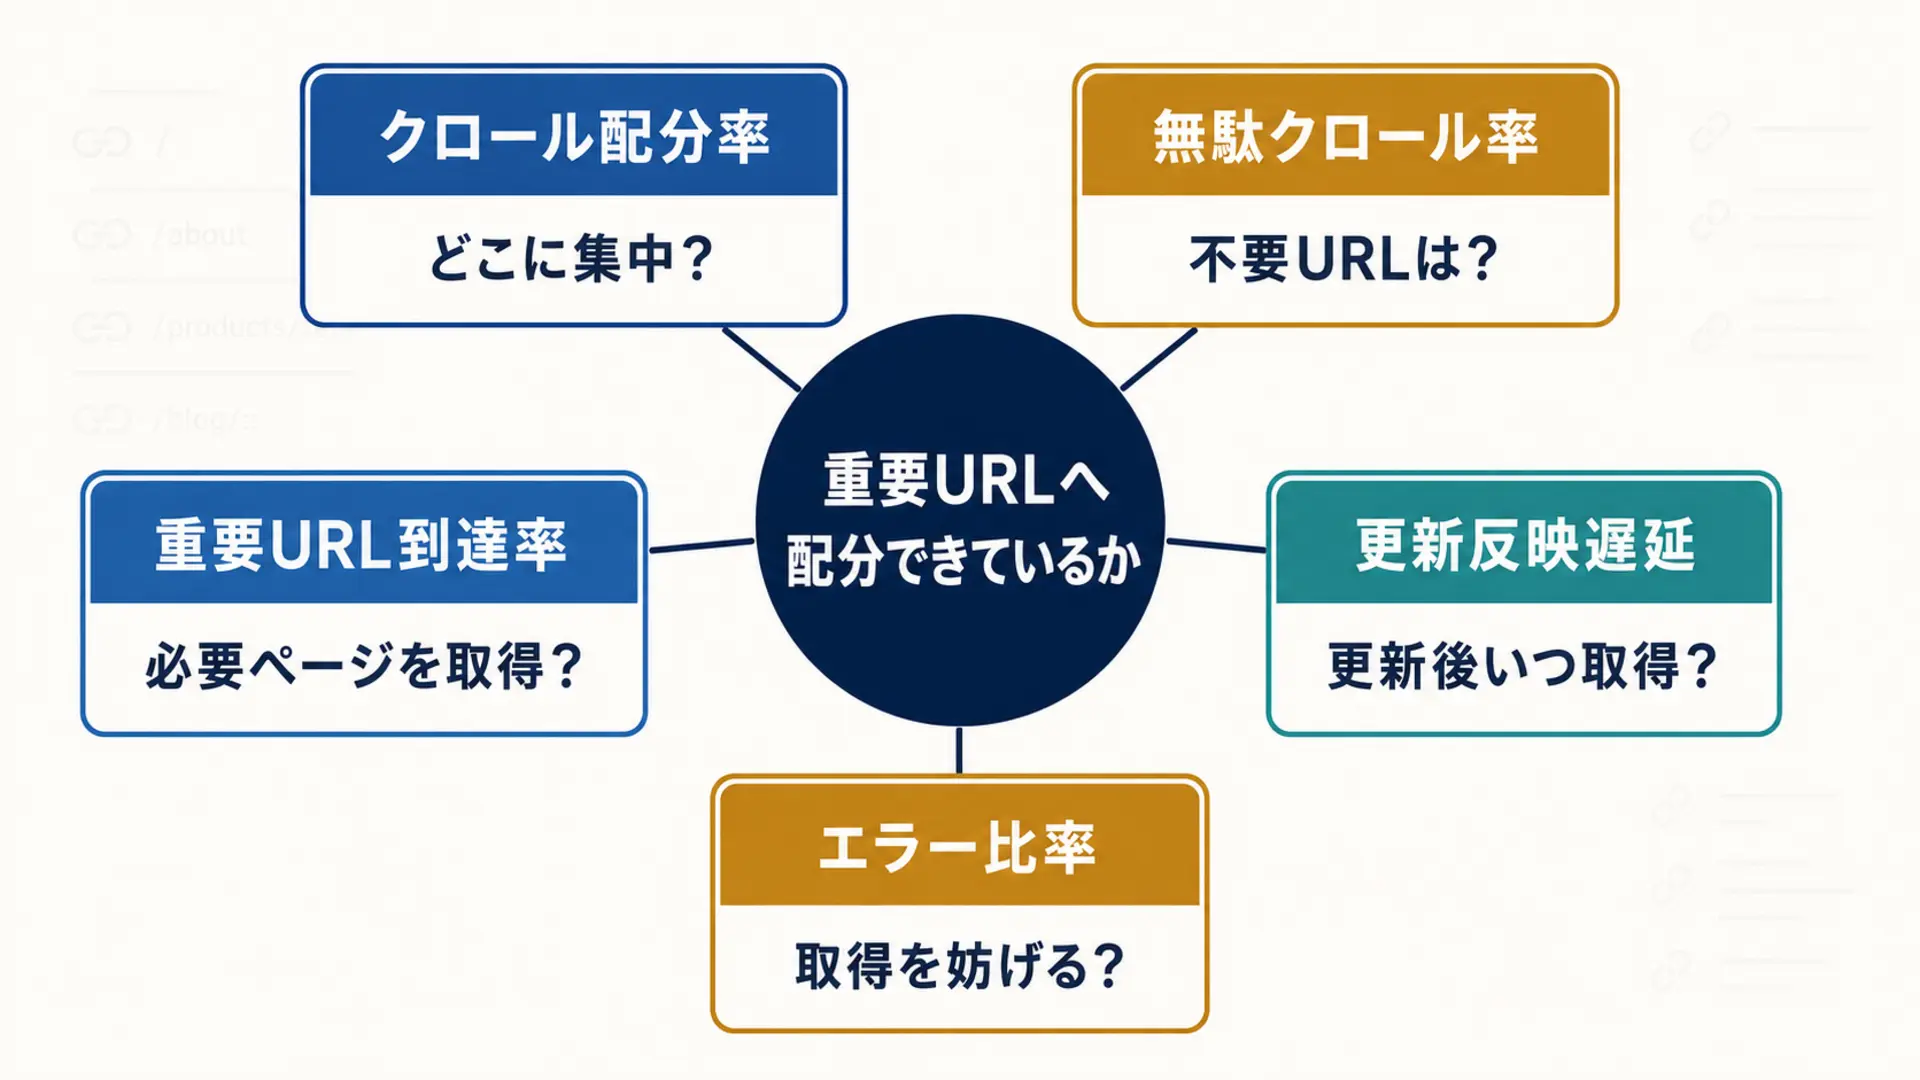
全体のクロール数だけでなく、5つの指標をURL群別に比較すると、重要URLへの配分と改善余地を判断できます。各指標の計算方法と、そこから分かることは次の表のとおりです。
| 指標 | 計算方法 | 判断できること |
|---|---|---|
| クロール配分率 | URL群のGooglebotリクエスト数 ÷ 全Googlebotリクエスト数 | どのURL群に取得が集中しているか |
| 無駄クロール率 | 不要・廃止URLへのリクエスト数 ÷ 全Googlebotリクエスト数 | 改善余地の大きさ |
| 重要URL到達率 | 期間中に1回以上取得された重要URL数 ÷ 重要URL総数 | 優先URLがカバーされているか |
| 更新反映遅延 | 更新日時から次回Googlebot取得日時までの時間 | 更新ページの再取得速度 |
| エラー比率 | 5xx・429等のリクエスト数 ÷ 全Googlebotリクエスト数 | クロール能力を下げる技術問題 |
たとえば、28日間に確認済みGooglebotのリクエストが120万件あり、不要URLへのリクエストが36万件なら、無駄クロール率は30%です。この値は業界基準ではなく、そのサイト内で改善前後を比較するための値です。単独で判断せず、重要URL到達率や更新反映遅延と一緒に見て、不要URLへの集中が重要URLの遅れと同時に起きているかを確認します。
STEP3|無駄クロールを原因別に分類する
STEP3では、無駄クロールを原因ごとに分け、原因に合った対応を決めます。無駄なURLを一括して処理すると、検索需要のあるページまで消す危険があります。発生原因、検索価値、現在のインデックス状態を分けて判定します。ここでは、原因を4つに分けて確認します。
パラメータ・ファセットURLが増えすぎていないか
ファセットは、色、サイズ、価格などの絞り込み条件のことです。
色、サイズ、地域、価格、並べ替えなどの組み合わせは、URL空間を急速に増やします。Googleは、ファセットナビゲーションが事実上無限のURLを作り、新しい有用なURLの発見を遅らせる可能性を説明しています。一方、地域×職種など検索需要を持つ組み合わせもあるため、すべてをブロックするのではなく、インデックス対象と非対象をルール化します。
重複URL・canonical不整合はないか
HTTP/HTTPS、www有無、末尾スラッシュ、大小文字、トラッキングパラメータなどで、同じ内容が複数URLに分かれていないか確認します。canonicalは統合のシグナルですが、不要URLを大量に生成し続けてよいという意味ではありません。内部リンク、サイトマップ、リダイレクト、canonicalの向きをそろえます。
削除URL・soft 404・リダイレクトチェーンは残っていないか
完全に削除したURLは、404または410を返します。内容がないのに200を返すsoft 404は修正対象です。移転先がある場合は、最終URLへ直接301を返し、AからB、BからCのような連鎖を解消します。404をゼロにするために、無関係なトップページへ一律転送する運用は避けてください。
サーバーエラー・レート制限・応答遅延は出ていないか
Googleの公式情報では、応答遅延、5xx、HTTP 429などが増えると、クロール能力の上限が下がる可能性があります。そのため、URL群別、時間帯別、ホスト別にエラーと応答時間を集計し、アプリケーション、CDN、データベース、WAFのどこで発生しているかを切り分けます。
STEP4|影響度・確信度・工数で改善優先度を決める
STEP4では、原因ごとの対応をどの順に進めるかを決めます。改善順は、リクエスト件数だけでは決めません。「重要URLへの影響」「原因判定の確信度」「修正工数」「誤って必要URLを止めるリスク」を合わせて評価します。
実務では、次の式で優先度スコアを付けると、判断を共有しやすくなります。
優先度スコア = 影響度(1~5)× 確信度(1~5)÷ 工数(1~5)
影響度には、無駄リクエスト数だけでなく、重要URL到達率、更新反映遅延、エラー率への寄与を含めます。この式はGoogleの指標ではなく、社内の着手順を決めるための管理方法です。式に入らない「誤って必要URLを止めるリスク」は、スコアとは別に、実施前に確認します。
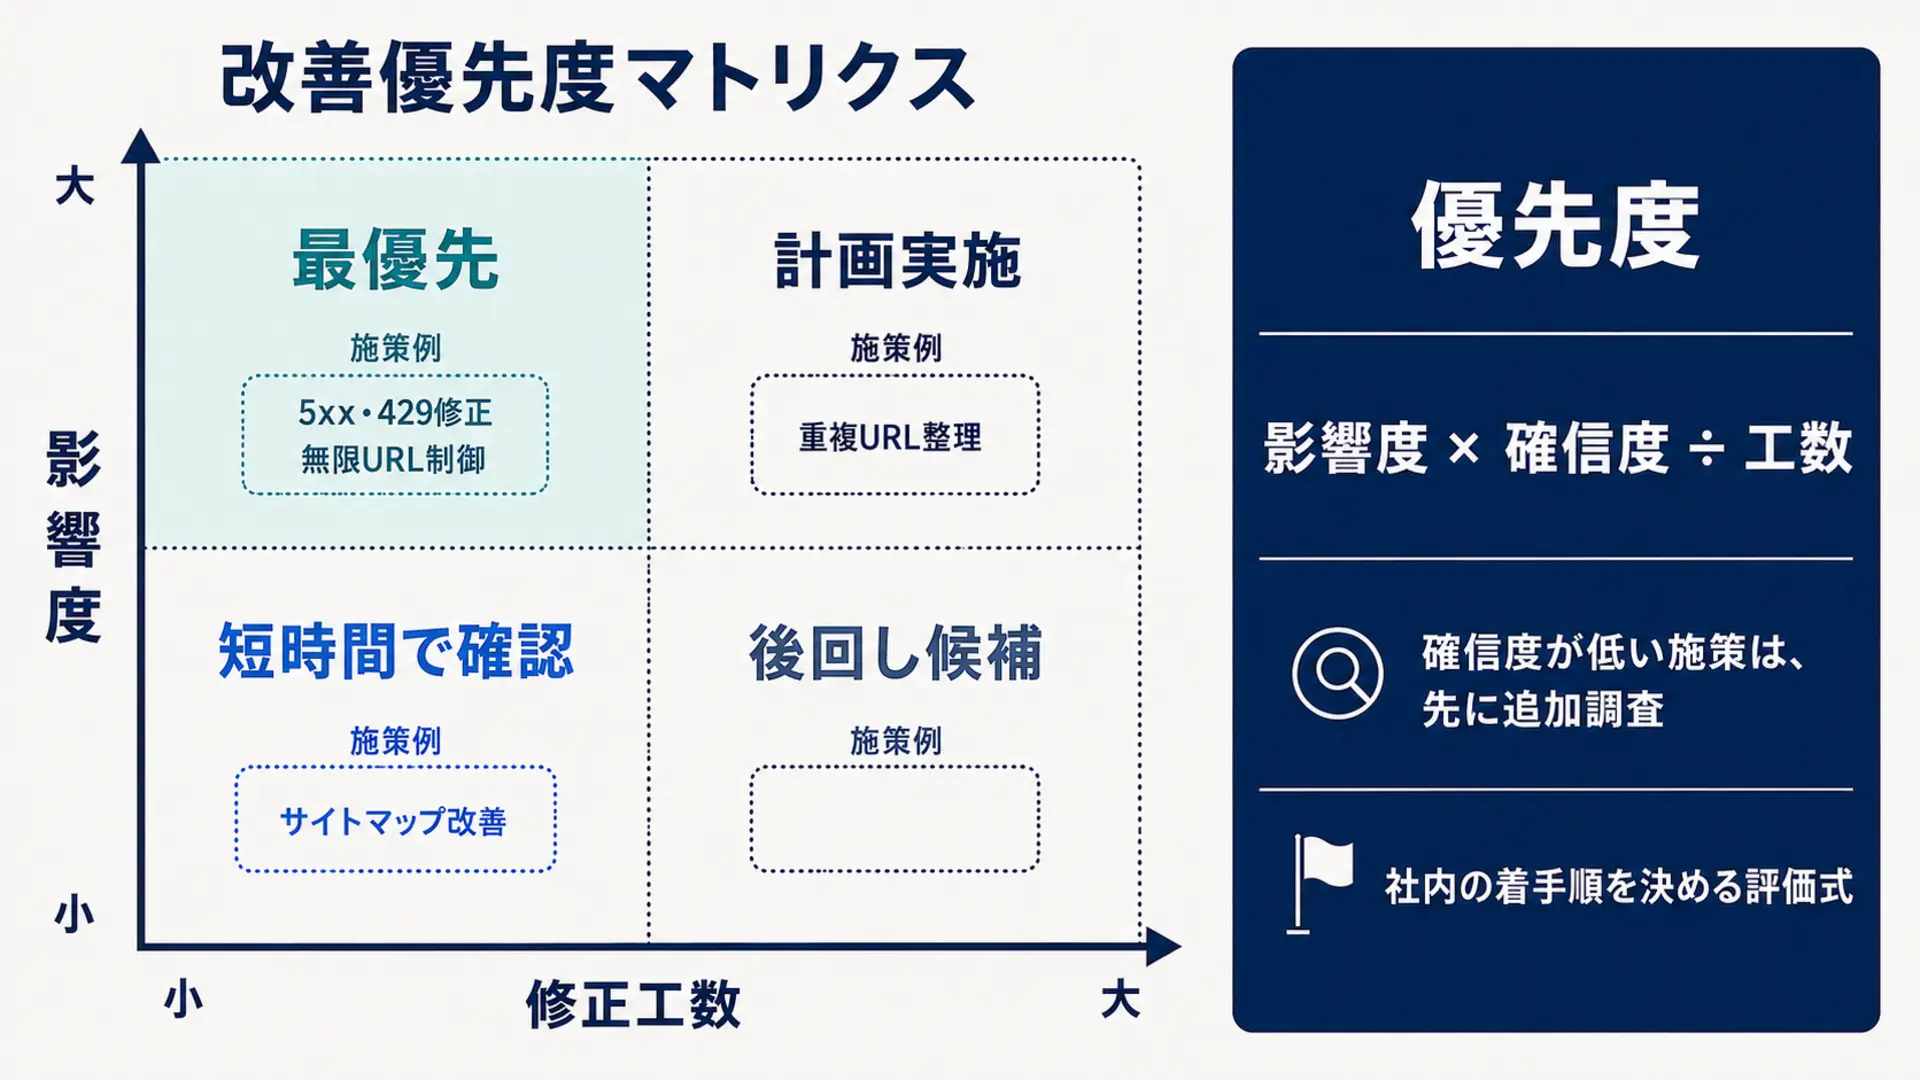
影響度が大きく、原因判定の確信度が高く、修正工数が小さい施策から優先します。
代表的な問題ごとの主な修正、優先度を上げる条件、変更時の注意は、次の表のとおりです。
| 問題 | 主な修正 | 優先度を上げる条件 | 変更時の注意 |
|---|---|---|---|
| 5xx・429・大幅な遅延 | 容量、キャッシュ、WAF、アプリケーションを修正 | 重要URLにも発生し、クロール量が低下 | 障害対応として最優先 |
| 無限に増える不要ファセット | URL生成制御、内部リンク整理、必要に応じrobots.txt | リクエスト比率が高く、検索価値がない | 既存インデックス削除は別手順が必要 |
| 重複URL | リダイレクト、canonical、内部リンク、サイトマップ統一 | 多数の重複へ継続的にクロール | canonicalだけに依存しない |
| 削除済みURL・soft 404 | 404/410、または適切な移転先へ301 | 200応答の空ページが大量にある | 関連性のない一律転送を避ける |
| 更新ページの発見遅延 | 内部リンク、サイトマップ、正確なlastmodを修正 | 事業上重要な更新が間に合わない | lastmodは実質変更時だけ更新 |
| 応答ボディの再取得 | HTTPキャッシュと304対応を確認 | 未変更ページの取得負荷が大きい | キャッシュ整合性を検証 |
表のうち、5xx・429・大幅な遅延は障害対応として最優先です。それ以外の問題は、「優先度を上げる条件」に当てはまるかと優先度スコアを見て、着手順を決めます。
修正手段を選ぶときは、noindexとrobots.txtの性質に注意してください。noindexは、クロール停止の即効策ではありません。Googleは指定を読むためにURLへアクセスする必要があるためです。また、robots.txtはクロールを止める仕組みであり、すでに登録されたURLを確実に検索結果から消す仕組みではありません。目的に応じて、URL生成停止、404/410、301、canonical、noindex、robots.txtを使い分けます。
STEP5|修正後はクロール量ではなく配分の変化を検証する
STEP5では、修正が効いたかを確かめます。修正後の成功は、全体のクロール数が増えたかではなく、重要URLへ配分が移り、更新反映が速くなり、サーバーエラーが減ったかで判断します。robots.txtで不要URLを止めても、サイトがクロール能力の上限に達していなければ、空いた分が他URLへ自動的に再配分されるとは限りません。
変更日を記録し、変更前後で同じ長さの期間を比較します。大規模変更は、ディレクトリやテンプレート単位で段階的に実施すると、原因と効果を追いやすくなります。比較では、次の6点を確認します。
- 不要URL群のクロール配分率が低下したか
- 重要URL到達率が上昇したか
- 新規・更新URLの取得遅延が短くなったか
- 5xx、429、タイムアウトが減ったか
- 正規URLとサイトマップ掲載URLへのクロールが増えたか
- 検索流入やインデックス対象URLに悪影響がないか
改善が見られない場合は、Googleが別経路から不要URLを発見していないか、URL分類が粗すぎないか、重要URL自体の品質・内部リンク・更新価値に問題がないかを再確認します。
クロールバジェット監査で避けたい5つの判断ミス
ここまでの内容に沿って、避けたい判断ミスを5つに整理します。
- 小規模サイトで監査を最優先する:対象外のサイトでは、インデックス阻害、内部リンク、コンテンツ品質を先に確認します。
- ユーザーエージェントだけでGooglebotを判定する:IPを確認しない集計は、偽装ボットによって歪む可能性があります。
- クロール数の増加を成功指標にする:クロール数が増えても、順位や登録が直接保証されるわけではありません。重要URLへの配分と反映速度を見ます。
- 不要URLをすべて同じ方法で処理する:削除、重複、インデックス不要、クロール不要では適切な制御が異なります。
- 修正後にログを再取得しない:設定変更だけで完了にせず、実リクエストの変化を確認します。
まとめ|最初の一歩は対象サイトかどうかの確認
クロールバジェット監査の目的は、クロール数をむやみに増やすことではなく、Googlebotの限られた取得を事業上重要なURLへ向けることです。そのために、まず対象サイトかを見極め、確認済みGooglebotのログとURL台帳を突き合わせます。そのうえで、無駄クロール率、重要URL到達率、更新反映遅延、エラー比率をURL群別に比較してください。
改善は、サーバー障害、無限URL、重複、soft 404、発見経路の順に、影響度と工数を見ながら進めます。変更後は同じ条件でログを再集計し、重要URLへの配分と取得速度が改善したことまで確認して、監査を完了します。
最初の一歩は、自社サイトが監査の対象かどうかを確かめることです。対象であれば、直近28日分のGooglebotのログとURL台帳をそろえるところから始めましょう。
このテーマの全体像や前提を確認したい場合は、「テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト」もあわせて確認してください。
参考文献・データ元
この記事で参照した情報を確認できます。
- 「クロール バジェットを最適化する」Google Crawling Infrastructure、最終更新2026年8月4日。クロールバジェットの対象、定義、URL群管理、HTTPステータス、キャッシュに関する根拠として使用。
- 「ファセット ナビゲーション URL のクロールを管理する」Google Search Central。ファセットURLが過剰なURL空間を生む問題と管理方針の根拠として使用。
- 「Google クローラーとフェッチャーからのリクエストを確認する」Google Crawling Infrastructure。GooglebotのIP範囲およびDNSによる確認方法の根拠として使用。
- 「クロールの統計情報レポート」Google Search Console ヘルプ。クロールリクエスト、応答、目的、ホスト状態の確認項目として使用。
- 「サイトマップを作成して送信する」Google Search Central。正規URLとlastmodを含むサイトマップ運用の根拠として使用。
‹ 親記事: テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト
関連記事
- › INDEX削除(インデックス削除)とは?検索結果から消える仕組みと対処法
- › Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け
- › SEO内部リンクの確認方法|孤立ページ・深度・アンカー偏りを改善
- › ページがインデックスされない原因は?Search Consoleで未登録・除外・重複URLを確認
- › JavaScript SEOの確認方法|表示・内部リンク・登録状況
- › 構造化データの確認方法|エラー・本文との不一致・重複を検証
- › 多言語ページの言語・地域指定を確認|相互参照・正規URLをチェック
- › 絞り込み検索のSEO確認方法|URL増加・クロール・重複を防ぐ
- › SEOリダイレクトの確認方法|多段転送・ループ・誤転送を検出
- › robots設定のSEO確認方法|クロール許可と登録制御の矛盾を確認
- › ページネーションのSEO確認方法|正規URL・内部リンク・クロール
- › サイト移行後のSEO確認方法|転送・正規URL・順位変動を確認
- › 404・soft 404のSEO確認|リンク切れ・消失URLを修正
- › SEOリリース前チェックの作り方|noindex・canonical・robots・リダイレクトの事故を防ぐ
- › 画像SEOの確認方法|alt・画像URL・遅延読み込みを確認
- › 求人ページの構造化データを確認|給与・勤務地・期限の不一致
- › サイト内検索ページのSEO確認|noindex・クロール・重複URL
- › サイトリニューアルでSEO評価を落とさない移行方法|URL・301・計測・公開手順
- › サービス終了ページは削除すべき?301・404/410・残す場合のSEO判断基準
- › SEOに強いURL・ディレクトリ設計|階層・命名・変更時の注意点
- › サブディレクトリとサブドメインの違い|SEO・運用の判断基準
- › リッチリザルトとは?種類・構造化データ・表示確認方法を解説
- › Google Search Consoleとは?登録方法と最初に見る4つの指標