ECサイトや求人、不動産、比較サイトなどでは、ブランドや価格、地域、職種といった条件でユーザーが商品や情報を絞り込めます。この仕組みを、この記事ではファセットナビゲーションと呼びます。条件を選ぶたびにURLが増えるため、SEOの面でも確認が欠かせません。
問題は「URLが多いこと」そのものではありません。検索価値のないURLまで、検索エンジンが発見し、巡回してページ内容を取得(クロール)できる状態になっていることです。
そこでファセットナビゲーションのSEO監査では、すべての絞り込みURLを一律に閉じるのではなく、URLごとに扱いを決めます。分け方は次の4つです。
- 検索結果に残すURL
- 検索エンジンへの登録(インデックス)だけを防ぐURL
- クロール自体を抑えるURL
- 別URLへ正規化するURL
この記事は、マーケティング担当者が開発担当者と相談できる水準を目指しています。URLの棚卸し、検索価値の判定、クロール経路の確認、index・noindex・canonical・robots.txtの使い分けを、7つのステップで順に整理します。
関連する全体像や前提は「テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト」で整理しています。
ファセットナビゲーションの監査は「URLを減らす」より「URLの役割を決める」ことから始める
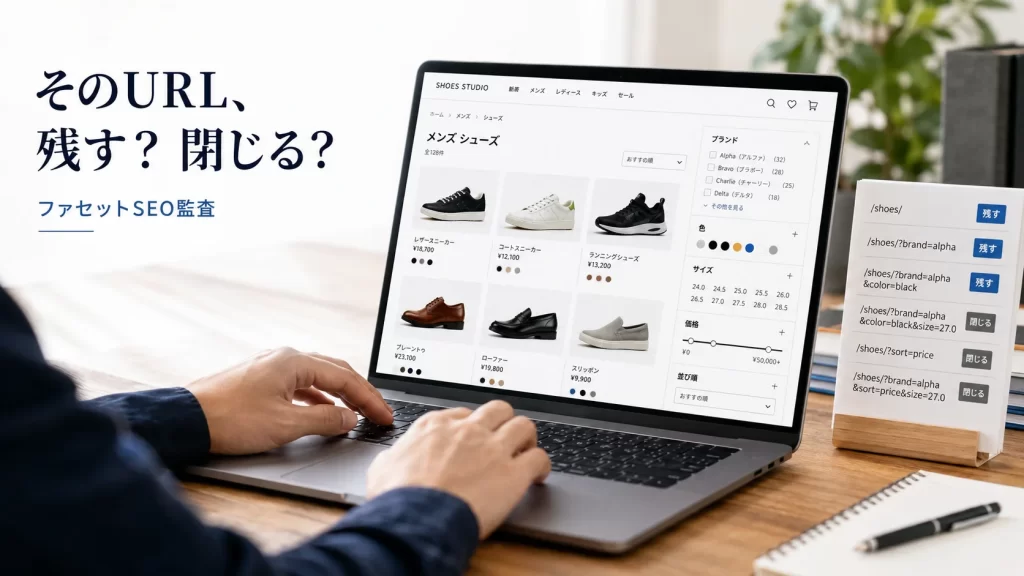
最初に、絞り込みでURLがどう増えるかを確認します。たとえば靴のカテゴリで、次のようなURLが生成されるサイトを考えます。
/shoes//shoes/?brand=a/shoes/?brand=a&color=black/shoes/?brand=a&color=black&size=27/shoes/?brand=a&color=black&size=27&sort=price
条件を増やすほど、URLの組み合わせも増えていきます。
Googleは、ファセットナビゲーションが非常に大きなURL空間を作り、不要なURLへの過剰なクロールや、重要な新規URLの発見速度低下につながる場合があると説明しています。検索結果に表示させる必要がないファセットURLについては、クロールを防ぐことも選択肢として案内しています。
ただし、絞り込みURLのすべてが不要なわけではありません。絞り込み条件そのものが検索ユーザーの需要を表しているページもあります。たとえば、次のような検索です。
- 「黒 ランニングシューズ」
- 「東京 エンジニア 求人」
- 「新宿 1LDK 賃貸」
こうした条件のURLまで一律に消すと、検索から訪れる入口を自分で減らすことになりかねません。したがって、監査の目的は「パラメータURLを全部消すこと」ではありません。
各URLを検索価値と技術的な役割から分類し、Googleに発見・クロール・インデックスしてほしい範囲を明確にすることが目的です。次の節で、その分類の基準を決めます。
ファセットURLは4種類に分けて、扱いを決める
ファセットURLの監査では、最初にURLごとの扱いを決めます。分類の軸は、検索価値とURLの役割です。
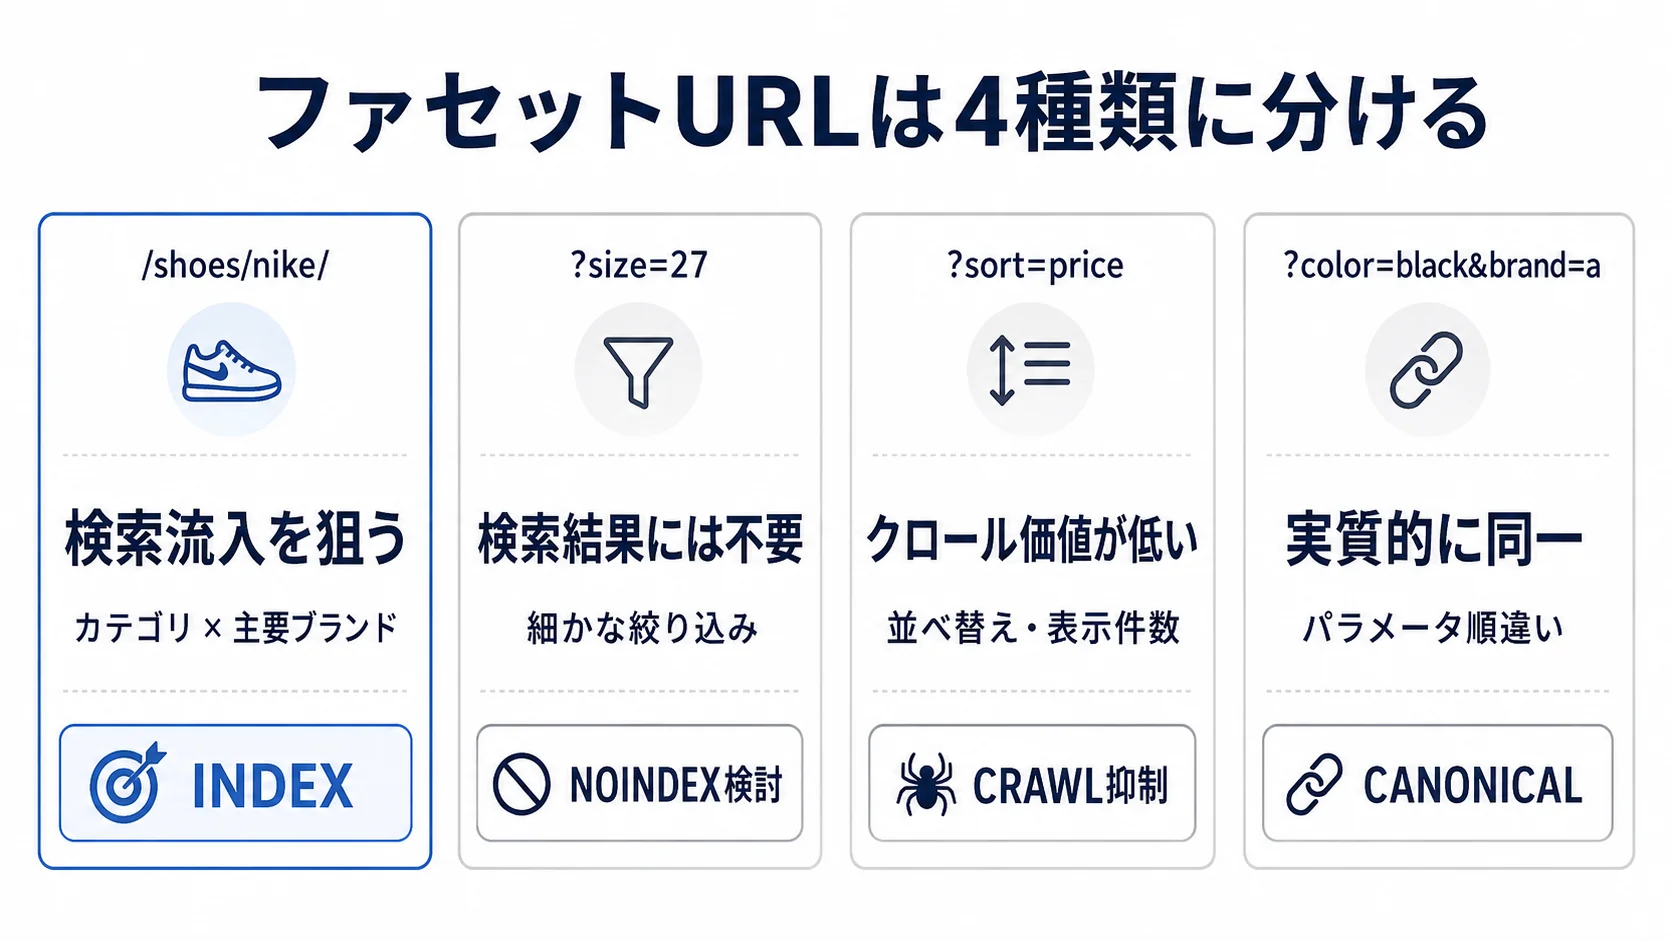
ファセットURLは一律に処理せず、検索価値とURLの役割によって、index・noindex・クロール制御・canonicalのどれで扱うかを分けます。4種類の典型例と基本方針は、次の表のとおりです。
| 分類 | 典型例 | 基本方針 |
|---|---|---|
| 検索流入を狙う | カテゴリ×主要ブランド、地域×職種 | index可能・自己canonical |
| UXには必要だが検索結果には不要 | 細かな条件による絞り込み | noindex等を検討 |
| クロール自体の価値が低い | 並べ替え、表示件数変更、無限の条件組み合わせ | URL生成・内部リンク・robots.txt等で制御 |
| 実質的に別URLと同一 | パラメータ順だけ異なるURLなど | URL統一・canonical等で正規化 |
この表を使うときに気をつけたいのは、index / noindexだけで判定しないことです。「Googleに検索結果として残すか」と、「GoogleのクローラーであるGooglebotにクロールさせるか」は別の問題だからです。この違いは、STEP5で使い分けの基準として整理します。
STEP1:どの操作でURLが増えているかを棚卸しする
最初に、サイト内でURLを増やしている条件を一覧にします。最低限、次の項目を確認してください。右の列は、ブランドの絞り込みを例にした記入例です。
| 確認項目 | 例 |
|---|---|
| ファセット名 | ブランド |
| URL表現 | ?brand= |
| 選択肢数 | 30 |
| 複数選択 | 可 |
| 商品・情報内容が変化するか | 変わる |
| 検索需要が想定されるか | あり |
| 内部リンクが生成されるか | あり |
| sitemap掲載 | なし |
| canonical | 自URL |
| robots指定 | index |
この一覧で特に分けたいのが、絞り込みと並べ替えです。たとえば?brand=nikeでは、表示される商品の集合が変わります。一方、?sort=price_ascでは、商品そのものは同じで表示順だけが変わるケースがあります。
Googleのcanonicalに関する資料でも、カテゴリページのソートやフィルタリング機能は、重複URLが生まれる代表例として挙げられています。同じパラメータ付きURLでも役割が異なるため、最初の棚卸しで区別しておきます。そうすれば、後のSTEPで扱いを分けられます。
STEP2:Googleが実際にたどれるURLはいくつあるかを確認する
次に確認するのは、理論上作れるURLの数ではなく、Googleが実際に到達できるURLの数です。ファセットが10種類あったからといって、生成可能なすべての組み合わせをGooglebotがクロールするとは限りません。
SEO監査でより重要なのは、実際に内部リンクなどから発見できるURLがどれだけあるかです。Googleはサイト構造を理解する際、URLのディレクトリ形状だけでなく、ページ同士のリンク関係を利用すると説明しています。重要なカテゴリや商品へ適切にリンクすることも推奨されています。
つまり、ファセット監査ではタグ設定だけを見るのではなく、「どのURLへのリンクをHTML上に出しているか」まで確認する必要があります。確認する経路は次の4つです。
- カテゴリ一覧から出ているファセットリンク
- ファセット適用後のページからさらに出ているリンク
- XMLサイトマップに含まれるURL
- 外部サイトなどから直接リンクされているURL
4つの経路をたどって見つかったURLが、STEP3以降で扱いを決める対象になります。
STEP3:検索結果に残す価値のある絞り込みURLを選ぶ
見つかったURLのうち、検索結果へ残す価値があるものを選別します。判断軸は、単純な検索ボリュームだけではありません。次の6つを確認します。
| 判断軸 | 確認する内容 |
|---|---|
| 検索需要 | 条件を含む検索が実際に存在するか |
| 検索意図 | 親カテゴリとは異なる目的があるか |
| 結果の充実度 | 条件を適用して十分な商品・情報が残るか |
| 内容の独自性 | 親カテゴリと明確に異なる一覧になるか |
| 継続性 | 一時的ではなく安定して成立する条件か |
| 事業価値 | 流入後に購入・応募・問い合わせ等へつながるか |
たとえば「スニーカー」というカテゴリに対して、「黒いスニーカー」を探す需要があり、十分な商品件数が存在するなら、検索ランディングページとして成立する可能性があります。
一方、「黒・27cm・在庫あり・30%OFF・価格の安い順」のような条件は、ユーザー操作には便利でも、独立した検索ページとして育成する価値が低い場合があります。前者は昇格の候補、後者は昇格させない候補、という判断です。
分かれ目は、条件の数ではありません。条件数で機械的に決めないことが大切です。判断軸を総合すると、検索需要・ページ内容・事業価値の3点がそろった組み合わせだけを検索対象へ昇格させると管理しやすくなります。
STEP4:同じ条件のURLが複数できていないかを確認する
続いて、同じ条件なのに複数のURLが成立していないかを調べます。たとえば?brand=a&color=blackと?color=black&brand=aが同一内容を返す場合、パラメータの順序が違うだけで別URLになります。
ほかにも、次のようなものがURL数を増やします。
- 空パラメータ
- デフォルト値
- 大文字・小文字
- 不要なトラッキングパラメータ
- 同じ条件を重複指定したURL
- 意味のない条件組み合わせ
Googleは、ファセットURLをクロール可能にする場合、一般的な&によるパラメータ区切りを利用し、パス内で条件を表す場合は順序を一定にし、重複条件や意味のない組み合わせを避けるよう案内しています。
URL生成側で統一できる問題は、canonicalだけに任せないでください。canonicalではクロール量そのものは減らないため(STEP5で説明します)、そもそも複数URLを生成しない設計を優先します。
STEP5:canonical・noindex・robots.txtを目的ごとに使い分ける
ファセットナビゲーションで特に間違えやすいのが、各制御方法の使い分けです。次の表は、5つの方法がクロールとインデックスにどう関わるかをまとめたものです。
| 方法 | 主な目的 | クロール | インデックス |
|---|---|---|---|
| 自己canonical | 独立ページとして扱わせる | される | 候補になる |
| 別URLへのcanonical | 重複URLの代表URLを示す | される | canonical側へ集約を促す |
noindex | 検索結果へ出さない | 必要 | 防ぐ |
| robots.txt | クロールさせない | 防ぐ | インデックス削除手段ではない |
| URLをリンクとして生成しない | 発見経路を減らす | 抑制できる | 状況による |
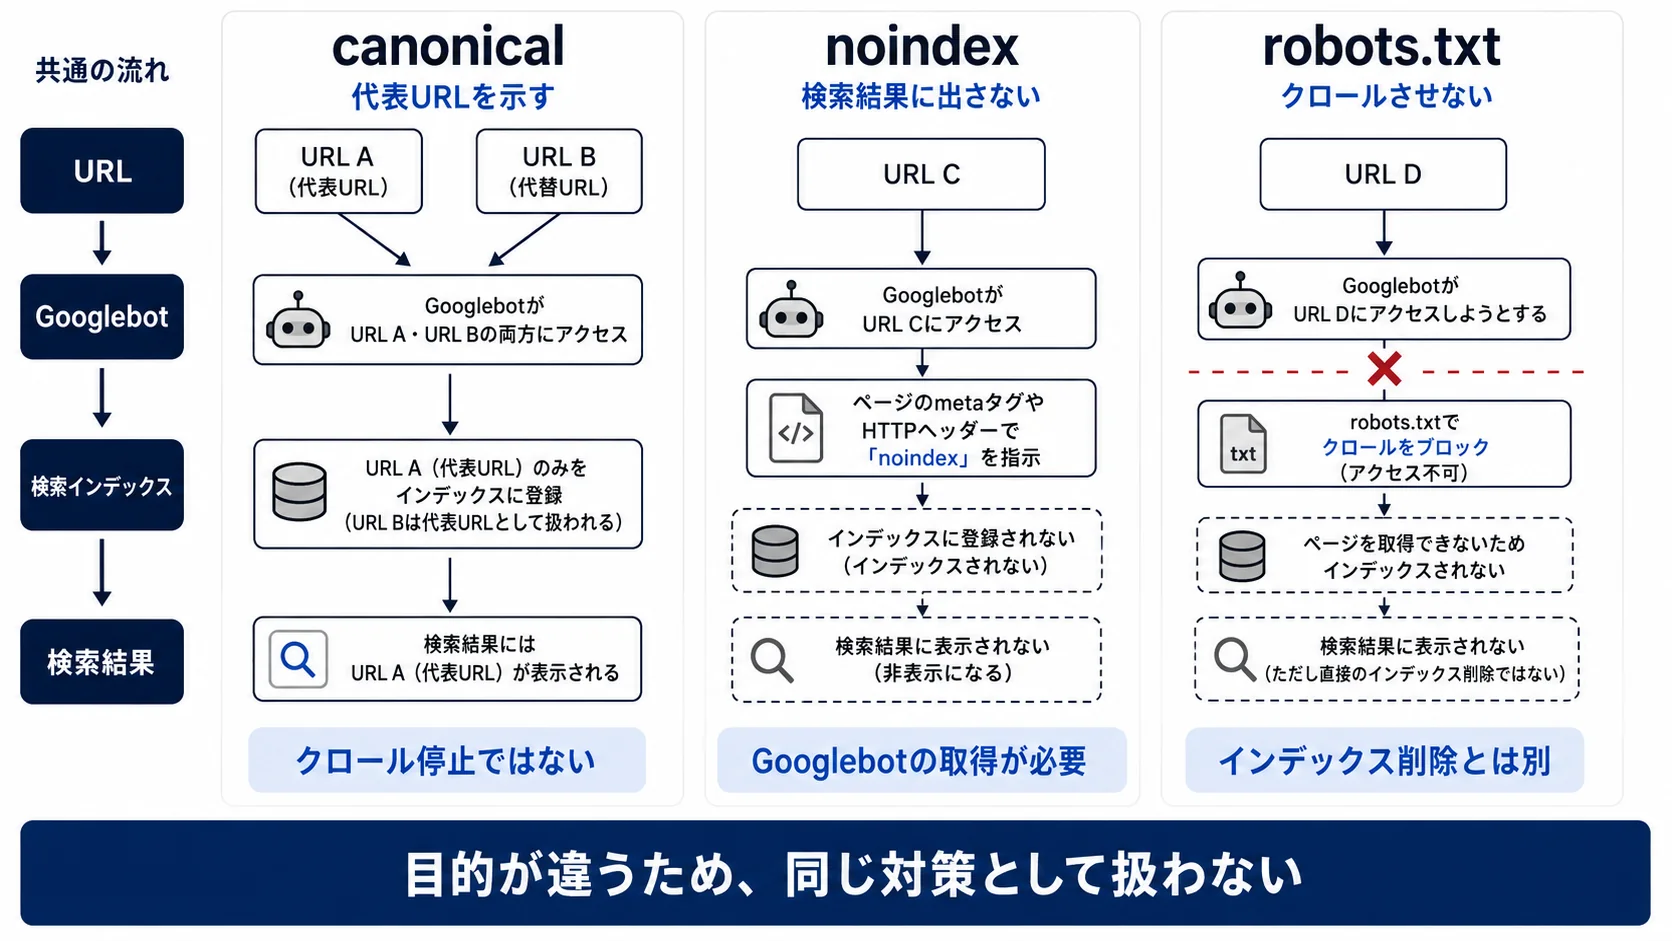
表と図の要点は3つに絞れます。canonicalは代表URLの指定、noindexは検索結果への掲載防止、robots.txtはクロール制御です。どれも目的が違うため、目的を分けて設計する必要があります。以下では、混同しやすい3つを順に見ていきます。
canonicalはクロールを止める手段ではない
rel="canonical"は、重複または非常に似たページ群から代表URLをGoogleへ伝える手段です。Googleはcanonical指定を重要なシグナルとして利用しますが、最終的なcanonical URLをGoogle側が別に選ぶ場合もあります。
そのため、「大量のファセットURLをcanonicalで親ページへ向ければクロール問題も解決する」とは限りません。ファセットURLのクロール量そのものを抑えたい場合は、別の制御も検討します。
noindexを使うには、Googlebotがページを取得できる必要がある
noindexは、ページをGoogle検索に表示させないための指定です。ただしGoogleは、noindexを認識するためにページをクロールする必要があります。
robots.txtでそのURLをブロックしている場合、Googlebotはページ内のnoindexを確認できません。Googleも、noindexを機能させるにはrobots.txtでページをブロックしないよう案内しています。すでにGoogleに認識されているURLを検索結果から外したい場合は、robots.txtのブロックがnoindexの読み取りを妨げないよう、設定の順序に注意します。
robots.txtはクロールが不要なURLに使う
Googleは、検索対象とする必要がないファセットURLについて、robots.txtによるクロール制御を選択肢として明示しています。また、クロールバジェットの公式資料でも、並べ替えなど重要性の低いURLについて、必要に応じてrobots.txtでクロールを防ぐ方法を説明しています。noindexでは一度取得する必要があるため、クロール時間の節約を目的とする場合には適していません。
ただし、robots.txtは「Google検索から確実に消すための指定」ではありません。クロールを止めたいのか、検索結果から外したいのか。この2つを混同しないよう、目的に合う手段を選びます。
STEP6:0件ページや成立しない条件のURLを確認する
ファセットの組み合わせによって、商品や情報が0件になるURLも監査の対象です。Googleは、ファセットURLをクロール可能にする場合、結果が存在しない条件や意味のない組み合わせでは404を返すことを推奨しています。空結果を共通のエラーページへリダイレクトするのではなく、そのURL自体で適切なステータスを返す考え方です。
たとえば、次のような組み合わせです。
「ブランドA × 存在しないサイズ」
このように恒常的に成立しない組み合わせであれば、通常の商品一覧ページとして200(正常表示)を返し続ける必要性を見直します。
ただし、在庫切れなど一時的に結果が0件になるページは、恒久的に成立しないURLと分けて判断してください。
STEP7:Search Consoleとクロールデータで実際の状態を確認する
ここまでの設定を確認したら、最後に、Googleが実際にどう認識しているかを確かめます。主な確認項目は次の7つです。
- Googleが選択したcanonical
- ページのインデックス状況
- クロール済み・未登録URLの傾向
- robots.txtによるブロック状況
noindexの検出状況- ファセットURLへのクロール増加
- 本来検索対象にしたいURLの発見状況
canonicalは、指定すれば必ず採用されるわけではありません。GoogleもURL検査を使ってGoogleが選択したcanonicalを確認するよう案内しています。
大規模サイトでは、可能であればサーバーログやクローラーツールも使い、「設定したルール」ではなく「実際にGooglebotがどこをクロールしているか」まで確認します。そうすると、不要なURLパターンを特定しやすくなります。
検索価値とクロール負荷の4象限で、対処の優先順位を決める
調べた結果をもとに何から直すかは、ファセットURLを「検索価値」と「クロール負荷」の2軸で整理すると判断しやすくなります。
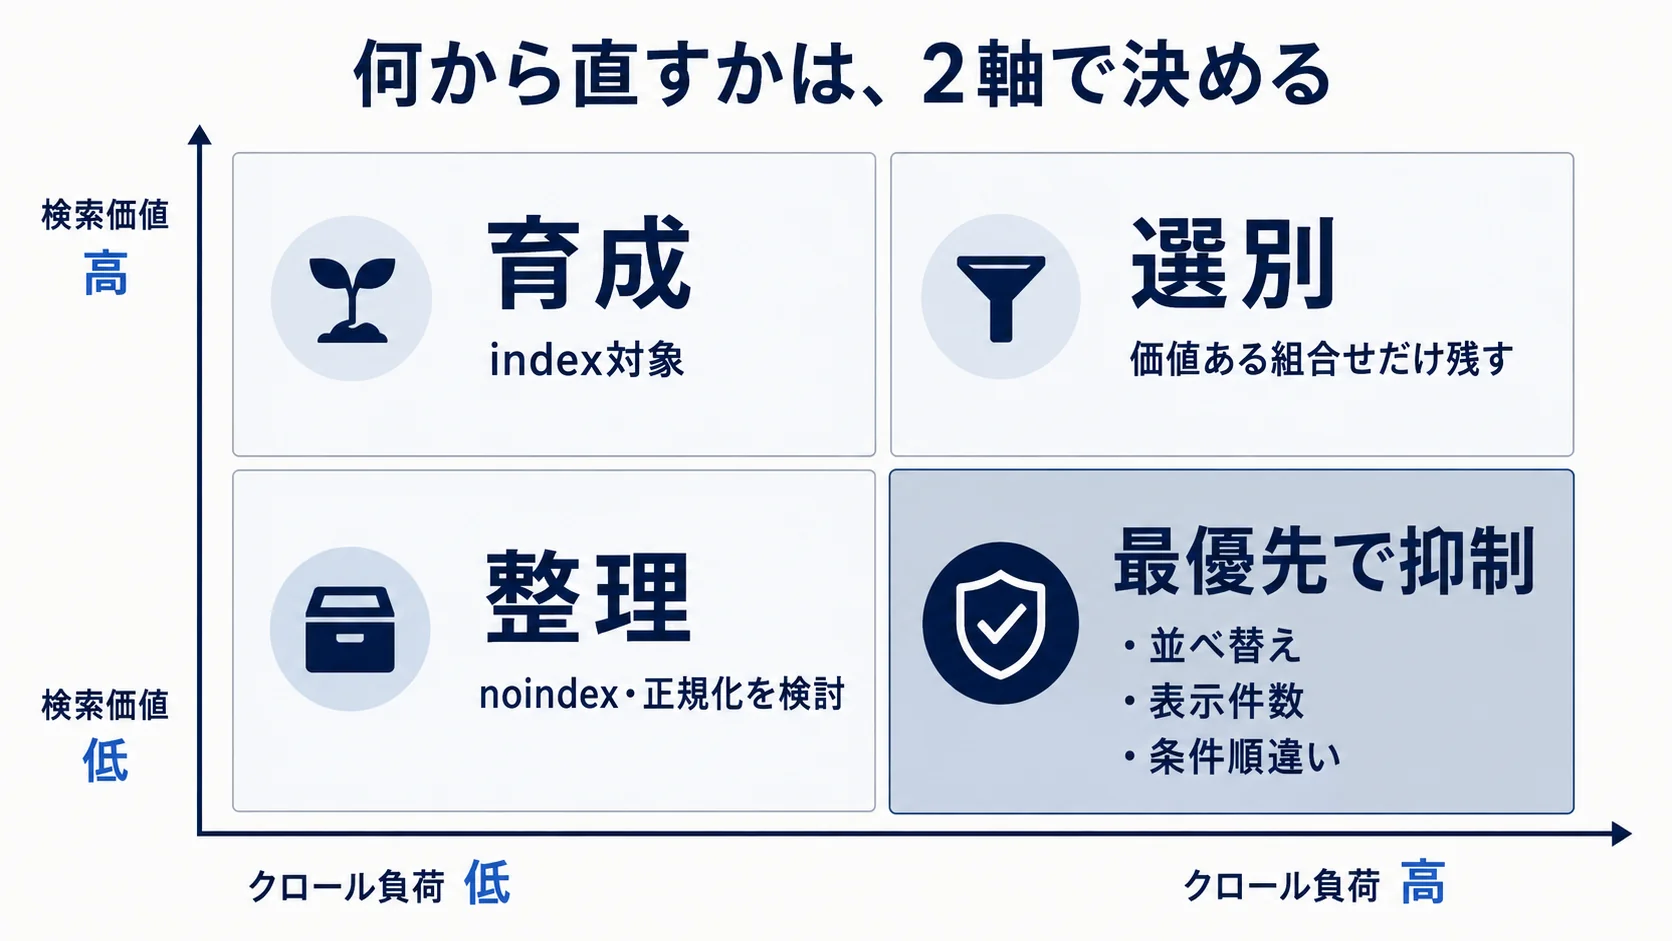
| 検索価値 | クロール負荷 | 基本判断 |
|---|---|---|
| 高い | 低い | index対象として育成 |
| 高い | 高い | index対象を限定し、不要な組み合わせだけ制御 |
| 低い | 低い | noindex・正規化等を検討 |
| 低い | 高い | URL生成・内部リンク・robots.txtまで含めて優先的に抑制 |
4つのうち最も優先度が高いのは、検索価値が低いのに大量にクロールされているURL群です。たとえば、次のようなURLが当てはまります。
- 並べ替え
- 表示件数変更
- セッション情報
- 条件順序違い
- 何段階も重ねた細かなファセット
これらが大量にリンクされている場合は、個別URLのタグ修正だけでなく、URL生成ルールと内部リンク構造から見直します。
監査後は、URLパターン単位の仕様書にまとめる
ファセットSEOは、URLを1件ずつ修正する運用には向きません。監査後は、属性またはURLパターンごとに制御ルールを定義します。
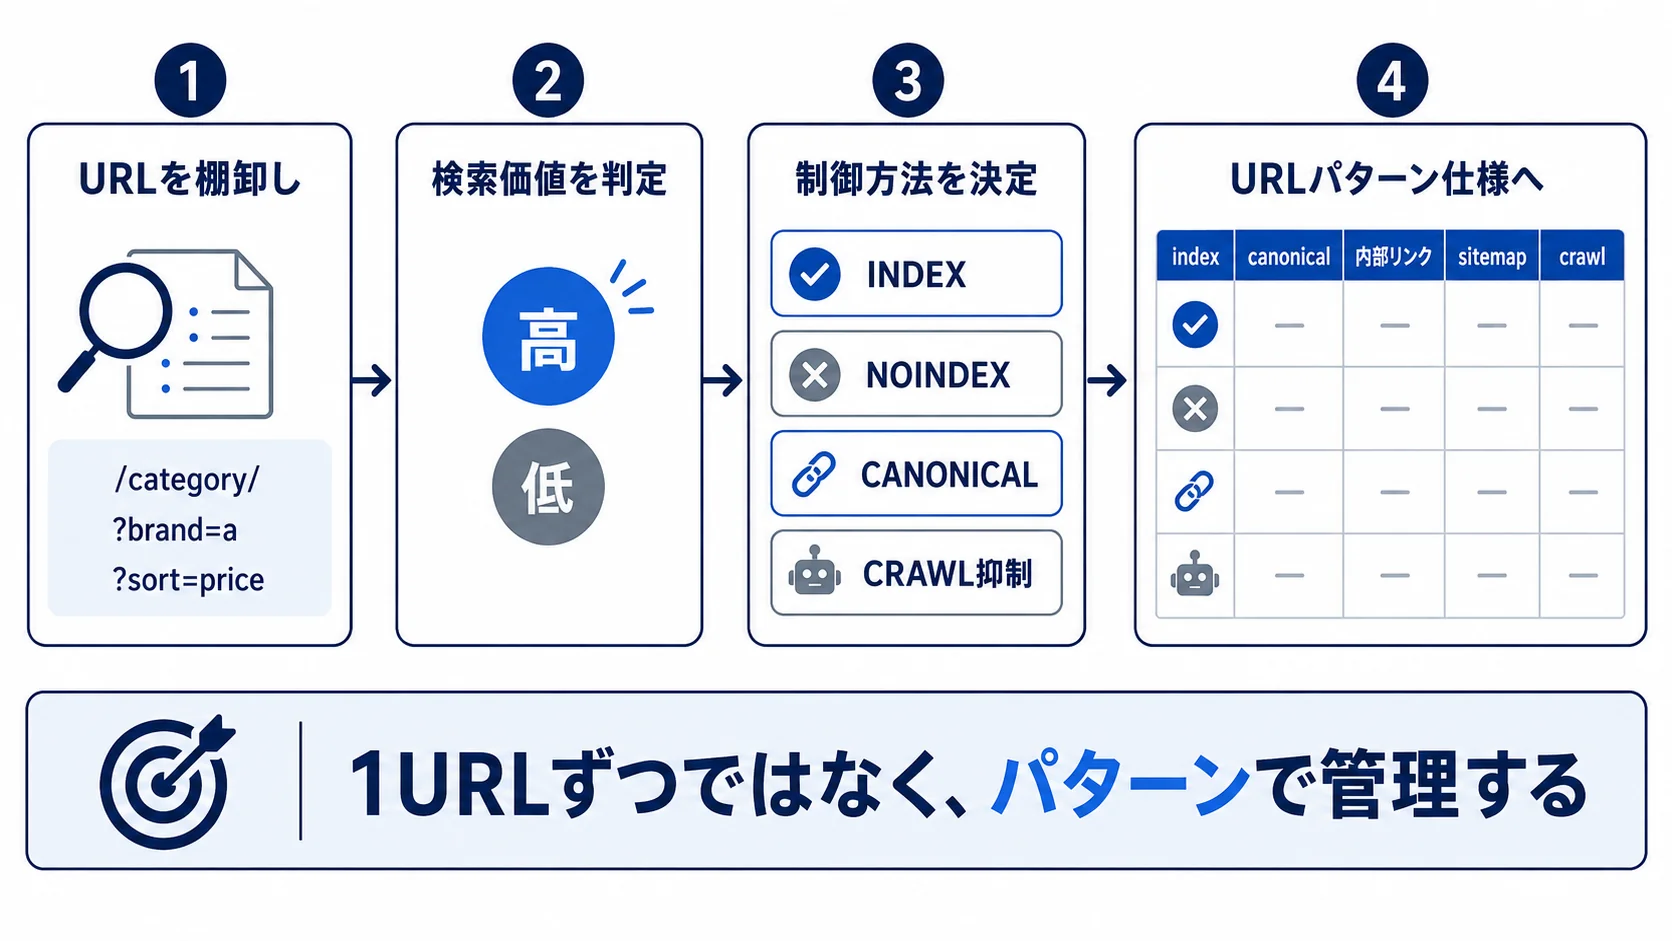
監査結果は個別URLの修正一覧ではなく、URLパターンごとの実装ルールとして開発仕様へ落とし込みます。次の表は、その仕様に書く項目の例です。
| URLパターン | 検索価値 | index | canonical | 内部リンク | sitemap | クロール |
|---|---|---|---|---|---|---|
| カテゴリ | 高 | 可 | self | あり | 収録 | 許可 |
| カテゴリ×主要ブランド | 高 | 可 | self | あり | 必要に応じ収録 | 許可 |
| 細かな複数条件 | 低 | 不可 | 要件に応じ判断 | 原則抑制 | 非収録 | 抑制 |
| 並べ替え | 低 | 不要 | 基準URLへ | 抑制 | 非収録 | 抑制 |
| 0件・不正条件 | なし | 不要 | ― | なし | 非収録 | 404等 |
この表を実装に落とすときは、同じURLパターンにnoindexとrobots.txtによるブロックの両方を割り当てていないか、開発担当者と確認してください。noindexは、クロールされて初めて読み取られるためです(STEP5)。
この仕様を作っておけば、商品・求人・物件が増えても、同じ判断ルールを適用できます。担当者がURLごとに「これはindex、これはnoindex」と判断し続ける状態を避けられる点が、仕様書にまとめる利点です。
ファセットナビゲーション監査のチェックリスト
ここまでの内容を、最終確認として使える形にまとめます。監査では、最低限次の項目を確認してください。
- URLを生成するファセット属性を一覧化した
- 絞り込みと並べ替えを区別した
- 同一条件のURL表記を統一した
- 検索需要のある組み合わせを特定した
- indexさせるURLの条件を定義した
- indexさせないURLの条件を定義した
- 検索価値の低いURLへの内部リンクを確認した
- canonicalの指定先を確認した
- Googleが選択したcanonicalも確認した
noindexとrobots.txtを矛盾させていない- sitemapへ不要なファセットURLを大量掲載していない
- 0件・不正な組み合わせのHTTPステータスを確認した
- Search ConsoleでファセットURLの状態を確認した
- URLパターン単位で実装ルールを文書化した
- 修正後に再クロール・インデックス状況を確認する
すべてを一度に修正できない場合は、「検索価値が低く、Googlebotが大量に到達できるURL」から優先して対処します。
まとめ:URLを一律に処理せず、パターンごとにルールを決める
ファセットナビゲーションのSEO監査では、「絞り込みURLを全部indexする」「パラメータURLを全部noindexにする」といった一律の処理を避けます。URLごとに検索価値と役割が違うからです。
まずURLを棚卸しし、検索需要、ページ内容、内部リンク、重複、クロール状況を確認します。そのうえで、検索価値のあるURLだけを検索対象として残し、残りを正規化・インデックス制御・クロール制御へ振り分けます。
特に注意したいのは、canonical・noindex・robots.txtの目的が異なる点です。canonicalは代表URLを示す仕組み、noindexは検索結果への掲載を防ぐ仕組み、robots.txtはクロールを制御する仕組みです。
大規模サイトでは、個々のURLではなくURLパターン単位で「残す・統合する・検索から外す・クロールを止める」のルールを決めることが、継続的な管理につながります。最初の一歩は、STEP1の棚卸しです。ファセット名、URL表現、選択肢数などを一覧にするところから始めてください。
参考文献・データ元
この記事で参照した情報を確認できます。
- Google, “Managing crawling of faceted navigation URLs”, Google Crawling Infrastructure, 最終更新2025年12月18日。ファセットURLによる過剰クロール、robots.txt、URL構造、404などの公式推奨事項を参照。
- Google Search Central, “Crawling December: Faceted navigation”, 2024年12月17日。ファセットナビゲーションによるURL増加とクロール問題の背景を参照。
- Google Search Central, “What is canonicalization”, 最終更新2026年8月20日。canonicalの役割とGoogleによる正規URL選択について参照。
- Google Search Central, “How to specify a canonical URL with rel=canonical and other methods”, 2026年更新。canonical指定方法とシグナルの扱いを参照。
- Google Search Central, “Block Search indexing with noindex”, 最終更新2025年12月10日。noindexとrobots.txtの関係を参照。
- Google Crawling Infrastructure, “Crawl Budget Management”, 2026年更新。不要URLのクロール制御とnoindexの違いを参照。
- Google Search Central, “Ecommerce Website Navigation Structure”. 内部リンクとECサイト構造について参照。
‹ 親記事: テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト
関連記事
- › INDEX削除(インデックス削除)とは?検索結果から消える仕組みと対処法
- › Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け
- › SEO内部リンクの確認方法|孤立ページ・深度・アンカー偏りを改善
- › ページがインデックスされない原因は?Search Consoleで未登録・除外・重複URLを確認
- › JavaScript SEOの確認方法|表示・内部リンク・登録状況
- › クロールバジェットの確認方法|無駄なクロールと改善優先度
- › 構造化データの確認方法|エラー・本文との不一致・重複を検証
- › 多言語ページの言語・地域指定を確認|相互参照・正規URLをチェック
- › SEOリダイレクトの確認方法|多段転送・ループ・誤転送を検出
- › robots設定のSEO確認方法|クロール許可と登録制御の矛盾を確認
- › ページネーションのSEO確認方法|正規URL・内部リンク・クロール
- › サイト移行後のSEO確認方法|転送・正規URL・順位変動を確認
- › 404・soft 404のSEO確認|リンク切れ・消失URLを修正
- › SEOリリース前チェックの作り方|noindex・canonical・robots・リダイレクトの事故を防ぐ
- › 画像SEOの確認方法|alt・画像URL・遅延読み込みを確認
- › 求人ページの構造化データを確認|給与・勤務地・期限の不一致
- › サイト内検索ページのSEO確認|noindex・クロール・重複URL
- › サイトリニューアルでSEO評価を落とさない移行方法|URL・301・計測・公開手順
- › サービス終了ページは削除すべき?301・404/410・残す場合のSEO判断基準
- › SEOに強いURL・ディレクトリ設計|階層・命名・変更時の注意点
- › サブディレクトリとサブドメインの違い|SEO・運用の判断基準
- › リッチリザルトとは?種類・構造化データ・表示確認方法を解説
- › Google Search Consoleとは?登録方法と最初に見る4つの指標