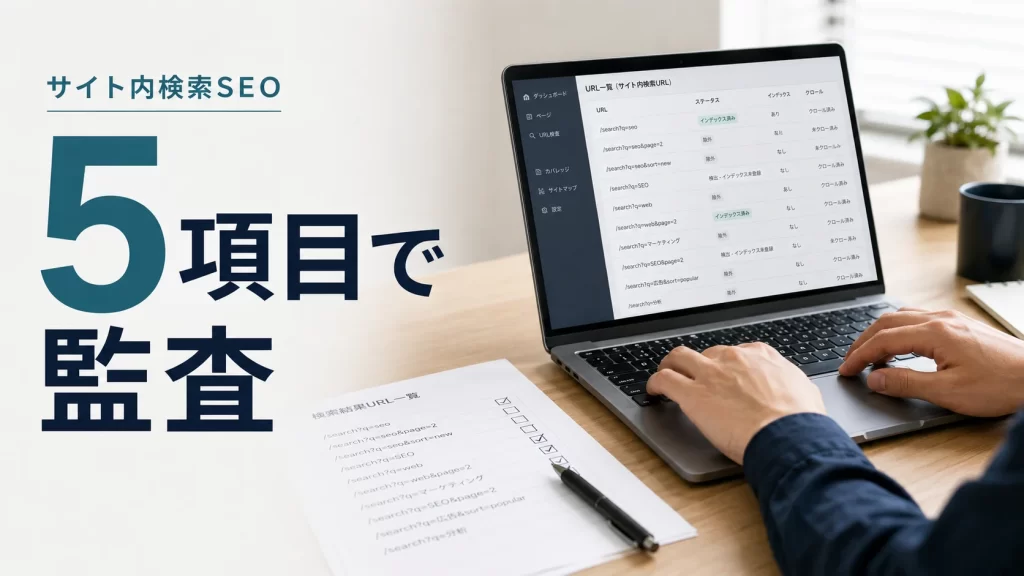
サイト内検索は、訪問者が必要な情報を探すために役立つ機能です。一方、「/search?q=○○」や「/?s=○○」のような検索結果URLを無制限に生成できる状態だと、Googleに不要なURLを発見され、クロールやインデックス登録の対象になることがあります。クロールはGoogleがページを巡回して内容を取得すること、インデックス登録は検索エンジンにページの情報が登録されることです。この2つは別の段階なので、分けて考えます。
対策として最初にやるべきことは、検索結果ページを一律にrobots.txtで遮断することではありません。まず「Google検索に掲載する価値があるURLか」「すでにインデックスされているか」「どれだけクロールされているか」を確認します。そのうえで、noindex、クロール制御、404、専用ランディングページ化を使い分けます。
この記事では、サイト内検索結果URLを5項目で監査し、残す・noindexにする・クロールを止める、という判断まで進める方法を整理します。最後には、URLの状態ごとの推奨対応を一覧にした判断表も載せています。
サイト内検索の結果ページは、利用者には必要でもGoogle検索には原則不要と考える
この節では、監査の前提になる考え方を決めます。サイト内検索結果ページを監査するとき、最初に分けるべきなのは「サイト訪問者に必要か」と「Google検索に掲載する価値があるか」です。
検索窓や検索結果は、サイトを訪れた利用者が目的の記事・商品・FAQなどを見つけるために役立ちます。しかし、その検索語ごとに生成されるURLまで、Google検索に掲載する必要があるとは限りません。
たとえば、次のようなURLが生成されます。
/search?q=seo/search?q=SEO/search?q=seo&page=2/search?q=seo&sort=new/?s=seo
入力語、並び順、ページ番号などによってURLが増えると、内容が似たページが多数できます。
Googleも、並び替えや絞り込み機能によって同じ、または非常に近いコンテンツが複数のURLで存在することを、重複URLが生まれる例として挙げています。ただし、重複コンテンツが存在すること自体をスパムポリシー違反としているわけではありません。問題になるのは、不要なURLが増えることで、Googleが処理するURLの範囲やSEO担当者の管理対象が広がる点です。
そのため、監査では「検索結果ページがある=問題」と判断しません。見るべきなのは、外部検索エンジンに発見・クロール・インデックスさせる必要があるかです。
サイト内検索結果ページを含む技術課題の全体像は、テクニカルSEOの7領域で確認できます。
サイト内検索結果の監査では、5項目を順番に確認する
サイト内検索結果URLは、次の5項目を上から順に確認すると、原因と対策を整理しやすくなります。
| 監査項目 | 確認すること | 主な問題 |
|---|---|---|
| URL | どの形式で検索URLが生成されるか | URLの無制限な増殖 |
| インデックス | Googleに登録されているか | 不要ページの検索結果掲載 |
| クロール | Googlebotがどれだけ取得しているか | クロール・サーバー処理の増加 |
| 内容 | 独立した検索価値があるか | 薄い・重複した検索結果 |
| 発見経路 | 内部リンクやサイトマップから辿れるか | 不要URLの継続発見 |
この表の上から順に、次のSTEP1〜STEP5が対応しています。設定を変更するのは、5項目を確認したあとです。
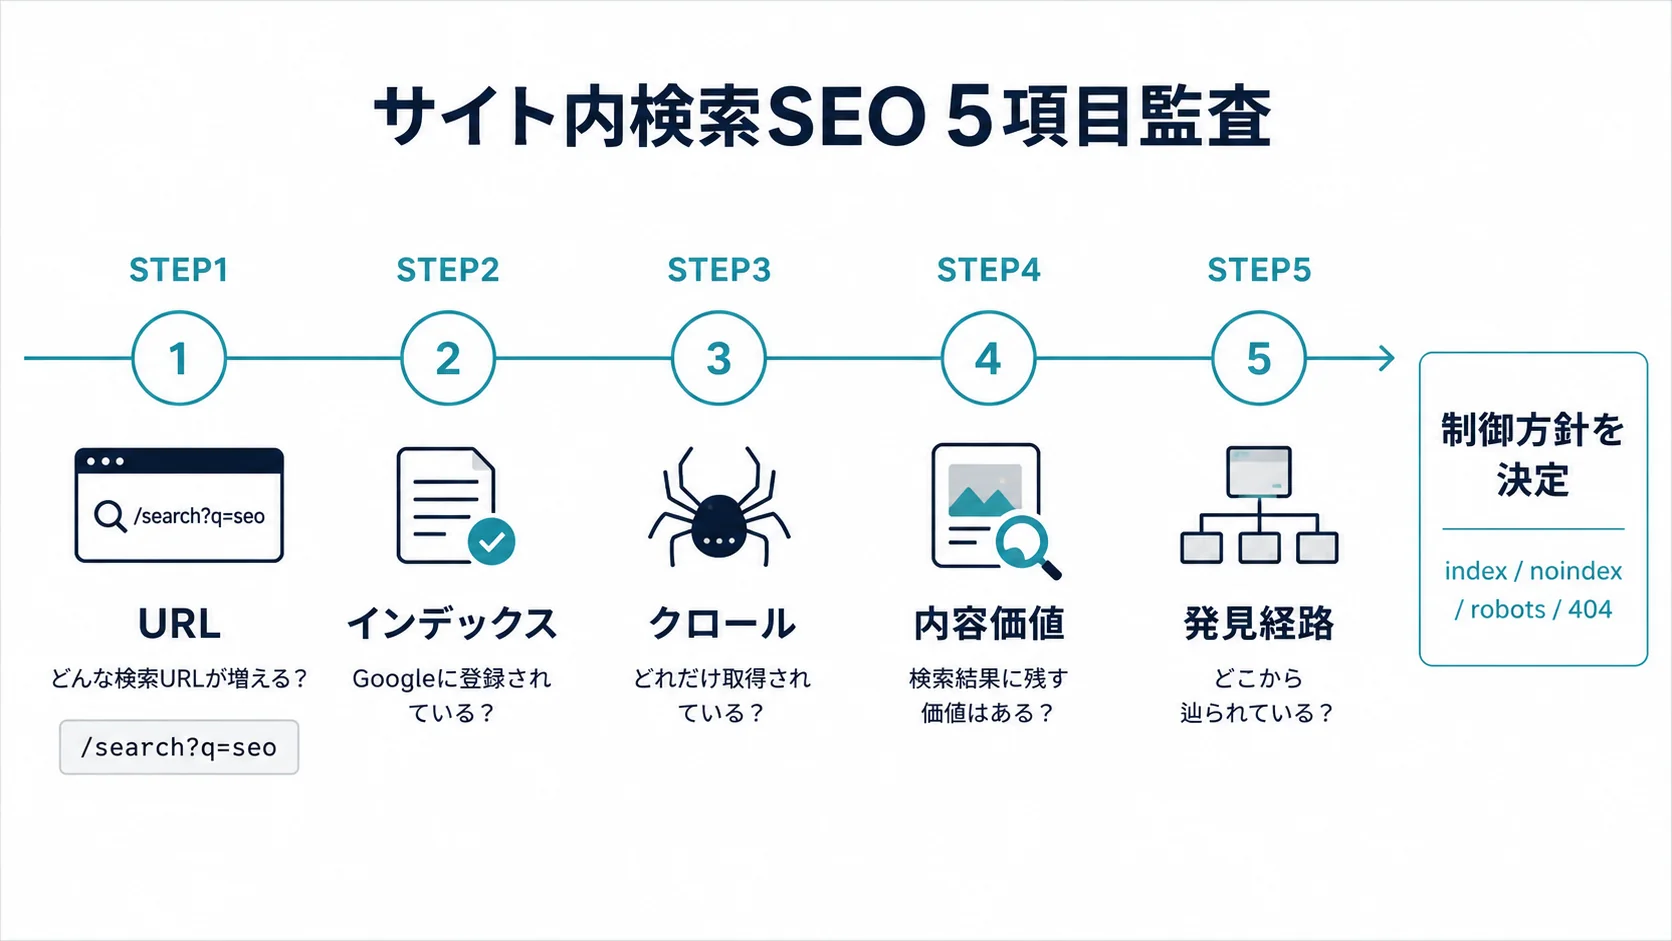
5項目を確認したら、その結果をもとに「index」「noindex」「robots.txt」「404・410」「専用ページ化」のどれを採用するかを決めます。
STEP1|サイト内検索で生成されるURLパターンを洗い出す
最初に確認するのは、サイト内検索がどのような種類のURLを生成するかです。検索窓から数語を入力するだけでは足りません。次のような変化まで確認してください。
- 通常の検索語
- 大文字・小文字
- 全角・半角
- スペースを含む検索語
- 日本語と英語
- 検索結果0件
- 2ページ目以降
- 並び替え
- 絞り込み条件
- カテゴリ指定
- 複数パラメータ
- 空文字
- 極端に長い検索語
たとえば基本URLが/search?q=seoでも、ページ番号と並び順を組み合わせると、/search?q=seo&page=2&sort=newのような別のURLが生成されます。さらに検索語が自由入力なら、理論上生成されるURLは大幅に増えます。
そのため、この段階では個々のURLを見るだけでなく、/search、?q=、?s=など、検索結果URLを判別できる規則を特定します。規則が分かれば、次のSTEP2で代表的なURLを抽出しやすくなります。
STEP2|検索結果URLがGoogleにインデックスされているか確認する
次に、洗い出した検索結果URLがGoogleに登録されているかを、Google Search Consoleで確認します。
優先したいのは、ページのインデックス登録レポートとURL検査です。URL検査では、対象URLのインデックス登録状況や、Googleが認識した正規URLなどを確認できます。
代表的な検索URLを複数抽出し、少なくとも次の5点を確認します。
- インデックス登録されているか
- 「noindex」によって除外されているか
- robots.txtでブロックされているか
- クロール済み・未登録になっているか
- GoogleがどのURLを正規URLとして選んでいるか
検索結果URLがGoogle検索に掲載される必要がないのにインデックスされているなら、対応の優先度は高くなります。
一方、「noindex タグによって除外されました」としてSearch ConsoleにURLが表示されていても、それだけで設定の失敗とは限りません。GoogleがURLをクロールしてnoindexを認識した結果として、記録される場合があるためです。
STEP3|検索結果URLへのクロール量を確認する
インデックスの状態を見たら、次はクロール量を確認します。見るのは、Googleのクローラー(ページを巡回する自動プログラム)であるGooglebotが、検索結果URLをどの程度取得しているかです。
大規模なサイトでは、不要なURLが大量に発見されることで、Googlebotが処理するURLの範囲が広がる可能性があります。ただし、すべてのサイトで「クロールバジェット」を深刻な問題として扱う必要はありません。
Googleの2026年7月更新の案内では、クロールバジェット最適化の高度なガイドは、次のようなサイトを主な対象としています。
- 約100万URL以上で、週単位で内容が変わる大規模サイト
- 約1万URL以上で、日単位に急速に内容が変わるサイト
- Search Consoleで「検出 – インデックス未登録」が大量に発生しているサイト
これらの数字も厳密な境界ではなく、目安とされています。小規模なサイトで新規ページが通常どおりクロールされているなら、クロールバジェットを過度に心配する必要はありません。
ただし、サイト規模が小さくても、次のような状況では対策を検討する価値があります。
- 検索URLが急増している
- 外部から検索URLへ大量のリンクが作られている
- サーバーで検索処理の負荷が高い
- 重要ページより検索結果URLへのアクセスが目立つ
実際の状況は、Search Consoleのクロール統計や、利用できる場合はサーバーログで確認します。検索URLがGooglebotのアクセスのうちどの程度を占めているかを把握してください。
STEP4|検索結果ページに独立してインデックスさせる価値があるか判定する
検索結果URLが見つかったからといって、すべてを機械的にnoindexにする前に、検索結果ページに独立した検索価値があるかを確認します。
判断しやすいように、次の4種類へ分類します。
| 状態 | 基本方針 |
|---|---|
| サイト内利用には必要だが、Google検索には不要 | noindex候補 |
| Googleにもクロールさせる必要がない大量URL | robots.txt候補 |
| 無効な検索・存在しないページ | 404・410等を検討 |
| 外部検索でも継続的な需要があり、独自価値を作れる | 専用ページ化を検討 |
表の「基本方針」は出発点です。すでにインデックスされているURLでは、robots.txtを先に設定せず、後述の順序(noindex→確認→必要ならクロール制御)で進めます。
通常の自由入力によるサイト内検索結果は、検索語に応じて記事や商品へのリンクを並べるためのナビゲーションページです。
一方、「東京都のSEO会社一覧」「初心者向けSEO記事一覧」のように、外部検索でも継続的な需要があり、固定URL・固有タイトル・説明文・独自コンテンツを持たせられるテーマもあります。この場合は、検索結果URLをそのままindexさせるのではなく、専用カテゴリページやランディングページとして設計する方法があります。
つまり、Google検索から集客するページと、サイト内検索機能が一時的に生成したURLは分けて考えます。
STEP5|内部リンクやXMLサイトマップが、不要なURLをGoogleに発見させていないか確認する
最後に、Googleが検索結果URLをどこから発見しているかを確認します。特に見るのは次の箇所です。
- HTML内の検索結果URLへの固定リンク
- 人気検索語・検索履歴へのリンク
- タグや絞り込みUI
- ページネーション
- XMLサイトマップ
- 外部サイトからのリンク
- スパムによって生成された検索URL
通常の検索フォームからPOSTまたはGETで遷移するだけなら、サイト内の通常リンクよりも発見経路を限定できます。
一方、「人気の検索キーワード」のような形で検索結果URLを<a>タグから大量にリンクすると、Googlebotが辿る入口になります。
XMLサイトマップは、Googleにクロール・検索掲載してほしい正規URLを中心に構成するものです。Google検索へ掲載する必要のないサイト内検索結果URLを、サイトマップに含める合理性は通常ありません。
noindex・robots.txt・404・canonicalは目的別に使い分ける
この節では、サイト内検索結果ページで混同されやすい、noindexとrobots.txtの違いを整理します。2つは目的が違います。次の表では、404・410とcanonicalも並べて比べます。
| 方法 | 主な目的 | Googlebotのクロール | Google検索への掲載 |
|---|---|---|---|
| noindex | インデックスさせない | 必要 | 除外を指示 |
| robots.txt | クロールさせない | ブロック | URLが残る可能性あり |
| 404 / 410 | URLが存在しないことを示す | 確認のため発生 | 最終的に除外対象 |
| canonical | 重複URLの代表を示す | 発生する | 代表URLへの統合を促す |
noindexの行の「必要」は、Googlebotがページを取得できる状態が必要という意味です。robots.txtの行の「ブロック」と比べると、noindexはクロールされることが前提で、robots.txtはクロールを止めることが分かります。同じURLに両方を使うと、noindexが読まれません。
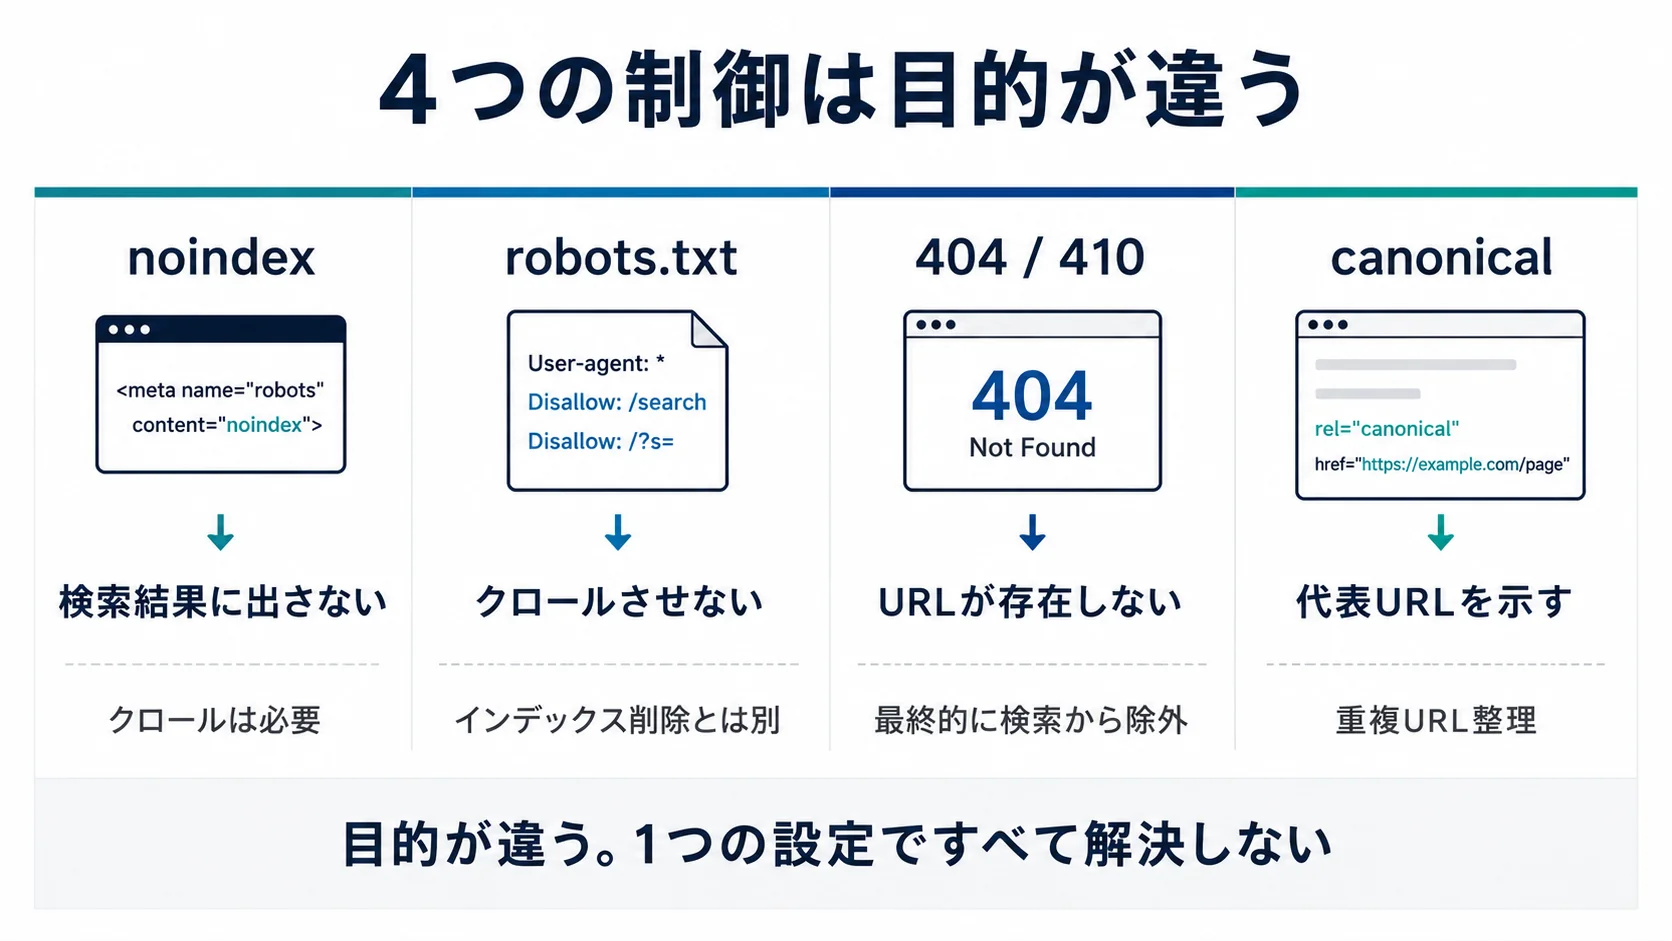
noindexはインデックス制御、robots.txtはクロール制御です。404・410とcanonicalも目的が異なるため、サイト内検索URLの状態に応じて使い分けます。
ここで特に注意したいのが、noindexをGoogleに認識させたいページを、先にrobots.txtで遮断しないことです。Googleは、noindexを有効にするにはGooglebotがページへアクセスできる必要があると明記しています。robots.txtでクロールを止めていると、GooglebotはHTMLやHTTPヘッダーにあるnoindexを確認できません。
したがって、「インデックスを確実に外したい」場合と「今後クロール自体を減らしたい」場合は、分けて考えます。
すでにインデックスされた検索URLは「noindex→確認→必要ならクロール制御」の順で対応する
すでにGoogle検索へ登録された検索結果URLを整理するときは、次の順番が安全です。noindexを先に認識させ、そのあとでクロール制御を考えます。
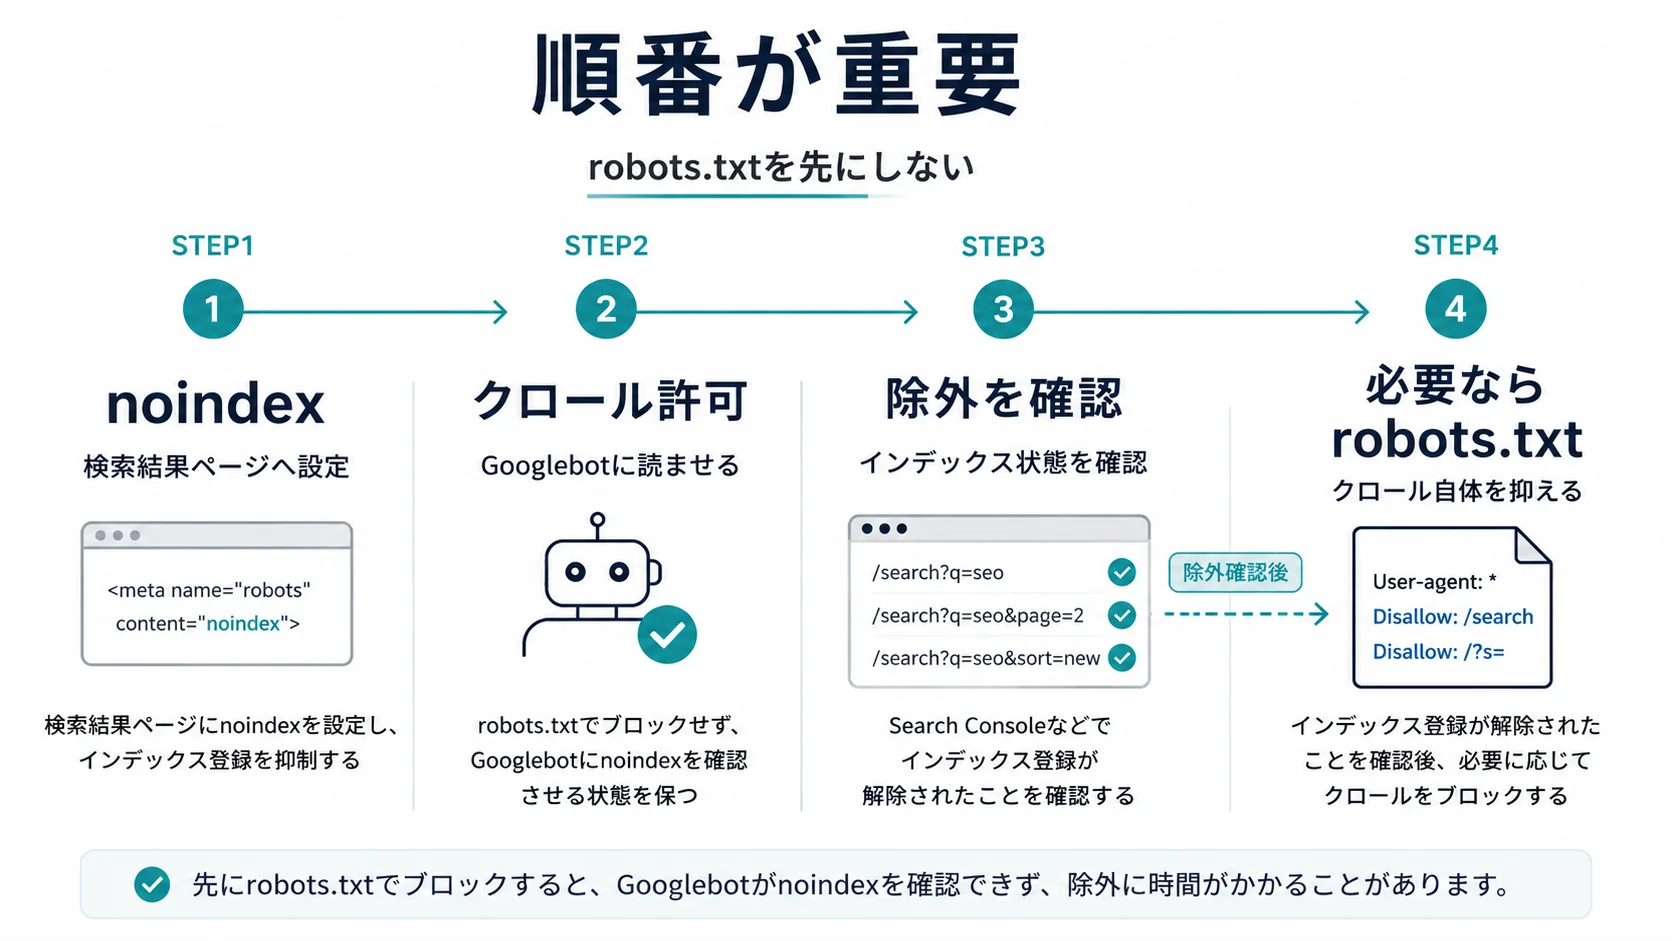
すでにインデックスされた検索結果URLでは、Googlebotがnoindexを確認できる状態を保ちます。除外を確認したあと、必要に応じてクロール制御へ進みます。
1.検索結果ページへnoindexを設定する
まず、検索結果ページにnoindexを指定します。HTMLの<head>内であれば、代表的には次の指定です。
<meta name="robots" content="noindex">
HTTPヘッダーのX-Robots-Tagでもnoindexを指定できます。
2.Googlebotのクロールを許可したままにする
次に、Googlebotがページを取得し、noindexを認識できる状態を維持します。この段階でrobots.txtを追加すると、手順1のnoindexが読まれなくなります。
3.Search Consoleでインデックスから外れたか確認する
代表的なURLをURL検査にかけ、検索結果URLがインデックス対象から外れているかを確認します。
4.クロール自体も不要ならrobots.txtを検討する
インデックスから外れたあとも検索URLが大量に生成され、クロールやサーバー負荷が問題になっている場合は、検索結果URLの規則に応じて、robots.txtによるクロール制御を検討します。
Googleのクロールバジェット向けガイドでも、クロールする必要がないURLについては、robots.txtを利用する選択肢が示されています。一方、クロール効率を目的にnoindexを使うと、Googleはnoindexを確認するためにページを取得し続けます。目的に応じた使い分けが必要です。
つまり、インデックス除外とクロール削減を同じ設定で一度に解決しようとしないことがポイントです。
canonicalだけでサイト内検索結果URLを処理しようとしない
検索結果URLとカテゴリページなどの内容が近いと、canonicalを設定したくなることがあります。canonicalは、似た内容を持つ複数のURLの中から、代表として扱ってほしいURLをGoogleへ伝える仕組みです。
ただしGoogleは、canonicalの指定を「ルール」ではなく「ヒント」と説明しています。指定したURLと異なるURLが、正規URLとして選ばれる場合もあります。そのため、「Google検索には絶対に出したくない」という目的を、canonicalだけで実現するのは適切ではありません。
目的ごとに選ぶ手段は、次のとおりです。
- インデックスさせたくない → noindex
- クロールさせたくない → robots.txt
- 存在しない → 404・410
- 重複URLを代表URLへ整理したい → canonical
Search Consoleの「URLパラメータツール」を前提にした対策は、現在使えない
過去のSEO記事では、検索URLのパラメータをGoogle Search Consoleの「URLパラメータツール」で制御する方法が紹介されていることがあります。しかし、このツールは現在利用できません。
Googleは2022年3月28日、URLパラメータツールを1か月後に廃止すると発表しました。当時Googleは、ツールに設定されていたパラメータ構成のうち、クロールに有効だったものは約1%だったと説明しています。その後は、GoogleのクローラがURLパラメータを自動的に扱う方針を示しました。より強いクロール制御が必要な場合は、robots.txtを利用できます。
したがって、2026年現在の監査では、「Search ConsoleでURLパラメータを登録すればよい」という手順を対策に含めないよう注意してください。
検索結果0件やスパム検索URLも、通常の検索と分けて確認する
検索結果が0件になるURLも監査の対象です。たとえば/search?q=存在しない長い文字列へ誰でもアクセスでき、200 OKで検索結果ページを返す仕組みでは、外部から任意の検索文字列を含むURLを生成できます。
Google Search Central Communityでも、外部の第三者がサイト内検索クエリを利用して任意の検索結果URLを生成し、Googlebotに発見させる「Internal Site Search Spam」が紹介されています。推奨策として、検索結果ページのnoindex、結果が存在しない場合の404などが挙げられています。なお、コミュニティ投稿はGoogleの公式仕様そのものではないため、実装判断はGoogle Search Centralの公式ドキュメントと合わせて行う必要があります。
検索結果0件のURLについては、次の4点も確認します。
- 本当に存在するページとして200を返す必要があるか
- 404を返しても利用者の検索体験を維持できるか
- 検索文字数を制限できるか
- 不自然な検索パターンをアプリケーション側で拒否できるか
サイト内検索のSEO監査で使える判断表
最終的には、URLごとではなく「URLパターン」単位で方針を決めます。次の表は、ここまでの内容をURLの状態別にまとめたものです。
| URLの状態 | index | noindex | robots.txt | 404等 | 推奨対応 |
|---|---|---|---|---|---|
| 通常の自由検索結果 | △ | ○ | 条件次第 | – | 原則noindexを検討 |
| すでに大量インデックス | × | ◎ | 後から検討 | – | まずnoindexを認識させる |
| インデックス除外済みだが大量クロール | × | ○ | ○ | – | クロール量・負荷を見てrobots制御 |
| 検索結果0件・無効URL | × | ○ | 条件次第 | ○ | 404等も含めて設計 |
| 並び替えだけが違う重複URL | △ | ○ | ○ | – | canonicalまたはクロール制御を検討 |
| 固定需要があり独自価値を作れる | ○ | × | × | × | 専用カテゴリ・LPとして設計 |
表の使い方は、自社の検索URLをパターンごとにこの行へ当てはめることです。たとえば、すでに大量にインデックスされているパターンは、robots.txtより先にnoindexを認識させます。インデックスから外れたあとも大量にクロールされるパターンは、クロール量や負荷を見てrobots.txtを検討します。
「検索結果ページだから必ず1つの設定」と決めるのではなく、インデックス、クロール、URLの存在意義を分けて決めます。
監査後は、URLを増やす原因そのものも修正する
noindexやrobots.txtを設定しても、不要なURLを無制限に生成・発見できる構造が残る場合があります。そのため、技術設定と同時に、次の4点も確認します。
内部リンクを整理する
検索結果URLへの固定リンクや、不要な検索履歴・人気検索語リンクが大量にある場合は、削減します。
XMLサイトマップから除外する
Google検索に掲載したくない検索結果URLは、原則として、検索対象の正規ページをまとめるXMLサイトマップへ含めません。
URL生成条件を制限する
不要なソート条件、検索語の長さ、無効なパラメータなどによるURL生成を制限します。
外部検索で集客したい需要は専用ページへ置き換える
検索ログから継続的な需要が見つかった場合は、検索結果URLをそのままSEOページにするのではなく、独立した記事・カテゴリ・一覧ページとして設計します。
サイト内検索を使う利用者の利便性を残しながら、Googleが処理するURLだけを整理できます。
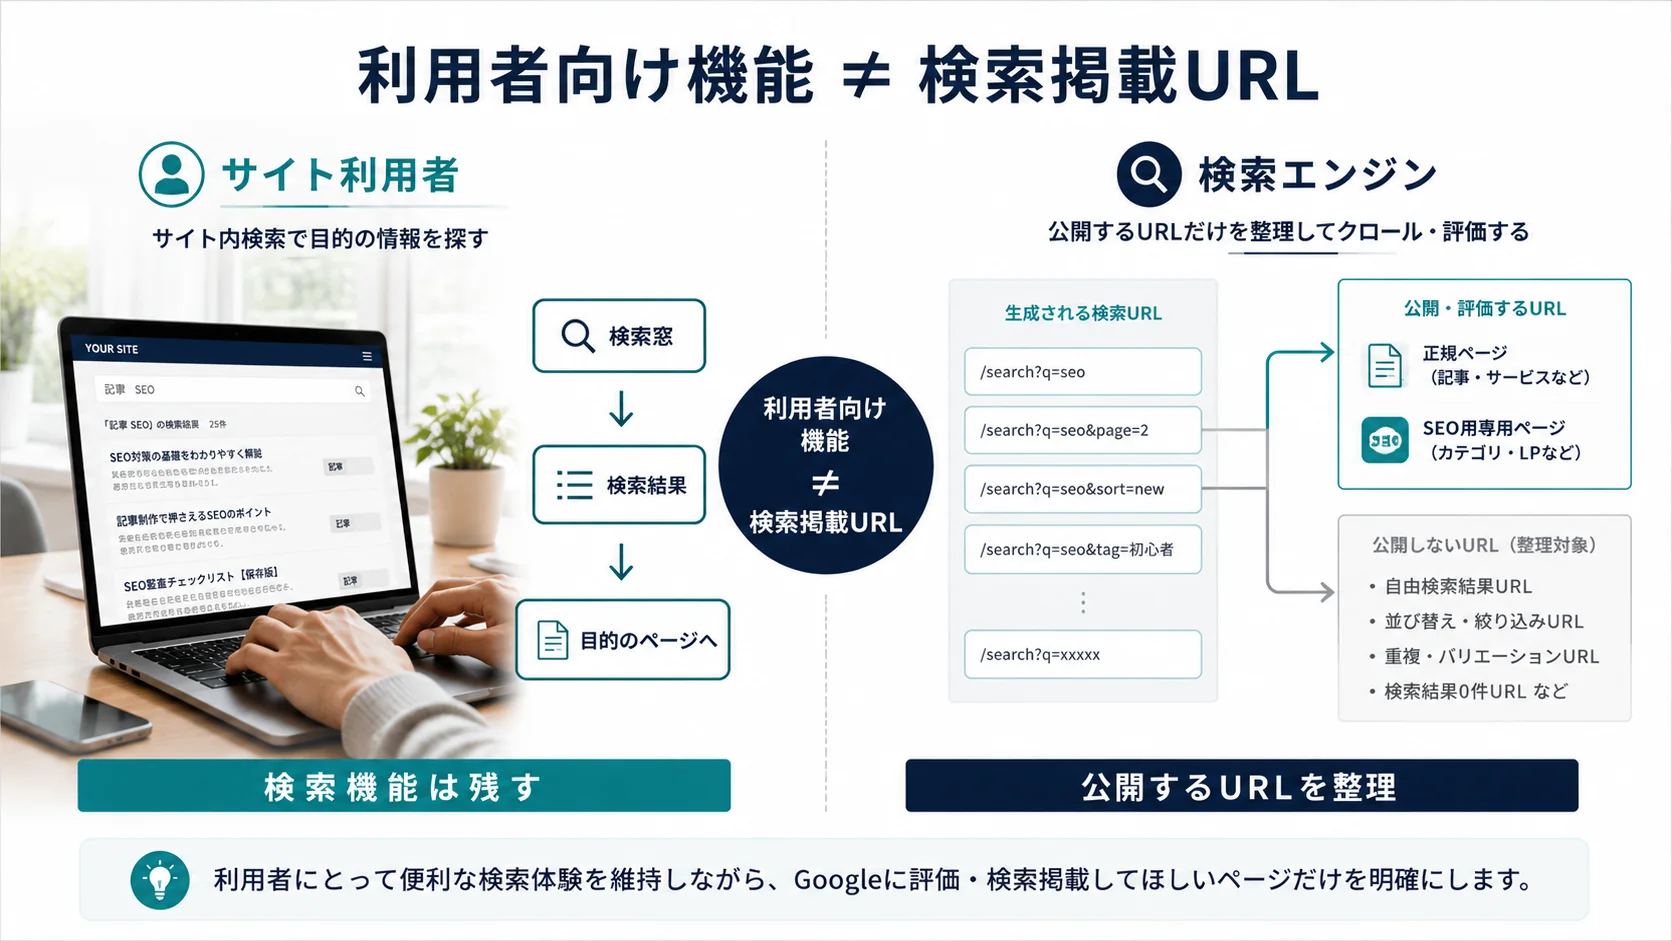
サイト内検索そのものを削除する必要はありません。利用者向けの検索機能と、外部検索エンジンへ公開するURLを分けて設計します。
修正後は「インデックス数」だけでなく、クロールと重要ページも再確認する
修正が終わったら、次の項目を継続して確認します。
| 確認項目 | 見るポイント |
|---|---|
| ページのインデックス登録 | 不要な検索URLがindexされていないか |
| URL検査 | noindexやrobotsの状態が想定どおりか |
| クロール統計 | 検索URLへのクロールが増えていないか |
| サーバーログ | Googlebotがどの検索URLへアクセスしているか |
| XMLサイトマップ | 不要URLが再混入していないか |
| 重要ページ | 新規・更新ページが通常どおりクロールされているか |
この表は、設定を変えたあとに状態が想定どおりかを確かめる点検リストです。インデックス登録とURL検査は除外の確認、クロール統計とサーバーログはクロール量の確認、XMLサイトマップは不要URLの再混入の確認、重要ページは新規・更新ページへの影響の確認に使います。
クロールバジェット対策では、「検索URLへのクロールが減った」という数字だけを成功条件にしないでください。最終的に確認したいのは、不要URLの管理負荷やサーバー処理が減り、Googleに見せたい正規ページを明確にできている状態です。
まとめ
サイト内検索結果ページのSEO監査では、検索結果URLを見つけてすぐrobots.txtへ追加するのではなく、URL、インデックス、クロール、内容価値、発見経路の5項目を確認します。
一般的なサイト内検索結果ページは、サイト訪問者には必要でもGoogle検索へ掲載する必要がないため、noindexが有力な選択肢です。ただし、すでにインデックスされたURLをnoindexで外したい場合は、Googlebotがnoindexを確認できるよう、クロールを許可しておく必要があります。クロール自体も不要になった場合は、インデックス除外を確認したあとにrobots.txtを検討します。
また、外部検索でも継続的な需要があるテーマは、自由入力の検索結果URLをindexさせるのではなく、独自コンテンツを持つ専用カテゴリページやランディングページとして設計した方が、管理しやすくなります。
最初の一歩は、STEP1で検索結果URLを判別する規則を洗い出し、STEP2で代表的なURLのインデックス状態を確認することです。サイト内検索は利用者のために残しながら、Googleに処理させるURLだけを整理することが、サイト内検索結果SEO監査の基本です。
参考文献・データ元
この記事で参照した情報を確認できます。
-
Google Search Central「noindex を使用してコンテンツをインデックスから除外する」
noindexの仕様、robots.txtでブロックしたページではnoindexを確認できない点を参照。
参照ページ -
Google Crawling Infrastructure「Optimize your crawl budget」
2026年7月22日更新。クロールバジェットの対象規模、URL在庫、robots.txt、404、サイトマップに関する判断を参照。
参照ページ -
Google Search Central「What is URL canonicalization」
2026年7月10日更新。並び替え・絞り込みによる重複URLとcanonicalの位置付けを参照。
参照ページ -
Google Search Central Blog「Spring cleaning: the URL Parameters tool」
2022年3月28日公開。Search ConsoleのURLパラメータツール廃止と現在の扱いを確認。
参照ページ -
Google Search Central Community「What to do about Internal Site Search Spam?」
2024年9月公開。サイト内検索を悪用したURL生成、noindex、404、robots.txtの実務例を補助情報として参照。
参照ページ
※Google公式仕様ではなくコミュニティ情報のため、仕様判断はGoogle公式ドキュメントを優先。
‹ 親記事: テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト
関連記事
- › INDEX削除(インデックス削除)とは?検索結果から消える仕組みと対処法
- › Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け
- › SEO内部リンクの確認方法|孤立ページ・深度・アンカー偏りを改善
- › ページがインデックスされない原因は?Search Consoleで未登録・除外・重複URLを確認
- › JavaScript SEOの確認方法|表示・内部リンク・登録状況
- › クロールバジェットの確認方法|無駄なクロールと改善優先度
- › 構造化データの確認方法|エラー・本文との不一致・重複を検証
- › 多言語ページの言語・地域指定を確認|相互参照・正規URLをチェック
- › 絞り込み検索のSEO確認方法|URL増加・クロール・重複を防ぐ
- › SEOリダイレクトの確認方法|多段転送・ループ・誤転送を検出
- › robots設定のSEO確認方法|クロール許可と登録制御の矛盾を確認
- › ページネーションのSEO確認方法|正規URL・内部リンク・クロール
- › サイト移行後のSEO確認方法|転送・正規URL・順位変動を確認
- › 404・soft 404のSEO確認|リンク切れ・消失URLを修正
- › SEOリリース前チェックの作り方|noindex・canonical・robots・リダイレクトの事故を防ぐ
- › 画像SEOの確認方法|alt・画像URL・遅延読み込みを確認
- › 求人ページの構造化データを確認|給与・勤務地・期限の不一致
- › サイトリニューアルでSEO評価を落とさない移行方法|URL・301・計測・公開手順
- › サービス終了ページは削除すべき?301・404/410・残す場合のSEO判断基準
- › SEOに強いURL・ディレクトリ設計|階層・命名・変更時の注意点
- › サブディレクトリとサブドメインの違い|SEO・運用の判断基準
- › リッチリザルトとは?種類・構造化データ・表示確認方法を解説
- › Google Search Consoleとは?登録方法と最初に見る4つの指標