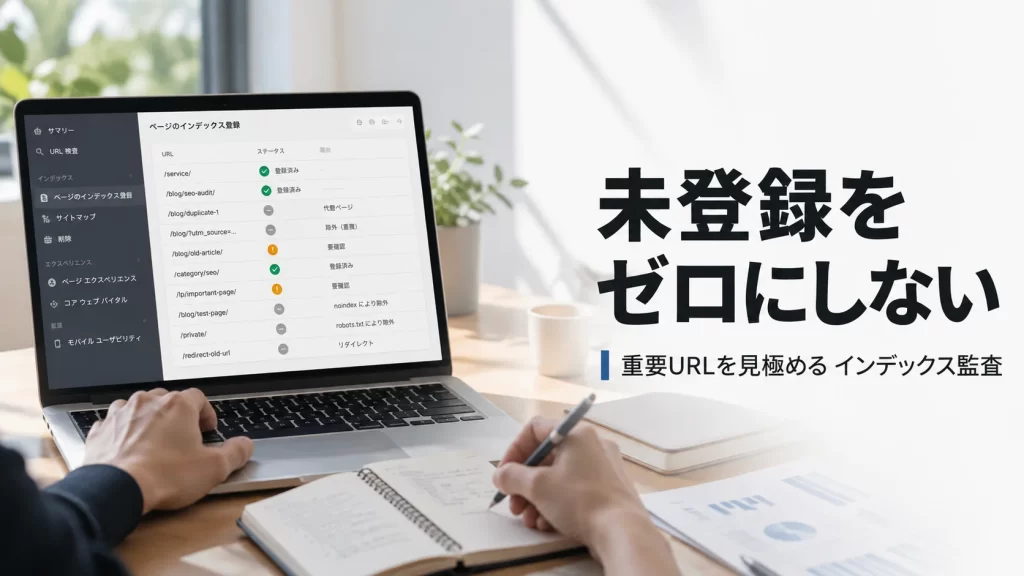
Search Consoleの「ページのインデックス登録」レポートで「インデックス未登録」が増えていると、すべて修正が必要なように見えます。しかし、重複URL、リダイレクト元、noindex(検索結果に登録させない指定)を意図的に付けたページなどは、未登録でも正常です。
インデックス登録とは、検索エンジンにページ情報が登録されることで、ページを巡回して内容を取得するクロールとは別の段階です。ここで確認すべきなのは、未登録URLの数ではありません。検索結果に出したい正規URLが登録され、不要なURLが意図どおり除外されているかどうかです。
未登録になる原因は、noindexやrobots.txt(クローラーのアクセスを制御するファイル)のような技術的な制御、canonicalの食い違い、サイトマップや内部リンクの不整合など、複数あります。どこに原因があるかで確認する場所が変わるので、この記事では、原因を順に切り分けるこの確認作業を「インデックス監査」として説明します。監査対象の決め方から未登録理由の分類、URL検査、各原因の確認、修正の優先順位、修正後の再検証までを順に説明します。
インデックス監査を含む、クロール・正規化・構造化・表示などテクニカルSEO全体は「テクニカルSEOの実務チェックリスト」で整理しています。
インデックス監査は「未登録をゼロにする作業」ではない
この節では、監査で何を正常と見なし、何を修正候補にするかの基準を決めます。
SEOのインデックス監査とは、サイト内URLの発見・クロール・インデックス状態が、運営側の意図と一致しているかを確認する作業です。Google Search Consoleも、重複URL、noindex、robots.txtによる制御、削除済みURLなどが未登録になるのは正常だと案内しています。そこで、運営側の意図とGoogleの状態を組み合わせた、次の4分類を最初に作ります。
| 運営側の意図 | Googleの状態 | 判断 |
|---|---|---|
| インデックスさせたい | 登録済み | 原則正常 |
| インデックスさせたい | 未登録 | 原因調査・修正候補 |
| インデックスさせたくない | 未登録 | 原則正常 |
| インデックスさせたくない | 登録済み | 制御方法を確認 |
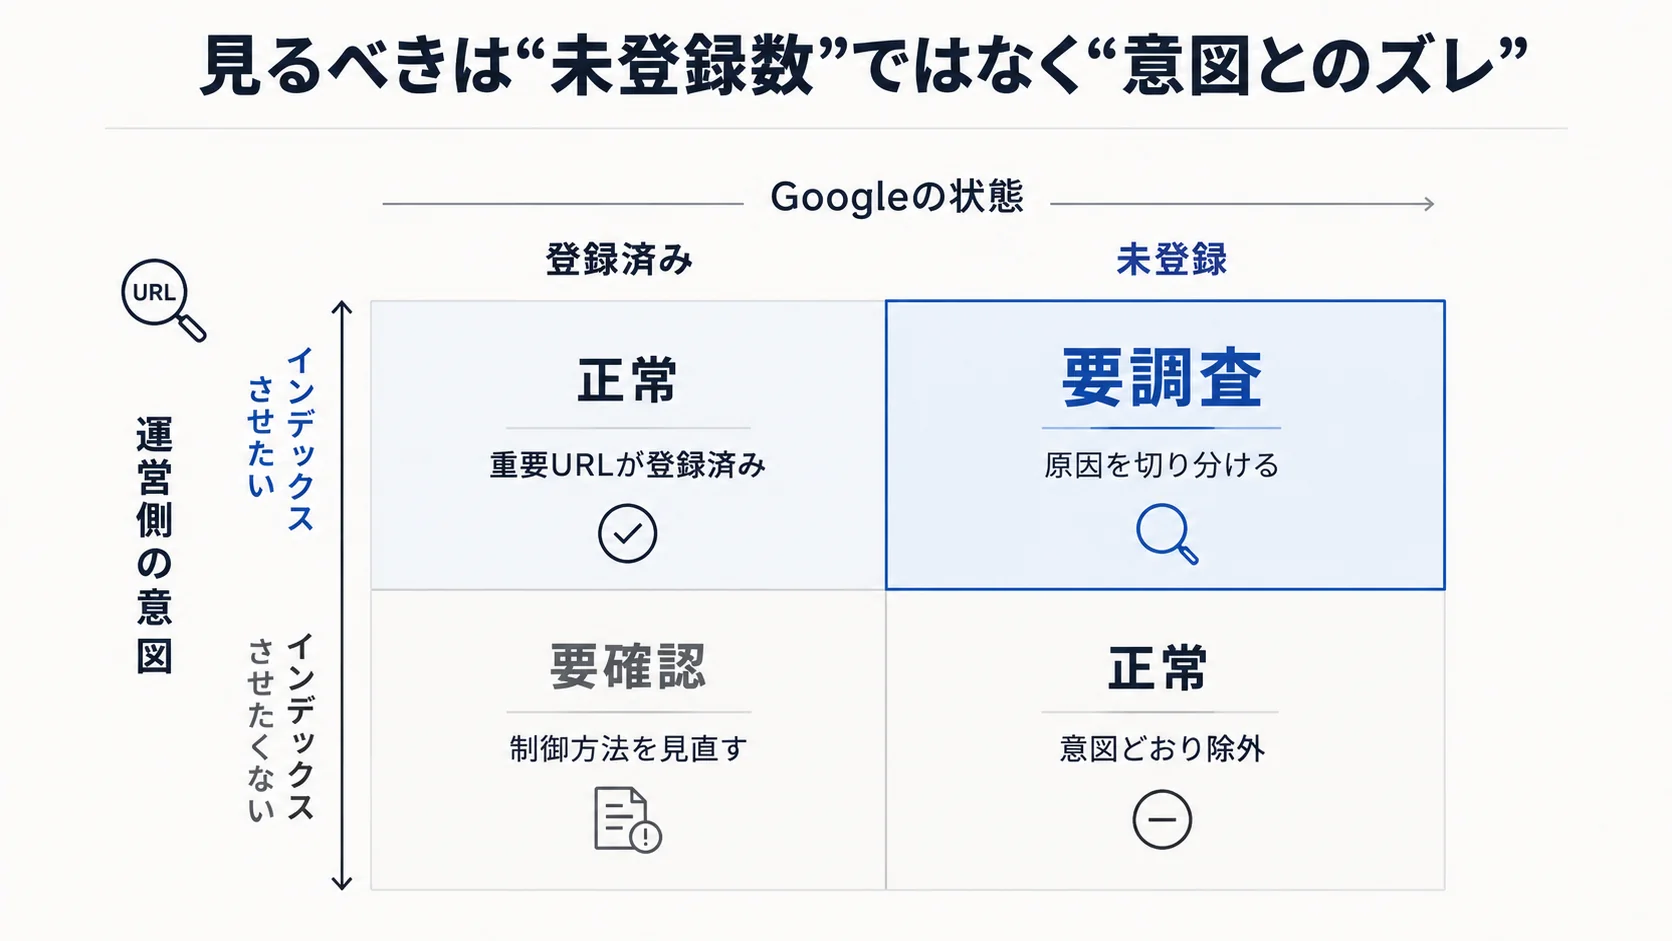
表のうち、対応を考えるのは「インデックスさせたいのに未登録」のURLと、「インデックスさせたくないのに登録済み」のURLです。前者は原因を調べて修正候補にし、後者はどのように制御しているかを確認します。それ以外の2つは、原則として正常と判断します。
したがって、見るべき数字は未登録URLの総数ではなく、本来インデックスされるべき重要URLが未登録になっていないかです。次のSTEP1から、この基準で実際の手順に入ります。
STEP1|監査の対象にする「インデックスさせたいURL」を決める
この節では、監査するURLの範囲を決めます。Search Consoleを見る前に、検索結果へ表示したい正規URLの一覧を作ってください。
オウンドメディアなら、公開記事、ピラーページ、主要カテゴリ、サービスページ、事例ページなどが対象です。一方、管理画面、検索結果ページ、重複パラメータURL、テストURL、リダイレクト元などは、原則として対象外です。
CMSの公開URL一覧、XMLサイトマップ、サイトクロール結果を突き合わせ、「検索結果に出したい正規URL」を絞り込んで、これを監査の対象とします。
XMLサイトマップについて、Googleは、検索結果に表示したいURLを含めるよう案内しています。1つのサイトマップの上限は、非圧縮で50MBまたは50,000URLです。大規模サイトでは、記事・商品・カテゴリなどに分けると、URL群ごとの異常を追いやすくなります。
STEP2|Search Consoleで「なぜ未登録か」を理由別に分類する
この節では、未登録のURLを理由ごとに分け、どれから調べるかを決めます。「ページのインデックス登録」レポートでは、登録済み・未登録の総数よりも、「なぜ登録されなかったか」の内訳を見ます。次の表は、主な状態ごとの初期判断と、最初の確認先をまとめたものです。
| 主な状態 | 初期判断 | 最初の確認 |
|---|---|---|
| クロール済み – インデックス未登録 | 要調査 | URL検査、重複、内容、内部リンク |
| 検出 – インデックス未登録 | 要調査 | サイトマップ、内部リンク、サーバー |
| noindexタグによって除外 | 意図確認 | meta robots、X-Robots-Tag |
| robots.txtによりブロック | 意図確認 | robots.txt |
| 代替ページ(適切なcanonicalあり) | 多くは正常 | canonical先 |
| Googleが別URLを正規URLとして選択 | 要確認 | Google選択canonical |
| リダイレクトのあるページ | 多くは正常 | 転送先 |
「要調査」の2つは、原因を調べて修正の要否を決める状態です。「意図確認」の2つは、運営側が意図して設定したものかを確かめます。「多くは正常」の状態でも、転送先やcanonical先が想定どおりかは最初に確認します。「Googleが別URLを正規URLとして選択」は、選ばれたURLが想定と合っているかを見る状態です。
件数の多い理由から機械的に直すのではなく、重要URLが含まれる状態を優先します。たとえば、主要サービスページ1件の誤noindexは、不要なパラメータURLが多数除外されている状態よりも優先度が高くなります。
STEP3|重要URLはURL検査ツールで一つずつ確認する
サイト全体の傾向はページのインデックス登録レポートで見て、重要URLの原因特定にはURL検査ツールを使います。URL検査では、主に次の項目を確認します。
- インデックス登録の有無
- 検出元
- 最終クロール日時
- クロール可否
- 取得成功
- インデックス可否
- ユーザー指定canonical
- Google選択canonical
なお、URL検査に表示される登録済み情報は、Googleが最後に取得した状態であり、現在公開中のページと一致しない場合があります。そのため、設定変更直後は、現在のHTMLとHTTP応答を確認できるライブテストを使ってください。それでも、ライブテストで「インデックス登録可能」と出たことは、実際の登録を保証するものではありません。
STEP4|まずnoindex・robots.txt・HTTPステータスの異常を確認する
本来インデックスさせたいURLが未登録なら、本文を直す前に、明確な技術制御がないかを確認します。
noindexは、HTMLだけでなく、HTTPレスポンスのX-Robots-Tagでも指定できます。それぞれ、次の形で記述されます。
<meta name="robots" content="noindex">X-Robots-Tag: noindexGoogleがnoindexを認識するには、ページをクロールできる必要があります。noindexを付けたURLをrobots.txtでもブロックすると、Googlebot(Googleのクローラー)がnoindexを読み取れない場合があります。
robots.txtでは、記事やサービスページを意図せず止めていないかを確認します。リニューアル直後は、開発環境用の全体ブロックが本番に残っていないかも確認しましょう。
さらに、重要ページが200を返しているか、5xxエラー、認証の要求、意図しないリダイレクトなどが起きていないかを見ます。ここまでで明確な制御が見つからなければ、次のSTEP5でcanonicalを確認します。
STEP5|canonicalは指定だけでなく、Googleが選んだURLまで確認する
canonicalは、重複・類似URLの中で代表として扱ってほしいURLを伝える仕組みです。ただし強制命令ではありません。Googleはリダイレクト、サイトマップ、rel="canonical"など複数のシグナルから正規URLを選び、運営者の指定とは異なるURLを選ぶことがあります。このため、タグの有無だけでなく、Googleが実際に選んだURLまで確認する必要があります。
canonicalの監査では、次の項目を確認します。
- 自己参照のcanonical(self canonical)になっているか
- canonical先が200を返しているか
- noindexが付いていないか
- 内部リンクがどのURLを向いているか
- サイトマップに掲載されているURLが何か
最後に、URL検査に表示される「Googleが選択した正規URL」と照合します。
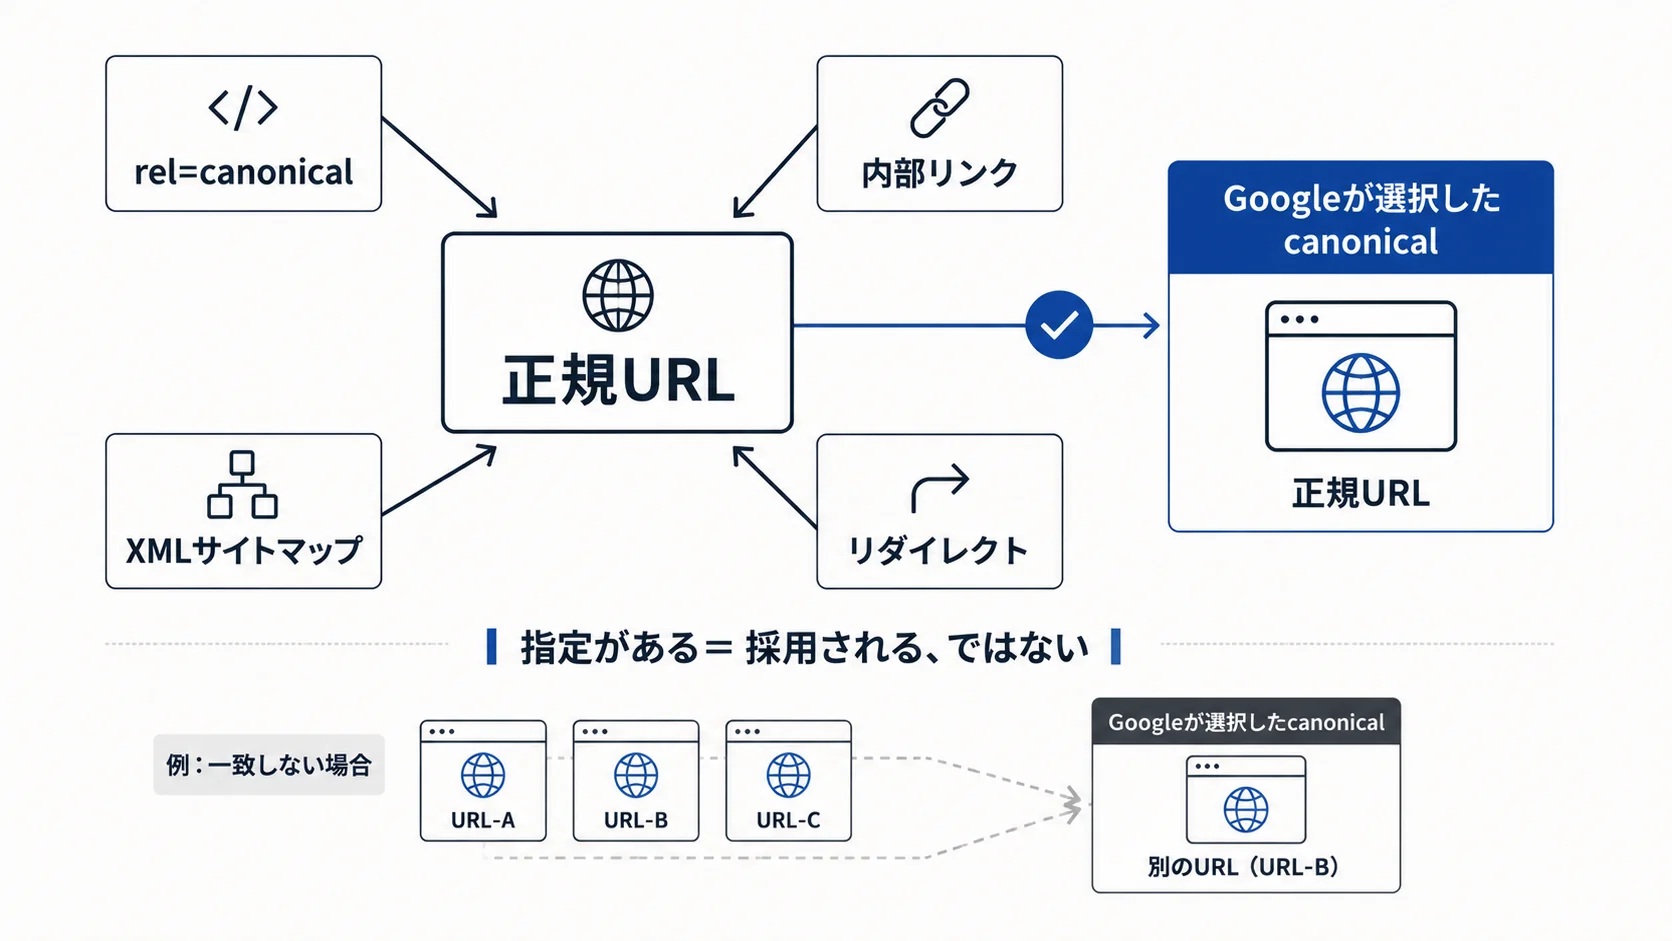
図のように、canonical指定、内部リンク、XMLサイトマップ、リダイレクトの各シグナルが、Googleの選択と一致しているかを見ます。
パラメータURLが除外され、意図した通常URLが正規URLになっているなら、多くの場合は正常です。一方、重要記事が別記事の重複としてまとめられている場合は、技術的な指定だけでなく、ページ同士の内容の差も見直します。
重複URL、誤指定、自己参照、Google選択URLとの不一致をURL単位で確認する手順は、「canonicalタグの監査方法」で詳しく解説しています。
STEP6|「クロール済み」と「検出済み」で、見る場所を変える
同じ未登録でも、Googleがどこまで処理したかによって、確認する場所は変わります。この節では、「クロール済み – インデックス未登録」(以下、クロール済み)と、「検出 – インデックス未登録」(以下、検出済み)を分けて診断します。
クロール済みは、GoogleがURLを取得したものの、現在は登録していない状態です。200の応答、noindex、canonical、レンダリング結果に問題がなければ、類似ページとの重複、固有情報、内部リンク、サイト内での位置づけを確認します。インデックス登録リクエストを繰り返すより、原因を修正するほうが先です。
検出済みは、URLの存在を認識しているものの、まだクロールしていない状態です。XMLサイトマップ、重要ページからの内部リンク、不要URLの大量発生、サーバーの安定性などを確認します。
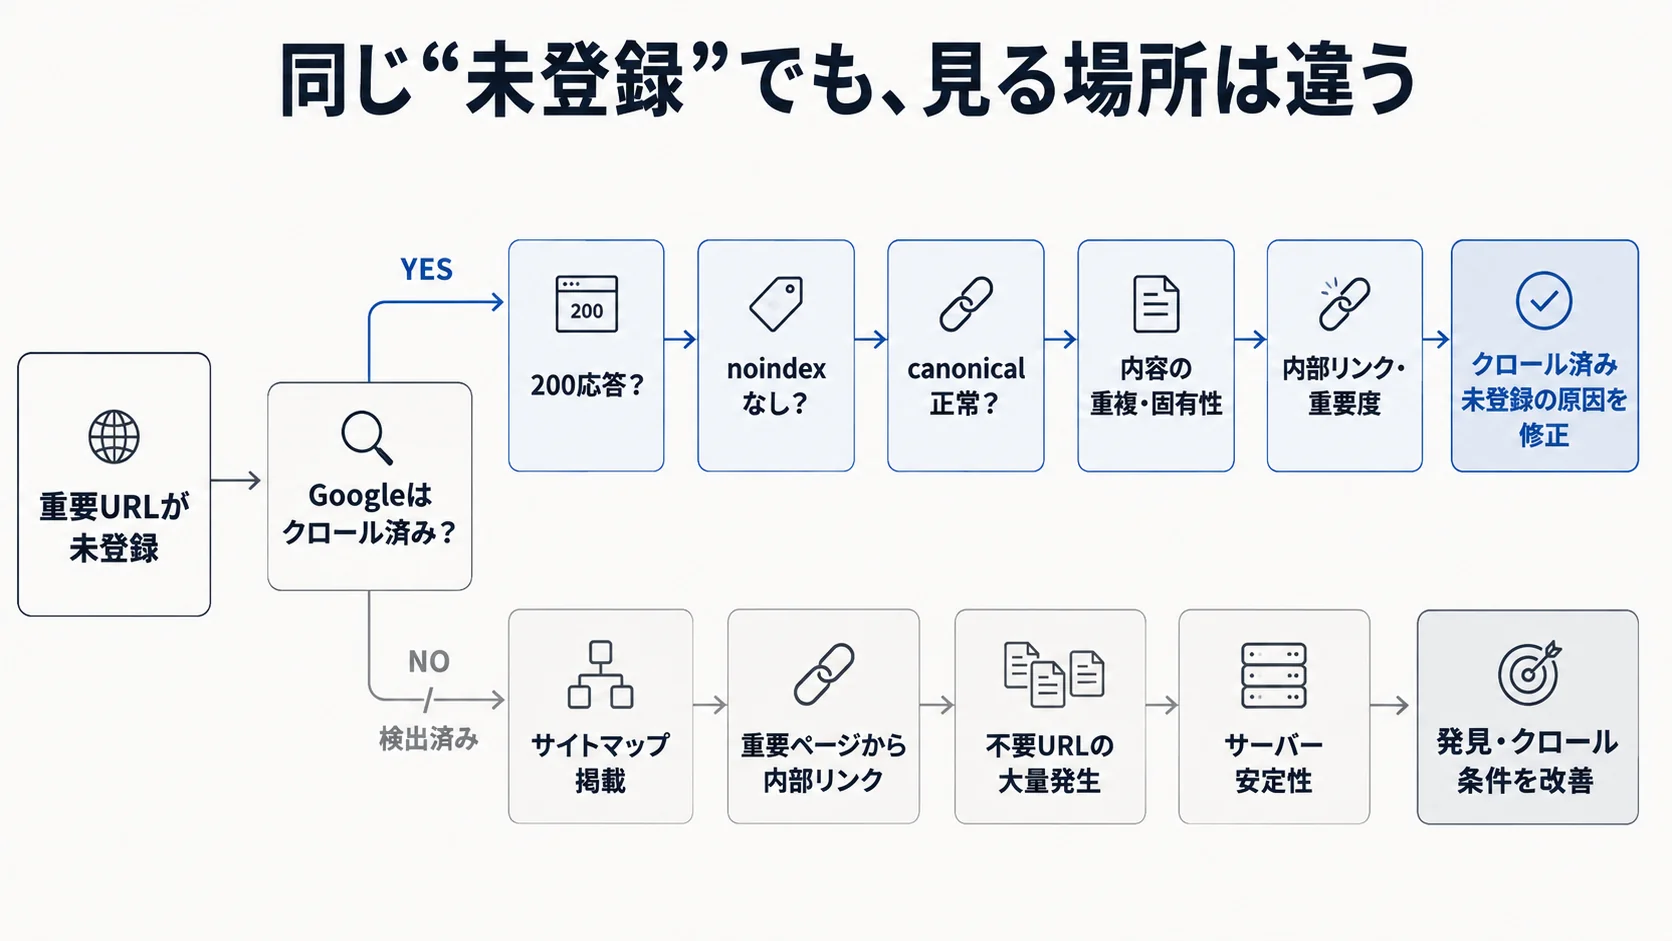
図のとおり、クロール済みならページの中身と位置づけを、検出済みならURLの発見経路とサイトの状態を見ます。
STEP7|XMLサイトマップと内部リンクの整合を確認する
この節では、サイトマップと内部リンクが、STEP1で決めた監査対象と合っているかを確認します。
サイトマップは、原則として200を返し、noindexではなく、正規URLとして扱いたい公開中ページに揃えます。404、リダイレクト元、noindex、非canonicalのURLが混ざっていれば整理します。
掲載URL・lastmod・分割・Search Consoleの送信エラーまで確認する手順は、「XMLサイトマップのSEO監査方法」で詳しく解説しています。
同時に、重要ページがサイト内からクロール可能なリンクでつながっているかも確認します。Googleは、リンクを新しいページの発見や関連性の判断に使っています。特に改善候補になるのは、次のようなケースです。
- サイトマップにはあるが、内部リンクがないURL
- カテゴリやピラー記事から辿れない重要記事
- 非canonical URLへ向く内部リンク
STEP8|修正優先順位は件数ではなく事業影響で決める
監査で原因が見えたら、原因件数の多い順ではなく、重要URLへの影響で対応順を決めます。次の表は、状態ごとの優先度と対応をまとめたものです。
| 優先度 | 状態 | 対応 |
|---|---|---|
| 最優先 | 主要LP・重要記事の誤noindex、誤canonical、クロール不可、5xx | 即時修正 |
| 高 | 重要URLのクロール済み未登録 | 重複・固有性・内部リンクを診断 |
| 高 | 重要URLの検出済み未クロール | 発見経路・URL量・サーバーを確認 |
| 中 | 非canonical URLが大量発生 | URL生成・canonical・内部リンクを整理 |
| 低 | 意図した重複・リダイレクト元・noindex URLが未登録 | 原則経過観察 |
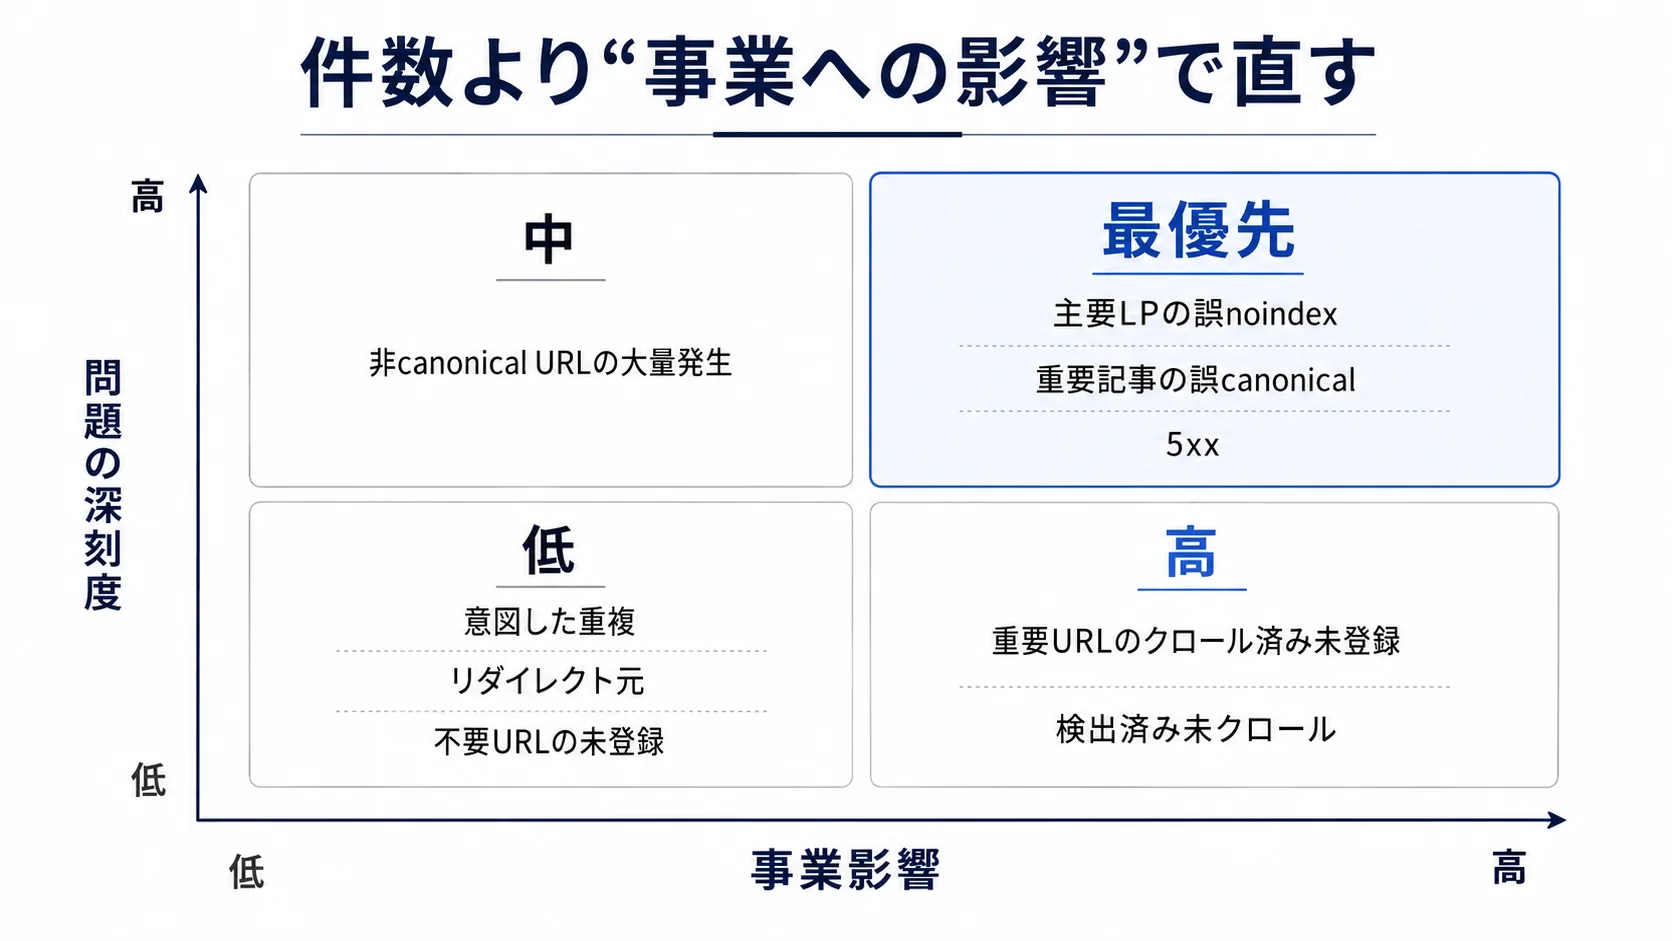
表のとおり、主要ページの誤noindexや誤canonical、クロール不可、5xxは「最優先」で、即時に修正します。重要URLの未登録は「高」、非canonical URLの大量発生は「中」です。意図した重複・リダイレクト元・noindex URLの未登録は「低」で、原則として経過観察にとどめます。図のように、未登録URLの件数ではなく、重要ページへの影響と問題の深刻度で対応順を決めます。
対応順を決めたら、監査表に記録します。監査表には、次の項目を持たせます。
- URL
- ページ種別
- インデックスさせたいか
- Search Console状態
- 原因
- 事業重要度
- 対応
- 修正日
- 再確認日
修正日と再確認日を残しておけば、同じURLを継続して追いやすくなります。
STEP9|修正後は再検証し、変化を記録する
修正しただけでは、監査は完了しません。反映の確認と再検証を、次の順で行います。
- ブラウザとHTTPレスポンスで、修正の反映を確認する
- URL検査のライブテストを実行する
- 重要URLは、必要に応じてインデックス登録をリクエストする
- ページのインデックス登録レポートと、Google選択canonicalの変化を追う
canonicalの再評価は、即時とは限りません。Googleは、重複クラスタの再評価に最大2週間程度かかる場合があると案内しています。修正日と再確認の結果は、STEP8の監査表に記録してください。
インデックス監査のチェックリスト
ここまでの手順を、点検用にまとめます。各項目の末尾にある数字は、対応するSTEPです。
- 検索結果に出したい正規URL一覧がある(STEP1)
- Search Consoleの未登録理由を分類した(STEP2)
- 重要URLをURL検査した(STEP3)
- 意図しないnoindex・robots.txt制御がない(STEP4)
- HTTPステータスと取得が正常(STEP4)
- ユーザー指定canonicalとGoogle選択canonicalを確認した(STEP5)
- クロール済み・検出済み未登録を分けて診断した(STEP6)
- サイトマップは正規URL中心になっている(STEP7)
- 重要ページが孤立していない(STEP7)
- 修正後にライブテストと再確認を行った(STEP9)
通常運用では、月次の確認を基本にします。サイトリニューアル、URL変更、CMS・テンプレート変更、大量公開の後は追加で監査すると、異常を早く発見できます。
まとめ
SEOのインデックス監査では、未登録URLをゼロにすることではなく、「検索結果に出したい正規URLが登録されているか」を確認します。
未登録の原因を調べるときは、まず監査対象を決め、Search Consoleで未登録理由を分類します。重要URLはURL検査で調べ、noindex、robots.txt、HTTPステータス、canonical、重複、サイトマップ、内部リンクの順に原因を切り分けます。
修正優先順位は、件数ではなく事業影響で決めてください。必要なページが正しく登録され、不要URLが意図どおり除外されている状態を維持することが、インデックス監査のゴールです。
最初の一歩は、検索結果に出したい正規URLの一覧を作ることです。Search Consoleを開く前に、STEP1からそろえてください。
参考文献・データ元
この記事で参照した情報を確認できます。
- Google Search Console ヘルプ「ページ インデックス登録レポート」
- Google Search Console ヘルプ「URL 検査ツール」
- Google Search Central「サイトマップの作成と送信」
- Google Search Central「What is URL Canonicalization」
- Google Search Central「Fix Canonicalization Issues」
- Google Search Central「noindex を使用してコンテンツをインデックスから除外する」
- Google Search Central「Google のリンクに関するベスト プラクティス」
‹ 親記事: テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト
このテーマの記事
関連記事
- › INDEX削除(インデックス削除)とは?検索結果から消える仕組みと対処法
- › Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け
- › SEO内部リンクの確認方法|孤立ページ・深度・アンカー偏りを改善
- › JavaScript SEOの確認方法|表示・内部リンク・登録状況
- › クロールバジェットの確認方法|無駄なクロールと改善優先度
- › 構造化データの確認方法|エラー・本文との不一致・重複を検証
- › 多言語ページの言語・地域指定を確認|相互参照・正規URLをチェック
- › 絞り込み検索のSEO確認方法|URL増加・クロール・重複を防ぐ
- › SEOリダイレクトの確認方法|多段転送・ループ・誤転送を検出
- › robots設定のSEO確認方法|クロール許可と登録制御の矛盾を確認
- › ページネーションのSEO確認方法|正規URL・内部リンク・クロール
- › サイト移行後のSEO確認方法|転送・正規URL・順位変動を確認
- › 404・soft 404のSEO確認|リンク切れ・消失URLを修正
- › SEOリリース前チェックの作り方|noindex・canonical・robots・リダイレクトの事故を防ぐ
- › 画像SEOの確認方法|alt・画像URL・遅延読み込みを確認
- › 求人ページの構造化データを確認|給与・勤務地・期限の不一致
- › サイト内検索ページのSEO確認|noindex・クロール・重複URL
- › サイトリニューアルでSEO評価を落とさない移行方法|URL・301・計測・公開手順
- › サービス終了ページは削除すべき?301・404/410・残す場合のSEO判断基準
- › SEOに強いURL・ディレクトリ設計|階層・命名・変更時の注意点
- › サブディレクトリとサブドメインの違い|SEO・運用の判断基準
- › リッチリザルトとは?種類・構造化データ・表示確認方法を解説
- › Google Search Consoleとは?登録方法と最初に見る4つの指標