ブラウザで見ると正常なのに、ページが検索結果に出てこない。新しいページへの内部リンクが、Googleに見つけてもらえない。こうした問題は、JavaScriptを実行した後にだけ本文やリンクが現れるサイトで起こり得ます。
原因を探すときは、画面を目視するだけでは足りません。同じURLについて、①サーバーが返す初期HTML、②JavaScript実行後のHTML/DOM、③Googleが取得した状態、④実際のインデックス結果の4つを比べると、どの段階で情報が失われたかが分かります。これがJavaScript SEO監査の結論です。
本記事では、差分の取得、原因の切り分け、SSR・SSG・CSRの選択、修正後の検証までを7ステップで整理します。SSRはサーバー側でHTMLを作る方式、SSGはあらかじめHTMLを作っておく方式、CSRはブラウザ側で画面を組み立てる方式です。この手順を使えば、SEO担当者と開発担当者が、修正の対象と優先順位を共通の証拠で決められます。
JavaScript SEOの確認は、4つの状態の比較から始める
この節では、確認の軸になる4つの状態と、差分の見方を決めます。JavaScript SEO監査では、「ユーザーに見えるか」だけで合否を決めません。サーバー応答、ブラウザでの描画、Googleの取得結果、検索インデックスの4つの状態を比べ、どこで情報が失われたかを特定します。
この比較が必要な理由は、Googleの処理にあります。Google Search Centralは、JavaScriptページをクロール(ページの巡回と取得)、レンダリング(JavaScriptを実行して表示を組み立てる処理)、インデックス(検索エンジンへの登録)の3段階で処理すると説明しています。Googlebotは最初のHTMLからリンクを抽出し、レンダリング後のHTMLからも内容とリンクを抽出します。そのため、初期HTMLに主要情報がなくても、必ず失敗するわけではありません。一方で、JavaScriptやAPIのエラー、robots.txtによるリソースの遮断、ユーザー操作が必要な表示は、レンダリング後にも残らない可能性があります。
4つの状態で何を確認し、どう取得し、差から何が分かるかを、次の表にまとめます。
| 比較する状態 | 確認するもの | 主な取得方法 | 差が示す問題 |
|---|---|---|---|
| 初期HTML | 本文、title、canonical、robots、href | curl、ブラウザのソース表示 | JavaScriptへの依存範囲 |
| レンダリング後HTML/DOM | 実行後の本文、リンク、構造化データ | Chrome DevTools、レンダリング対応クローラー | JS・API・遅延表示の失敗 |
| Google取得状態 | クロール済みHTML、スクリーンショット、取得エラー | Search ConsoleのURL検査 | Google環境固有の差 |
| インデックス結果 | 登録可否、選択canonical、検索上の表示 | URL検査、ページのインデックス登録 | 技術要因と品質要因の最終結果 |
表を使うときは、DOM全体の差分量ではなく、検索に必要な情報がどの段階で失われたかを見ます。差があること自体は、直ちに不合格の理由にはなりません。実行後にclassや計測タグが加わるだけなら、SEO上の優先度は高くありません。広告やチャットなど、検索に不要な要素の差も低優先です。
優先して確認するのは、H1、主要本文、商品・サービス情報、内部リンク、canonical、robots、構造化データです。これらが初期HTMLとレンダリング後で変わっている場合は、クロール、URL発見、インデックス、ページ理解に影響するおそれがあります。判断の基準は、差の有無ではなく、その差が検索への影響につながるかどうかです。
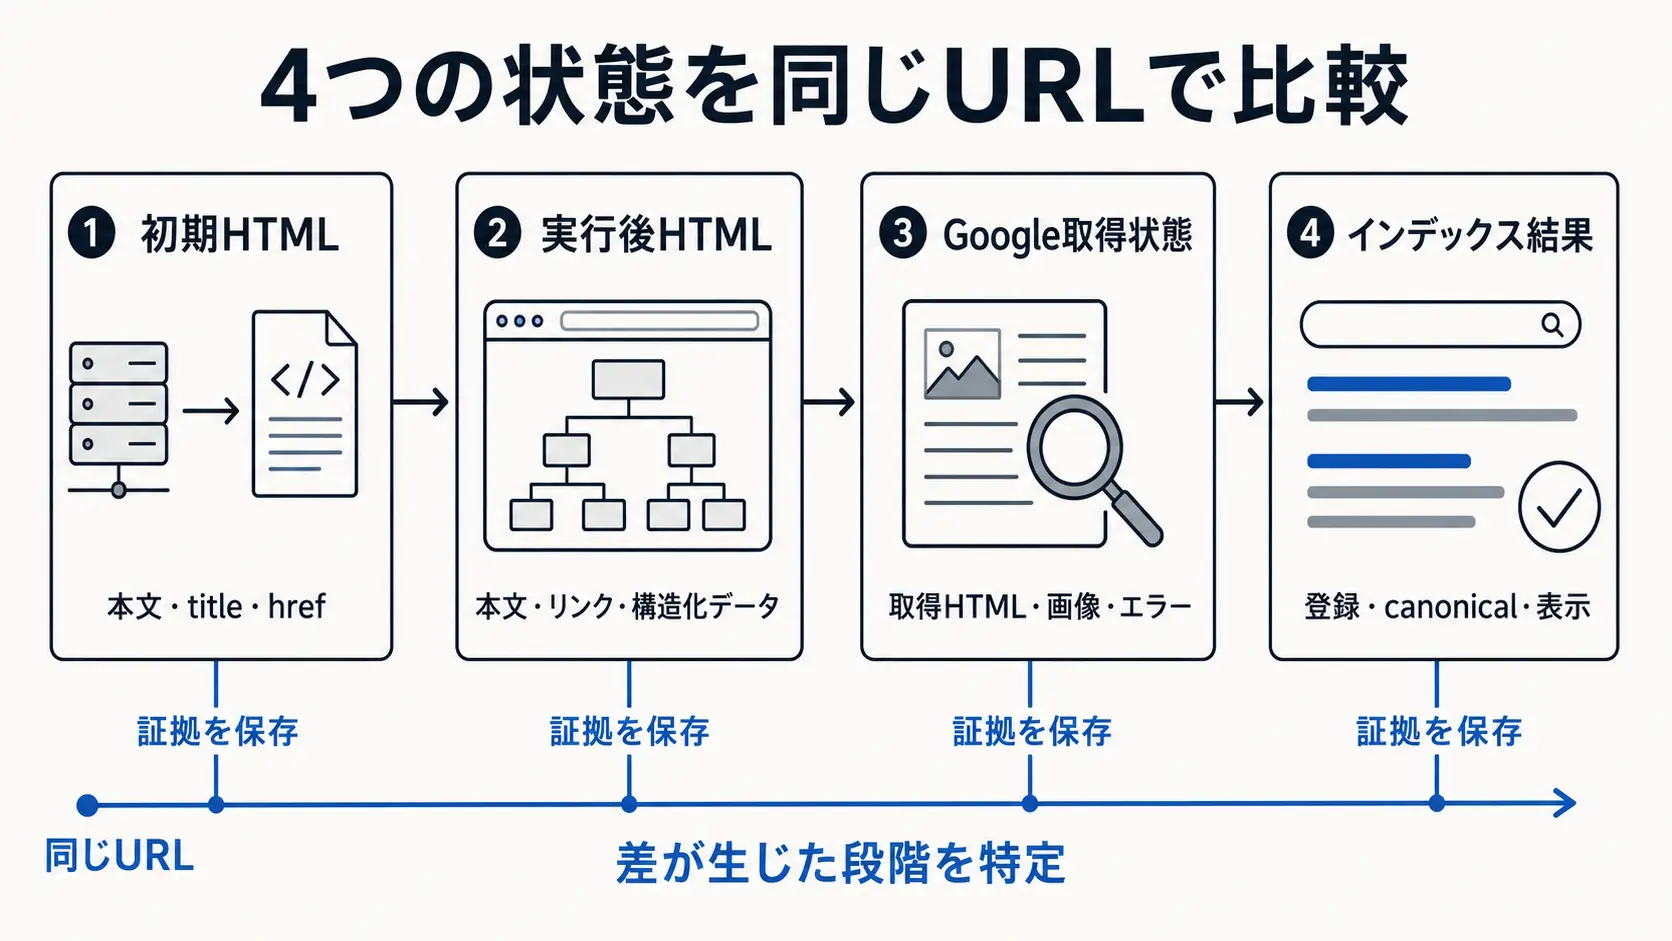
同じURLの4つの状態を保存して比べると、情報が失われた段階を切り分けられます。
監査前に対象URLと合格条件を決める
全URLを無差別に確認するより、ページの型(テンプレート)と重要度で分けて代表URLを選ぶ方が、短時間で再現性の高い監査になります。少なくとも、トップ、カテゴリ、詳細、記事、検索・絞り込み、404の各テンプレートから、正常系と例外系を選びます。
選んだURLは、監査表に記録します。記録する項目は、URL、ページ種別、想定ステータスコード、インデックス可否、正規URL、主要本文、必須内部リンク、構造化データ種別です。ECサイトなら、在庫あり・在庫なし、ページネーション、絞り込み条件も分けます。SPAなら、直リンクで開いた場合と、画面内遷移で開いた場合を比較してください。
合格条件は、「表示された」ではなく、証拠で判定できる形に落とします。次の7つが、代表URLごとの基本の条件です。
- 主要本文がレンダリング後HTMLに存在する
- インデックス対象URLがHTTP 200を返す
- 移動・削除・エラーURLが意図した3xx・4xxを返す
- 重要ページへのリンクが
<a href="...">として抽出できる - title、canonical、robotsの初期値と実行後の値が矛盾しない
- Search ConsoleのURL検査で必要なリソースが読み込まれる
- 公開URLとGoogleが選択したcanonicalが意図どおり一致する
JavaScript SEOの確認を7ステップで進める
監査は、発見、取得、レンダリング、インデックスの順に進めます。後工程だけを見ると、原因がJavaScriptなのか、canonicalや品質評価なのかを切り分けにくくなるためです。
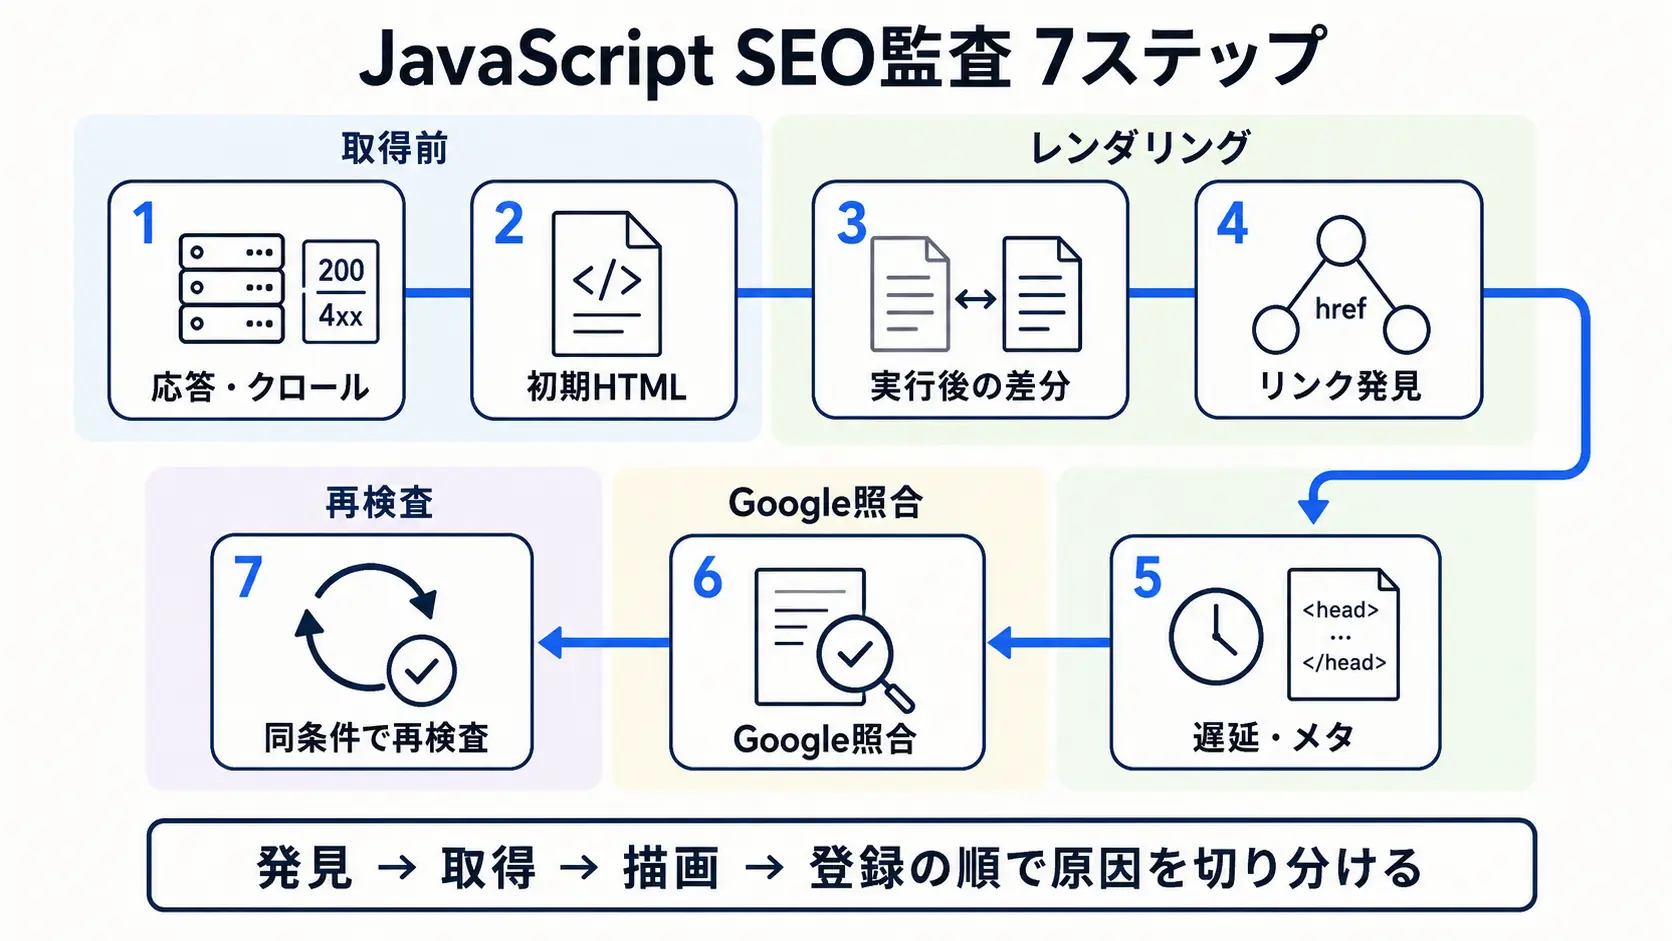
7ステップは、取得前の条件確認から始め、レンダリング差分、Googleの取得結果、修正後の再検査へ進みます。この順に進めると、原因の混同を防げます。
STEP1|HTTP応答とクロール可否を確認する
最初に、対象URLのHTTPステータス、リダイレクト、robots.txt、robots meta、X-Robots-Tagを確認します。Googleは通常、HTTP 200のページをレンダリング対象へ送ります。エラー表示のページが常に200を返すと、ページがないのに正常と答えている状態、いわゆるsoft 404として扱われる可能性があります。CSRのサイトでは、特に注意が必要です。
JavaScriptやCSSのURLをrobots.txtで遮断すると、Googleがページを正しく再現できません。HTML本体だけでなく、主要なJS、CSS、APIの応答も確認します。認証、Cookie、Local Storage、WebSocketなどに依存しないと主要本文が出ない設計も、要注意です。
STEP2|初期HTMLに何があるか取得する
curlや「ページのソースを表示」で、JavaScript実行前のHTMLを保存します。本文文字列、H1、title、meta description、canonical、robots、構造化データ、主要リンクを抽出してください。
この工程の目的は、CSRを一律に否定することではありません。検索に不可欠な情報のうち、何がレンダリングに依存しているかを可視化することです。売上や問い合わせに直結するページほど、主要本文と発見経路を初期HTMLに含める設計が安全です。
STEP3|レンダリング後HTML/DOMとの差分を取る
ヘッドレスブラウザやJavaScriptレンダリング対応クローラーで、実行後のDOMを取得します。初期HTMLと比較し、追加・削除・書き換えを分類します。分類の目安は、次の表の原因候補と判定です。
| 差分 | 主な原因候補 | 判定 |
|---|---|---|
| 本文が追加されない | API失敗、例外、タイムアウト、認証依存 | 重大 |
| SSR本文が実行後に消える | hydration不整合、クライアント側の上書き | 重大 |
| canonicalが別URLへ変わる | ルーターやhead管理の競合 | 重大 |
| 主要リンクがクリック後だけ現れる | イベント・スクロール依存 | 重大 |
| 構造化データの値が本文と不一致 | データ取得時点やテンプレートの差 | 高 |
| 広告やチャットだけが増える | 補助機能 | 低 |
差分比較は、DOM全体の行数ではなく、検索に必要な要素単位で行います。日時、セッションID、計測属性などの変動値を除外すると、回帰テストへ再利用しやすくなります。
初期HTMLとレンダリング後HTMLを比べるときは、検索上重要な要素を項目別に記録すると判断しやすくなります。次の表は、その記録のイメージです。
| 要素 | 初期HTML | レンダリング後 | 確認ポイント |
|---|---|---|---|
| title | あり | 変更 | 意図したtitleへ変わっているか |
| H1 | なし | あり | JavaScript依存になっていないか |
| 主要本文 | 一部 | 全文 | Google取得結果にも全文があるか |
| 内部リンク | 10本 | 35本 | 重要URLがJS生成だけになっていないか |
| canonical | あり | 書き換え | 正規URLが矛盾していないか |
| robots | index | noindex | 意図しない変更がないか |
| 構造化データ | なし | あり | Google側でも取得できるか |
この表では、初期HTMLとレンダリング後で値が変わっている行が、すべて確認の対象です。なかでも、robotsがindexからnoindexに変わる場合や、重要な内部リンクが実行後にしか現れない場合は、優先して確認します。
STEP4|内部リンクとURL発見を確認する
Googleが確実に解析しやすいリンクは、href属性を持つ<a>要素です。onclickだけの要素、ボタンだけの画面遷移、hrefのないアンカーは、重要URLの発見経路として扱わない方が安全です。
リンクの確認では、初期HTMLのクロールとレンダリング後のクロールを別々に行い、発見URL数とリンク元数を比べます。抽出するのは、次の3つです。
- XMLサイトマップにあるのに、内部リンクから到達できないURL
- レンダリング後にしか発見できない重要URL
- ユーザー操作の後にだけ現れるリンク
SPAでは、各画面に固有のURLを与え、フラグメントだけで本文を切り替える設計を避けます。History APIを利用しても、最終的なリンク要素には通常のURLを持つhrefが必要です。そのURLへ直接アクセスした場合にも、同じ主要内容と正しいステータスコードが返ることを確認します。
特に大規模サイトでは、次のリンクが初期HTMLとレンダリング後HTMLのどちらに存在するかを比べてください。
- カテゴリから商品・詳細ページへのリンク
- 一覧から詳細ページへのリンク
- パンくず
- ページネーション
- 関連記事
- グローバルナビゲーション
- サイト内の重要ページへの導線
重要ページへのリンクがJavaScript実行後にしか存在しない場合は、URL発見がレンダリングに依存している状態として記録します。
STEP5|メタ情報と、操作しないと現れない内容を確認する
このステップでは、メタ情報の変化と、ユーザー操作が前提の表示を確認します。まずメタ情報です。title、meta description、canonical、robotsは、初期HTMLとレンダリング後HTMLの両方で確認します。特に、初期HTMLのnoindexをJavaScriptで削除する方法は避けます。Googleはnoindexを確認するとレンダリングを省略する場合があり、削除処理が実行されない可能性があるためです。
操作しないと表示されないコンテンツはないか
JavaScriptを実行すれば表示されることと、Googleが同じ表示条件を満たせることは別です。SEO監査では、クリックやスクロール、同意操作などのユーザー操作を行わない状態でも、重要な本文やリンクを取得できるか確認します。
特に確認したいのは、次のケースです。
- 「もっと見る」を押さないと商品や記事が追加されない
- タブをクリックしないと重要本文が生成されない
- スクロール後に初めて本文を取得する
- ユーザー操作後に内部リンクを生成する
- Cookieや認証後のAPI処理を前提に主要本文を表示する
ブラウザ上で最終的に表示できるだけでは合格とせず、操作なしのレンダリング結果とGoogleの取得結果の両方を確認してください。
lazy loadingは「ユーザー操作なしで取得できるか」を確認する
lazy loadingそのものを、SEO上の問題と判断する必要はありません。確認するのは、検索に必要な画像やコンテンツが、特定のユーザー操作に依存していないかどうかです。そのため、「スクロールした人だけに読み込む」実装と、ブラウザのビューポートを基準に読み込む一般的なlazy loadingは分けて評価します。
確認する項目は、次のとおりです。
- レンダリング後HTMLに対象の画像URLが存在するか
img要素のsrcとしてURLを取得できるか- Search ConsoleのURL検査で画像や本文を確認できるか
- スクロールイベントだけを読み込み条件にしていないか
- lazy loadされた要素がGoogle取得結果にも存在するか
画像の遅延読み込みと、本文・リンクの遅延生成は分けて評価してください。
STEP6|Googleの取得結果とインデックスを照合する
Search ConsoleのURL検査で、登録済みの状態とライブテストを確認します。記録するのは、クロール可否、取得結果、インデックス可否、Googleが選択したcanonical、レンダリング済みHTML、スクリーンショット、読み込めなかったリソースです。
ただし、ライブテストの合格はインデックス登録を保証しません。ライブテストは現在の取得可能性を確認するもので、重複、品質、サイト全体の評価など、登録時の全条件を判定するものではないからです。そのため、重要テンプレートごとに「技術的に取得可能」と「実際に登録済み」を分けて管理します。
初期HTMLとブラウザのレンダリング結果で問題が見つからなくても、Google取得結果で主要本文・リンク・画像が欠落している場合は、Google環境でのJavaScript実行やリソース取得を原因候補として切り分けます。
STEP7|修正後に同じ条件で再検査する
修正前後で、URL、ユーザーエージェント、端末、待機条件、Cookie状態をそろえます。そのうえで、初期HTML、レンダリング後HTML、抽出リンク、HTTP応答、Search Consoleの結果を再取得し、重大な差分が解消したことを確認します。
公開後は、テンプレート単位の自動テストへ組み込みます。主要本文の文字列、canonical、robots、HTTPステータス、必須リンクが失われた場合に、リリース前または直後に検知できる状態が理想です。
ページの状態に応じて、修正方法を選ぶ
すべてのJavaScriptサイトをSSRへ移行する必要はありません。ページの更新頻度、公開範囲、個別URLの必要性、障害時の影響を基準に、ルート単位でSSR、SSG、CSRを選びます。次の表は、状態ごとの第一候補と注意点です。
| 状態 | 第一候補 | 理由・注意点 |
|---|---|---|
| 公開記事・サービスページ | SSGまたはSSR | 主要情報とリンクを初期HTMLで返しやすい |
| 頻繁に変わる公開商品ページ | SSRまたは再生成型の静的出力 | 鮮度と取得安定性を両立しやすい |
| ログイン後の管理画面 | CSR | 通常は検索対象外で、操作性を優先できる |
| 既存CSRをすぐ移行できない | 一時的なプリレンダリング | 同等内容を返し、恒久策の期限を決める |
| JS実行後にSSR本文が消える | hydration修正 | レンダリング方式の変更前に不整合を直す |
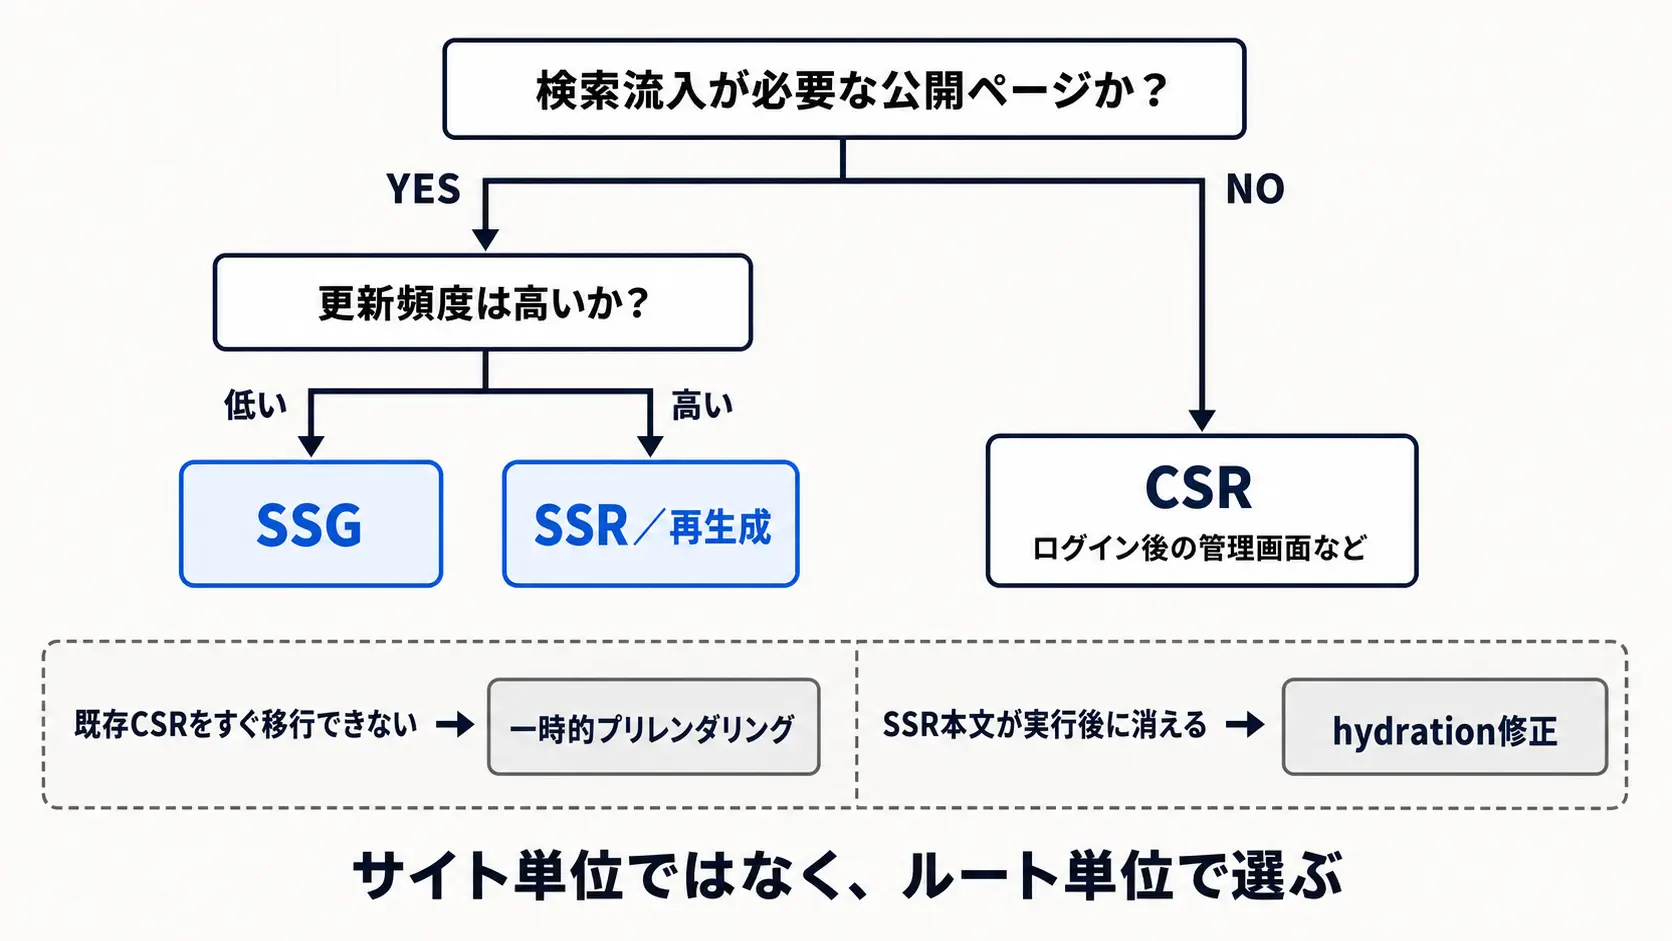
検索流入の必要性と更新頻度を基準に、ページやルートごとにレンダリング方式を選びます。
なお、Googleは、クローラー向けに別のHTMLを返す動的レンダリングを回避策と位置付け、長期的な解決策としては推奨していません。新規開発や大規模改修では、サーバーサイドレンダリング、静的レンダリング、hydrationなどを検討します。
一方、検索が不要な管理画面まで、SSRにする必要はありません。公開URLのうち、検索流入を獲得するページと、そこへつながるリンクを優先します。
修正の優先順位は、影響範囲と検索への重大度で決める
優先順位は、個別URLの順位ではなく、テンプレートの影響範囲、検索に必要な要素、発生頻度、修正難易度で決めます。同じ不具合が数千URLへ展開されるテンプレート問題は、単一ページの表示崩れより先に対応します。次の表は、優先度ごとの状態と対応例です。
| 優先度 | 状態 | 対応例 |
|---|---|---|
| P0 | 主要テンプレートの本文が取得不能、誤noindex、重大な5xx | リリース停止、即時ロールバック |
| P1 | canonical競合、重要リンク消失、soft 404の大量発生 | 次回リリースを待たず修正 |
| P2 | 構造化データ欠落、補助本文の遅延表示、少数URLの差 | スプリント内で修正 |
| P3 | 検索に不要な装飾差分、低重要URLの軽微な差 | 記録して定期改修 |
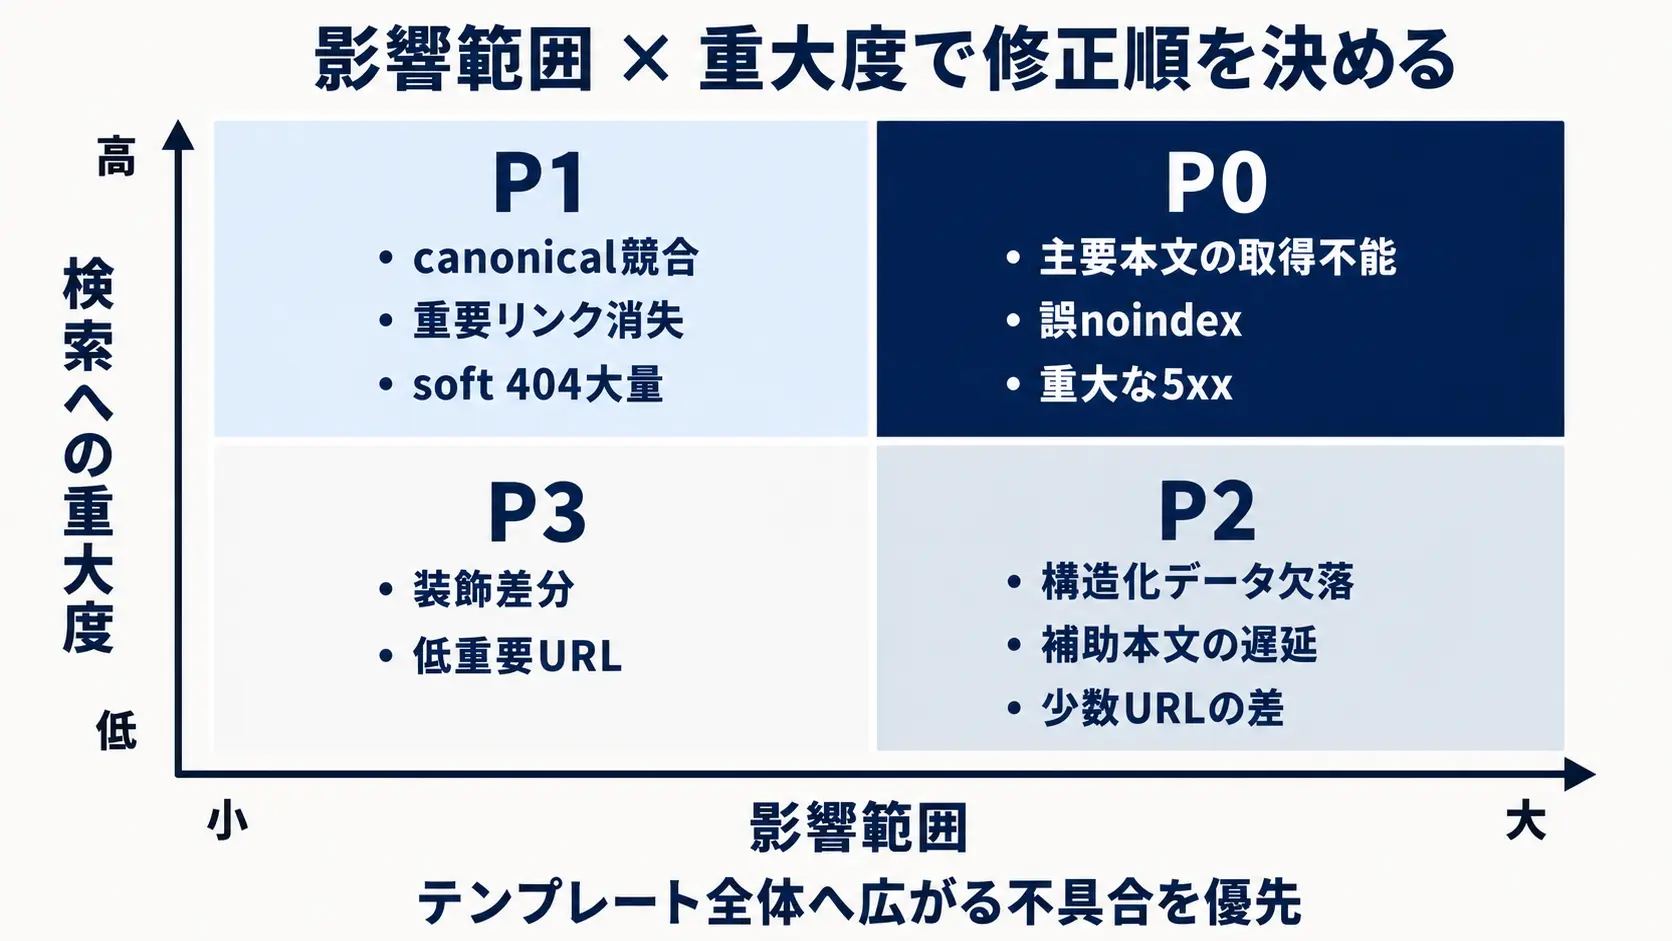
影響URLが多く、主要本文やインデックス制御に影響する不具合ほど、優先して修正します。
担当分担も明確にします。SEO担当者は対象URL、期待値、検索影響を定義し、開発担当者は再現条件と技術原因を記録します。QA担当者は同一条件で再検査し、承認者が公開可否を判断します。「GooglebotはJavaScriptを実行できる」という説明だけで閉じず、対象URLの取得証拠を完了条件にしてください。
JavaScript SEOの最終チェックリスト:13項目をテンプレートごとに確認する
次の項目をテンプレートごとに確認すると、監査漏れを抑えられます。
- [ ] インデックス対象URLがHTTP 200を返す
- [ ] エラーURLが意図した4xxを返す
- [ ] 主要なJS・CSS・APIがGooglebotから取得可能である
- [ ] 初期HTMLと実行後HTMLの主要本文を比較した
- [ ] H1、title、canonical、robotsの差を比較した
- [ ] 重要リンクが
<a href>として存在する - [ ] 直接アクセスと画面内遷移で同じ主要内容が出る
- [ ] クリックやスクロールなしで主要本文とリンクを取得できる
- [ ] Search Consoleでレンダリング済みHTMLを確認した
- [ ] Googleが選択したcanonicalを確認した
- [ ] 実際のインデックス結果とライブテストを分けて記録した
- [ ] 修正前後を同じ条件で再検査した
- [ ] 代表URLの検査をデプロイ後の回帰確認へ組み込んだ
まとめ:まず代表URLで4つの状態を比べる
JavaScript SEO監査では、初期HTML、レンダリング後HTML、Googleの取得状態、インデックス結果を、同じURLで比較します。重点項目は、主要本文、<a href>による内部リンク、HTTPステータス、canonical、robots、遅延表示です。
このテーマの全体像や前提を確認したい場合は、「テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト」もあわせて確認してください。
最初の一歩は、代表URLをテンプレート別に選び、7ステップで差分を取得することです。問題が見つかったら、ページの公開性と更新頻度に応じてSSR・SSG・CSRを使い分けます。修正完了は、ブラウザの目視ではなく、同一条件での再取得とSearch Consoleの実測で判定します。これにより、SEO担当者と開発担当者が、推測ではなく証拠で優先順位を決められます。
参考文献・データ元
この記事で参照した情報を確認できます。
- Google Search Central「Understand the JavaScript SEO basics」(2026年3月4日更新)https://developers.google.com/search/docs/crawling-indexing/javascript/javascript-seo-basics — クロール・レンダリング・インデックスの処理、リンク抽出、canonical、robots、ステータスコードの確認に使用。
- Google Search Central「Fix Search-Related JavaScript Problems」(2025年12月10日更新)https://developers.google.com/search/docs/crawling-indexing/javascript/fix-search-javascript — URL検査、レンダリング環境、リソース取得とデバッグ条件の確認に使用。
- Google Search Central「SEO Link Best Practices for Google」https://developers.google.com/search/docs/crawling-indexing/links-crawlable —
a要素とhref属性を用いたクロール可能なリンクの条件確認に使用。 - Google Search Central「Dynamic Rendering as a workaround」(2025年12月10日更新)https://developers.google.com/search/docs/crawling-indexing/javascript/dynamic-rendering — 動的レンダリングの位置付けと代替方式の確認に使用。
- Google Search Console ヘルプ「URL Inspection tool」https://support.google.com/webmasters/answer/9012289 — 登録済みURL、ライブテスト、レンダリング結果の確認範囲に使用。
‹ 親記事: テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト
関連記事
- › INDEX削除(インデックス削除)とは?検索結果から消える仕組みと対処法
- › Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け
- › SEO内部リンクの確認方法|孤立ページ・深度・アンカー偏りを改善
- › ページがインデックスされない原因は?Search Consoleで未登録・除外・重複URLを確認
- › クロールバジェットの確認方法|無駄なクロールと改善優先度
- › 構造化データの確認方法|エラー・本文との不一致・重複を検証
- › 多言語ページの言語・地域指定を確認|相互参照・正規URLをチェック
- › 絞り込み検索のSEO確認方法|URL増加・クロール・重複を防ぐ
- › SEOリダイレクトの確認方法|多段転送・ループ・誤転送を検出
- › robots設定のSEO確認方法|クロール許可と登録制御の矛盾を確認
- › ページネーションのSEO確認方法|正規URL・内部リンク・クロール
- › サイト移行後のSEO確認方法|転送・正規URL・順位変動を確認
- › 404・soft 404のSEO確認|リンク切れ・消失URLを修正
- › SEOリリース前チェックの作り方|noindex・canonical・robots・リダイレクトの事故を防ぐ
- › 画像SEOの確認方法|alt・画像URL・遅延読み込みを確認
- › 求人ページの構造化データを確認|給与・勤務地・期限の不一致
- › サイト内検索ページのSEO確認|noindex・クロール・重複URL
- › サイトリニューアルでSEO評価を落とさない移行方法|URL・301・計測・公開手順
- › サービス終了ページは削除すべき?301・404/410・残す場合のSEO判断基準
- › SEOに強いURL・ディレクトリ設計|階層・命名・変更時の注意点
- › サブディレクトリとサブドメインの違い|SEO・運用の判断基準
- › リッチリザルトとは?種類・構造化データ・表示確認方法を解説
- › Google Search Consoleとは?登録方法と最初に見る4つの指標