「公開したはずのページが検索結果に出ない」「noindexを外したのにインデックスされない」といった問題は、robots.txt(クローラーのアクセスを制御するファイル)だけを見ても原因を特定できません。robots.txt、meta robots、X-Robots-Tag、XMLサイトマップをURL単位で突き合わせる必要があるためです。
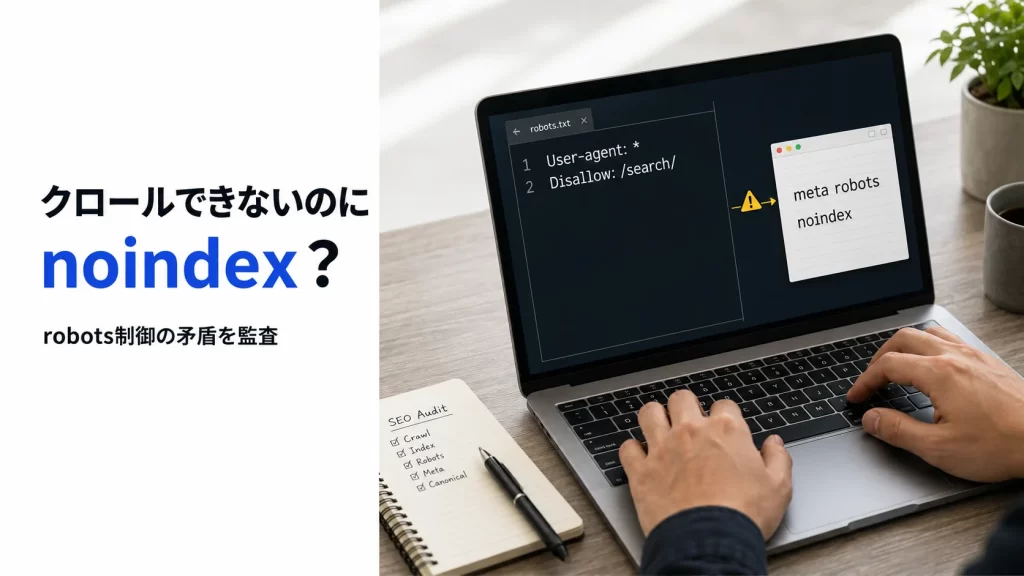
特に見落としやすいのが、robots.txtでクロールを拒否しながら、同じURLへnoindexを設定している状態です。クロールとは、検索エンジンがページを巡回して内容を取得することです。Googleがnoindexを認識するには対象URLをクロールできなければならないため、この組み合わせでは意図したインデックス制御にならないことがあります。
監査の基本は、クロールの可否とインデックス登録(検索エンジンにページ情報が登録されること)の可否を分けて見ることです。そのうえで、URLごとに「期待する状態」と「実際の設定」を照合し、重要なURLの誤ブロックやnoindexの残存から順に直します。
この記事では、robots.txt、meta robots、X-Robots-Tagによる制御を「robots制御」と呼び、XMLサイトマップはその制御と突き合わせる対象として扱います。マーケティング担当者がサイト全体のrobots制御を監査し、「どのURLをクロールさせ、どのURLを検索結果に出すのか」をURL群ごとに整理して、矛盾の発見から修正後の確認までを進める方法を解説します。
関連する全体像や前提は「テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト」で整理しています。
まず「クロールできるか」と「インデックス登録してよいか」を分けて確認する
robots制御を監査するときは、最初に「Googlebot(Googleのクローラー)がURLを取得できるか」と「取得したURLをインデックスに登録してよいか」を分けて考えます。robots.txtとmeta robots・X-Robots-Tagは、この2つの問いのどちらを担当するかで役割が分かれます。XMLサイトマップは、クロールとURL発見の補助です。
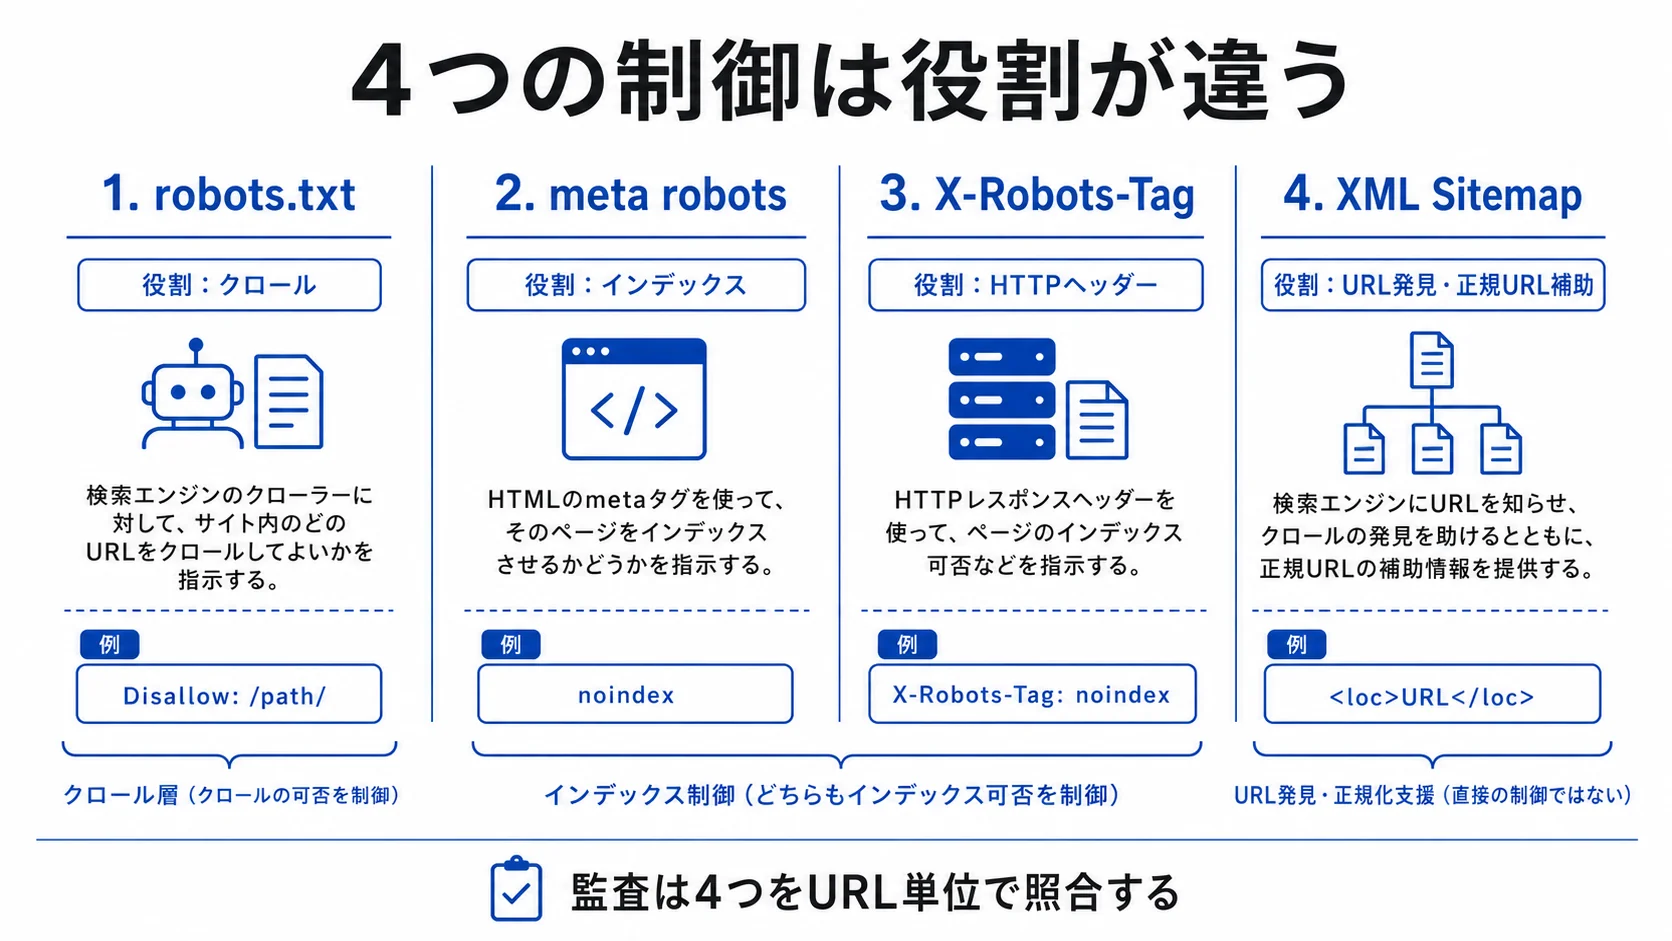
robots.txtは主にクロールの可否を制御する仕組みで、meta robotsとX-Robots-Tagのnoindexはインデックス登録を制御します。Googleもrobots.txtについて、ページをGoogle検索から除外するための仕組みではないと説明しています。このため、監査では4つを別々に見るのではなく、同じURL単位で照合します。
4つの役割と、監査で見る点は次の表のとおりです。設定する単位が違うため、確認する場所も異なります。
| 制御方法 | 主な役割 | 設定単位 | 主な監査ポイント |
|---|---|---|---|
| robots.txt | クロール可否 | URLパス・クローラー | 重要URLを誤ってDisallowしていないか |
| meta robots | インデックス・検索結果表示制御 | HTMLページ | noindexが意図せず残っていないか |
| X-Robots-Tag | インデックス・検索結果表示制御 | HTTPレスポンス | PDF等やサーバー設定にnoindexが残っていないか |
| XMLサイトマップ | クロール・正規URL発見の補助 | URL一覧 | 検索結果に出したくないURLを送信していないか |
meta robotsはHTMLページに書く設定です。PDFや画像などHTMLにrobots metaタグを設定できないリソースについては、GoogleがX-Robots-Tagを利用できると案内しています。PDFなどのnoindexはHTMLを見ても分からないため、HTTPレスポンスで確認します。
「robots.txtでブロック+noindex」の矛盾から確認する
robots制御で特に注意したいのが、robots.txtによってクロールできないURLへnoindexを設定しているケースです。確認の順番としてはここから取り上げますが、修正の順番は、後述のとおり検索への影響度とURL数で決めます。
Googleがmeta robotsやX-Robots-Tagを認識するには、URLをクロールしてHTMLまたはHTTPレスポンスを取得する必要があります。robots.txtで取得を拒否すると、Googlebotはそのnoindexを確認できません。
たとえば、robots.txtに次の設定があるとします。
User-agent: *
Disallow: /search/同時に/search/配下のHTMLへ次の設定がある状態です。
<meta name="robots" content="noindex">「クロールもインデックスも禁止しているので安全」と考えやすい組み合わせですが、Googleはrobots.txtによってHTMLを取得できないため、noindexを確認できません。下の図は、この仕組みを示したものです。
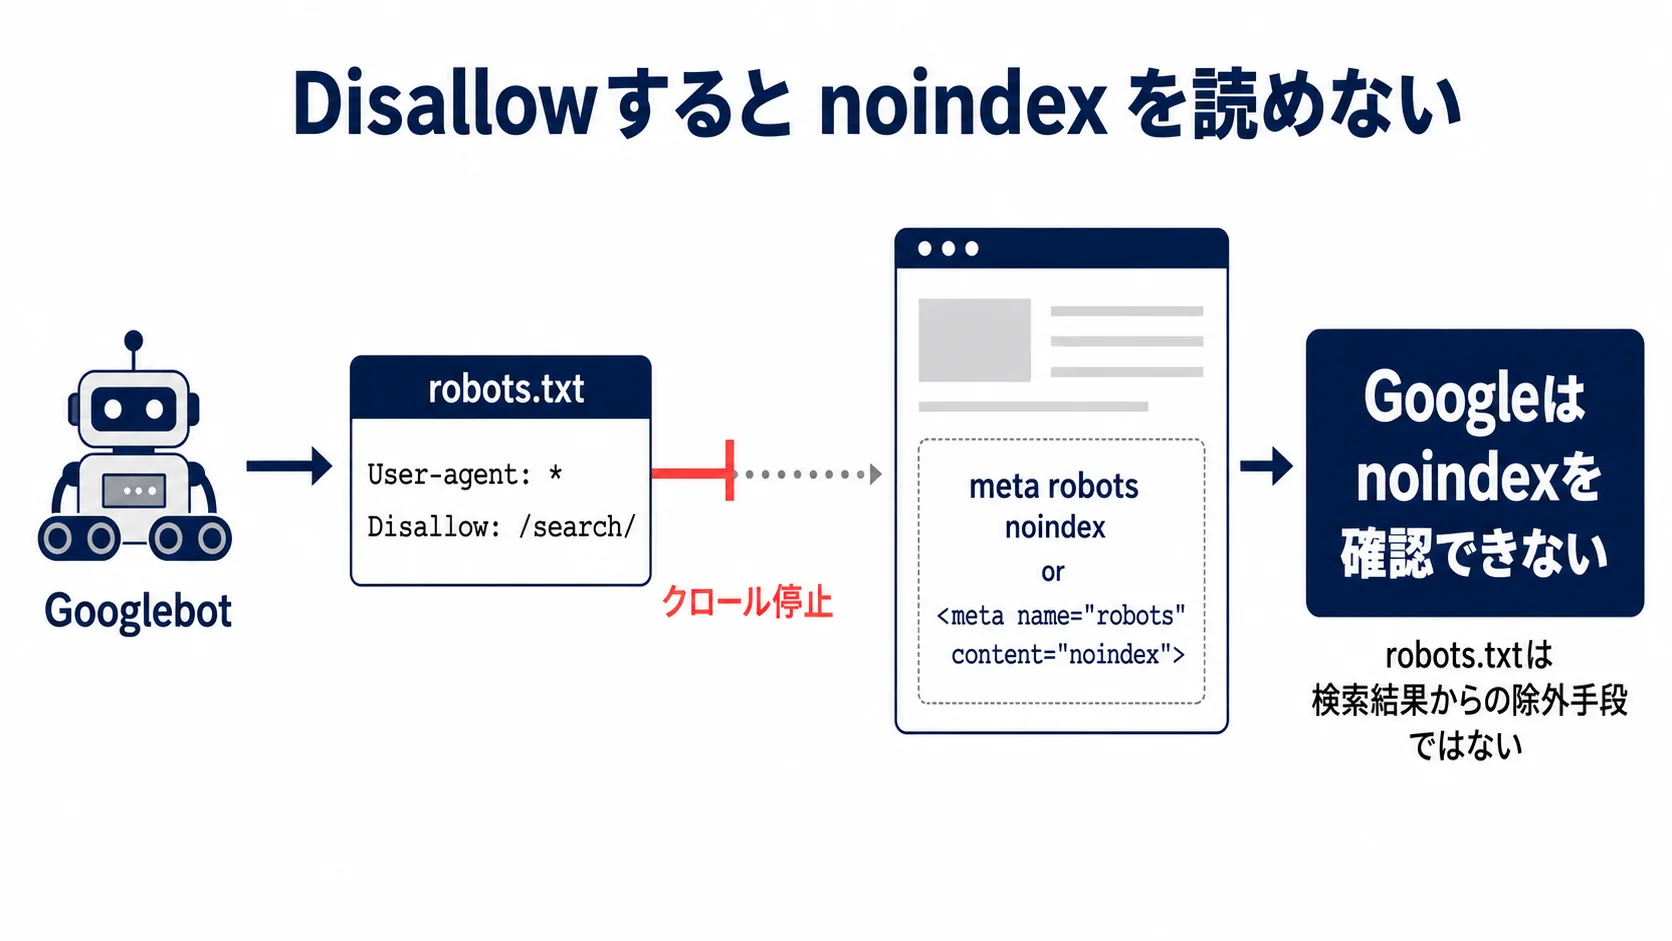
外部ページなどからURLの存在を認識した場合には、robots.txtでブロックされたURLそのものが検索結果に現れる可能性もあります。Google Search Consoleも、robots.txtはクロール制御に使い、検索結果への表示を避ける目的ではnoindexを利用するよう案内しています。公開は続けるが検索結果には出したくないURLには、クロールを許可したうえでnoindexを設定します。
robots制御の監査は、URLを5種類に分類してから始める
サイト全体を1URLずつ無作為に確認するのではなく、最初にURLを役割別に分類すると監査しやすくなります。分類ごとの期待状態と代表例は、次の表のとおりです。
| URL群 | 基本的な期待状態 | 代表例 |
|---|---|---|
| 検索流入を獲得したいURL | crawl可・index可 | 記事、サービス、商品、カテゴリ |
| 検索結果には出したくないURL | crawl可・noindex | 一部の管理補助ページなど |
| クロール自体を抑えたいURL | robots.txtで制御を検討 | 大量生成される不要URL |
| 削除済みURL | 404・410などを確認 | 廃止ページ |
| 非公開URL | 認証等でアクセス制御 | 管理画面、機密情報 |
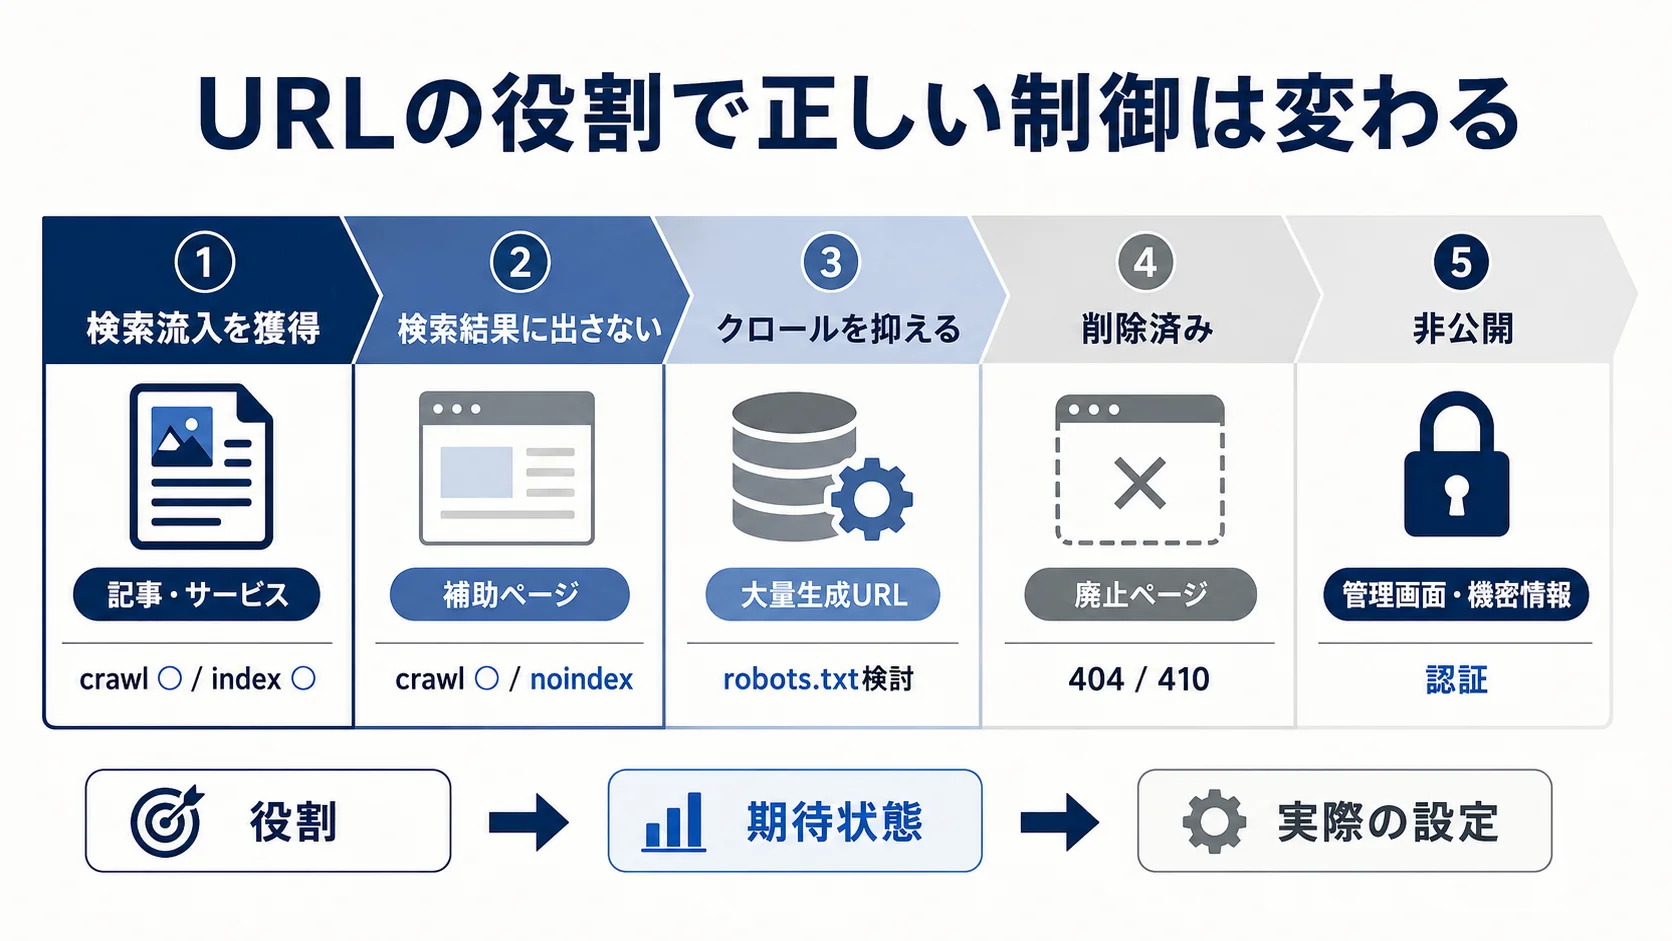
noindexやDisallow自体に問題があるわけではありません。URLの目的と実際の制御が一致しているかを確認します。
もう1点、robots.txtを「非公開機能」と考えないことも大切です。RFC 9309でもRobots Exclusion Protocolはアクセス認証の代わりではないとされています。機密情報は、robots.txtではなく、認証など適切なアクセス制御で守る必要があります。
重要URLが誤ってブロックされていないか、robots.txtで確認する
robots.txt自体の監査では、まず「本来インデックス登録させたいURLがDisallowに一致していないか」を確認します。
robots.txtのルールは、単純な上から順の処理だけではありません。RFC 9309では、AllowとDisallowのパスについて、より具体的に一致するルールを使用することが定められています。同じ長さでAllowとDisallowが一致する場合はAllowを使うことが推奨されています。そのため、目視で監査するときは次の5点を確認します。
User-agentごとのルールDisallow対象パスAllowによる例外*や$を使ったパターン- URLごとに最終的に適用されるルール
たとえば、ECサイトで商品ページが/products/配下にあるにもかかわらず、古い開発設定としてDisallow: /products/が残っていれば、重大な問題です。
確認には、Search Consoleのrobots.txtレポートが使えます。Googleが検出したrobots.txt、最終クロール時点、警告・エラーを確認できます。重要なブロックを解除した場合には、robots.txtの再クロールをリクエストすることも可能です。
meta robotsとX-Robots-Tagは両方取得して監査する
HTMLソースにnoindexが見当たらなくても、インデックス制御が存在しないとは限りません。サーバーやCDNからX-Robots-Tagが返されている可能性があるためです。
Googleはrobots metaタグとX-Robots-Tagの両方をサポートしており、競合するrobotsルールがある場合には、より制限の強いルールを適用すると説明しています。そのため、URL監査では最低限、次の情報を同時に取得します。
URL
HTTPステータス
robots.txt判定
meta robots
Googlebot向けmeta robots
X-Robots-Tag
canonical
XMLサイトマップ掲載有無特に注意したいのが、テンプレートやHTTPヘッダーによる一括設定です。たとえばCMS上では記事を「index」に変更していても、Webサーバー側でディレクトリ全体にX-Robots-Tag: noindexを返していれば、Googlebotに対してはnoindexが残ります。HTMLだけを見ても気づけないため、HTTPレスポンスまで確認します。
XMLサイトマップのURLがrobots制御と矛盾していないか確認する
次に、XMLサイトマップへ掲載されているURLとrobots制御を照合します。Googleは、XMLサイトマップにはGoogle検索結果に表示したいURLを含めるよう案内しています。また、基本的にはcanonicalとして扱いたいURLをサイトマップへ載せることが推奨されています。
したがって、サイトマップへの掲載の有無を含め、次の状態は監査対象です。
| 状態 | 判定 |
|---|---|
| sitemap掲載+crawl可+index可 | 原則正常 |
| sitemap掲載+robots.txtブロック | 要確認 |
| sitemap掲載+noindex | 原則矛盾 |
| sitemap掲載+404/410 | 修正対象 |
| sitemap掲載+別URLへcanonical | 要確認 |
| 重要URL+sitemap未掲載 | 発見経路と設計を確認 |
Search Consoleは、送信したサイトマップ内のURLがrobots.txtやnoindexなどによってブロックされている場合に問題が発生し得ると案内しています。「要確認」の行は、そのURLの重要度と意図を確かめてから判断します。たとえば重要URLがrobots.txtでブロックされていれば、後述のURL別の表の例のように、最優先で直す対象になります。
CSS・JavaScriptなど重要リソースの遮断も確認する
robots.txtの対象はHTMLだけではありません。CSS、JavaScript、画像などのリソースも対象になります。
「ファイルだから全部許可」「ファイルだから全部拒否」と判断せず、Googlebotがページを正しく取得・処理するために必要なリソースまでブロックしていないかを確認します。
特に過去のrobots.txtには、次のような広範囲な指定が残っていることがあります。
Disallow: /*.js$
Disallow: /*.css$
変更履歴が分からない設定でも、一括削除はしません。対象URLとページ表示への影響を確認してから修正します。
サイト横断監査では「URL×制御状態」の表を作る
数百〜数万URLを扱う場合、robots.txtのファイルだけをレビューしても不十分です。robots.txtに問題がなくても、meta robotsやHTTPヘッダー、サイトマップとの組み合わせで矛盾が生じることがあるためです。
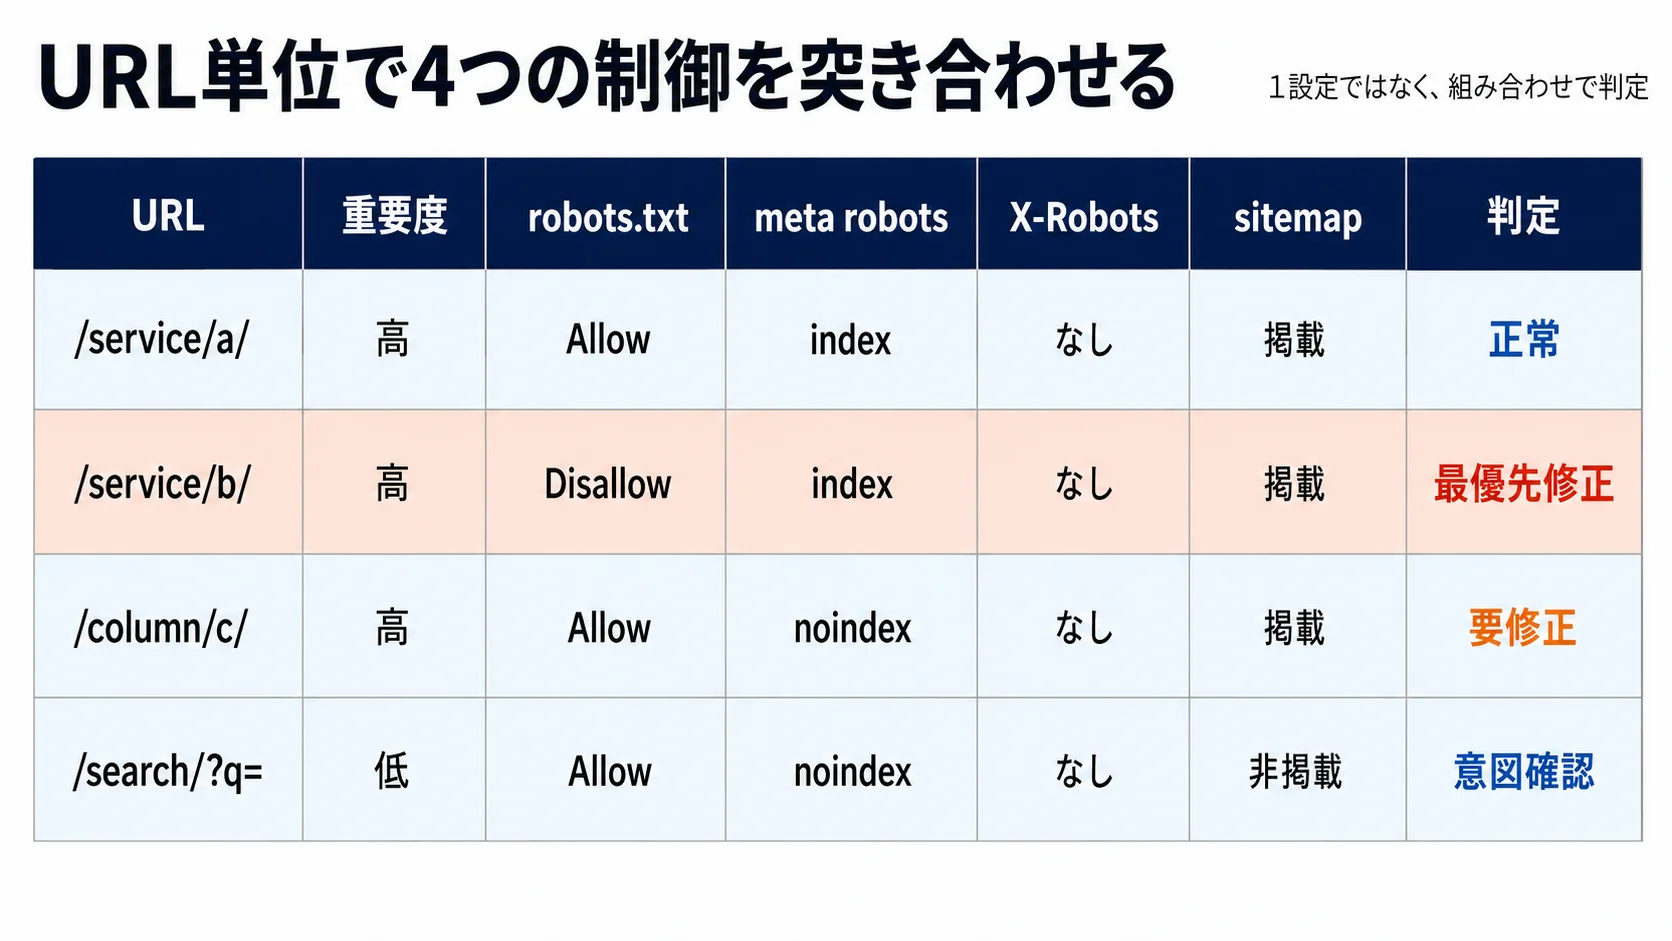
そこで、サイト横断監査では、robots.txtだけでなくmeta robots、X-Robots-Tag、サイトマップをURL単位でまとめ、期待状態とのズレを判定します。実務ではクロールデータ、サイトマップ、HTTPヘッダーなどを統合し、URLごとに次の状態を持たせます。表は1行が1URLで、右端が判定です。
| URL | 重要度 | robots.txt | meta robots | X-Robots | sitemap | 判定 |
|---|---|---|---|---|---|---|
| /service/a/ | 高 | Allow | index | なし | 掲載 | 正常 |
| /service/b/ | 高 | Disallow | index | なし | 掲載 | 最優先修正 |
| /column/c/ | 高 | Allow | noindex | なし | 掲載 | 要修正 |
| /search/?q= | 低 | Allow | noindex | なし | 非掲載 | 意図確認 |
| /old.pdf | 低 | Allow | – | noindex | 非掲載 | 意図どおりなら正常 |
ここでのポイントは、設定そのものに「正解」「不正解」を付けるのではなく、URLの役割と設定が一致しているかを見ることです。noindexは常に悪い設定ではなく、robots.txtのDisallowも同様です。検索流入を獲得する重要URLへ意図せず適用されていることが問題です。
修正は検索への影響度とURL数で優先順位を決める
問題を見つけても、すべてを同じ順番で修正する必要はありません。次の2軸で優先順位を決めます。
- 検索への影響度:検索流入やコンバージョンにつながる重要URLかどうか。
- 影響URL数:1URLだけの問題か、テンプレートやパス指定によって数百・数万URLへ波及しているか。
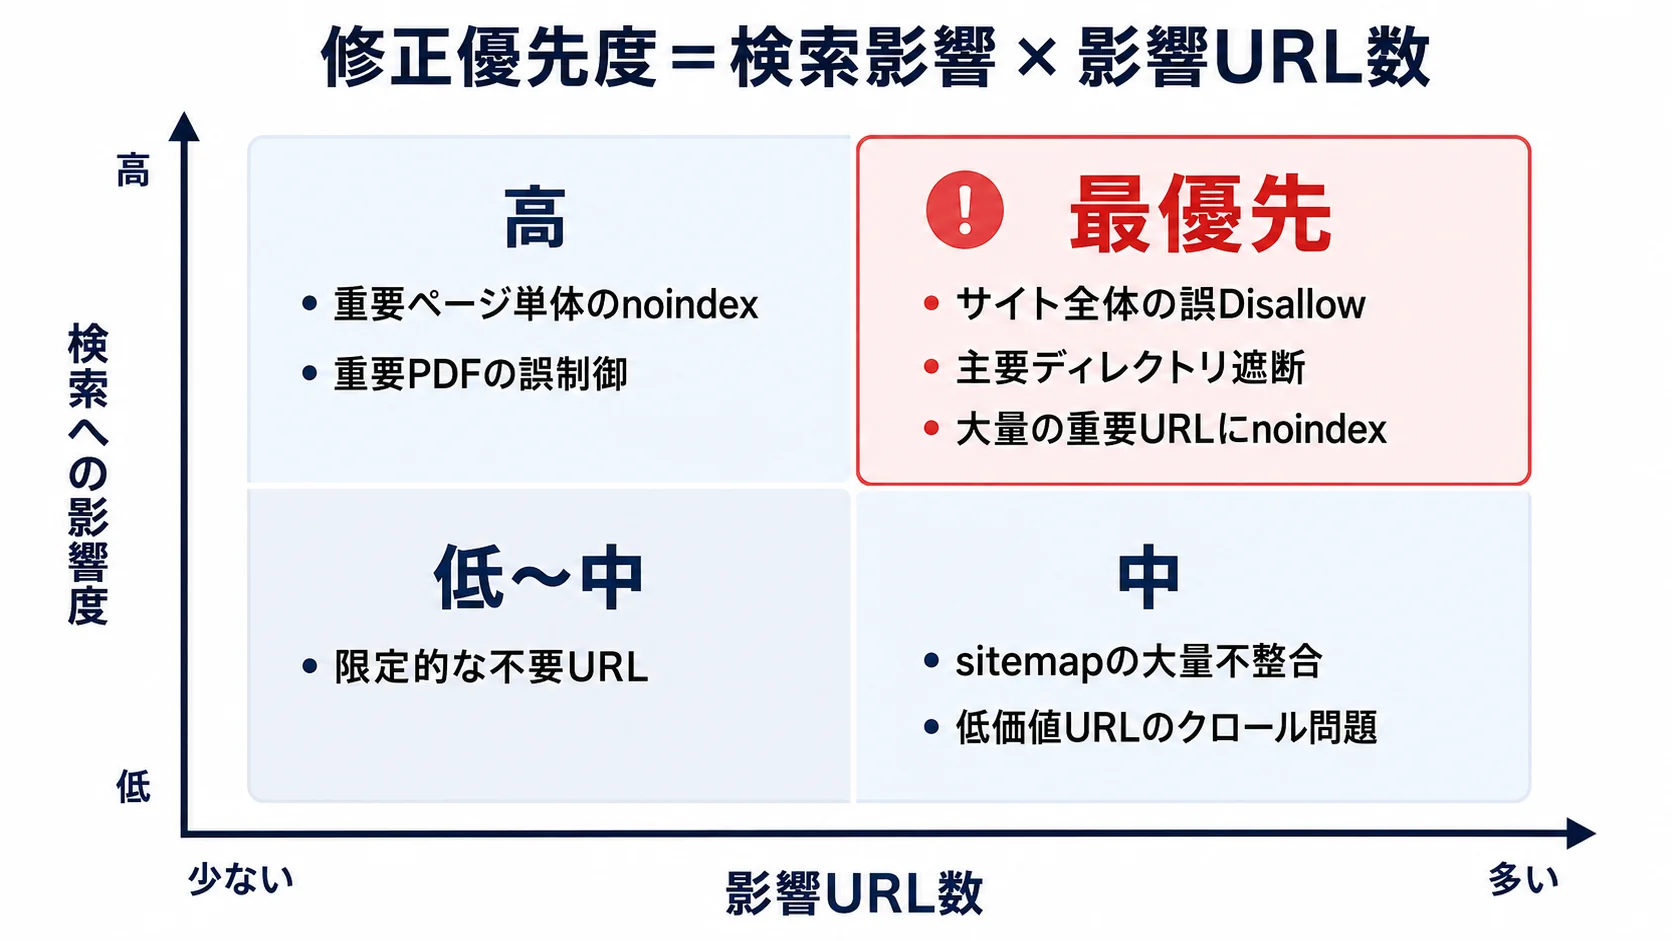
検索流入への影響が大きく、かつ多数のURLへ波及する問題ほど先に修正します。サイト全体や主要ディレクトリの誤Disallowは最優先です。優先度の目安は次の表のとおりです。
| 優先度 | 代表的な問題 |
|---|---|
| 最優先 | サイト全体・主要ディレクトリの誤Disallow |
| 高 | 重要ページ群へのnoindex残存 |
| 高 | sitemap掲載URLとrobots/noindexの大量矛盾 |
| 中 | PDFなど重要リソースへの意図しないX-Robots-Tag |
| 中 | レンダリングに必要なリソースの遮断 |
| 低〜中 | 検索価値の低いURL群のクロール最適化 |
サイト移行時は特に注意が必要です。Googleはサイト移行の一般的な問題として、開発時に設定したnoindexやrobots.txtのブロックを本番公開後も残してしまうケースを挙げています。
修正後はSearch ConsoleでGooglebotの実際の認識を確認する
設定ファイルを修正して終わりではありません。修正がGooglebotの側で実際に反映されているかを、重要URLについてSearch ConsoleのURL検査で確認します。少なくとも次の点を見ます。
- クロールが許可されているか
- ページを正常に取得できるか
- インデックス登録が許可されているか
- Googleが認識したcanonical
- 最新クロール後に変更が反映されているか
GoogleのURL検査関連ドキュメントでも、「クロールを許可」「ページ取得成功」「インデックス登録を許可」という項目を分けて確認できます。robots.txtを変更した場合は、Search Consoleのrobots.txtレポートも確認します。
robots制御監査のチェックリスト
ここまでの内容を、確認する順に並べました。この順に確認すると、重大な問題を見落としにくくなります。
- robots.txtが正常なHTTPステータスで取得できる
- 重要URLがDisallowに一致していない
- User-agentごとのルールを確認した
- AllowとDisallowの優先関係をURL単位で確認した
- 重要URLにmeta robotsのnoindexが残っていない
- X-Robots-TagをHTTPレスポンスから確認した
- robots.txtでブロックしたURLにnoindexを依存させていない
- XMLサイトマップ掲載URLとrobots制御が一致している
- 404・410・リダイレクトURLがサイトマップへ残っていない
- 重要なCSS・JavaScript等を誤って遮断していない
- 開発・移行時の一時的なnoindexやDisallowが残っていない
- 修正後にSearch Consoleで実際のGooglebot判定を確認した
まとめ|まず重要URLの状態を確認する
robots制御の監査では、robots.txtだけを確認しても不十分です。
robots.txtはクロール、meta robotsとX-Robots-Tagは主にインデックス登録や検索結果での表示を制御するため、役割が異なります。特に、robots.txtでクロールを止めたURLへnoindexを設定すると、Googleがnoindexを確認できなくなる点には注意が必要です。
実務では、サイト内のURLを役割ごとに分類したうえで、robots.txt、meta robots、X-Robots-Tag、HTTPステータス、canonical、XMLサイトマップをURL単位で突き合わせます。
最初の一歩は、重要URLが「クロールでき、インデックス登録もできる状態か」を確認することです。確認にはSearch ConsoleのURL検査を使います。そのうえで不要URLのクロール最適化へ進むと、SEOへの影響が大きい設定ミスから優先的に修正できます。
参考文献・データ元
この記事で参照した情報を確認できます。
- Google Search Central「robots.txt の概要」:robots.txtの目的、クロール制御とインデックス制御の違い。
- Google Search Central「Robots meta tag, data-nosnippet, and X-Robots-Tag specifications」:meta robots、X-Robots-Tag、競合ルールの処理。
- Google Search Central「noindex を使用してコンテンツをインデックスから除外する」:noindexをGoogleが認識するためのクロール要件。
- Google Search Central「Build and submit a sitemap」:サイトマップへ含めるURL、canonicalとの関係。
- Google Search Console ヘルプ「robots.txt レポート」:robots.txtの確認・再クロール方法。
- IETF RFC 9309「Robots Exclusion Protocol」:robots.txtの標準仕様、Allow/Disallowのマッチング、セキュリティ上の位置付け。
- Google Search Central「Site Moves and Migrations」:サイト移行時のrobots.txt・noindex残存リスク。2026年8月20日更新。
‹ 親記事: テクニカルSEOとは?クロールからセキュリティまで、企業担当者が押さえるべき7領域の実務チェックリスト
関連記事
- › INDEX削除(インデックス削除)とは?検索結果から消える仕組みと対処法
- › Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け
- › SEO内部リンクの確認方法|孤立ページ・深度・アンカー偏りを改善
- › ページがインデックスされない原因は?Search Consoleで未登録・除外・重複URLを確認
- › JavaScript SEOの確認方法|表示・内部リンク・登録状況
- › クロールバジェットの確認方法|無駄なクロールと改善優先度
- › 構造化データの確認方法|エラー・本文との不一致・重複を検証
- › 多言語ページの言語・地域指定を確認|相互参照・正規URLをチェック
- › 絞り込み検索のSEO確認方法|URL増加・クロール・重複を防ぐ
- › SEOリダイレクトの確認方法|多段転送・ループ・誤転送を検出
- › ページネーションのSEO確認方法|正規URL・内部リンク・クロール
- › サイト移行後のSEO確認方法|転送・正規URL・順位変動を確認
- › 404・soft 404のSEO確認|リンク切れ・消失URLを修正
- › SEOリリース前チェックの作り方|noindex・canonical・robots・リダイレクトの事故を防ぐ
- › 画像SEOの確認方法|alt・画像URL・遅延読み込みを確認
- › 求人ページの構造化データを確認|給与・勤務地・期限の不一致
- › サイト内検索ページのSEO確認|noindex・クロール・重複URL
- › サイトリニューアルでSEO評価を落とさない移行方法|URL・301・計測・公開手順
- › サービス終了ページは削除すべき?301・404/410・残す場合のSEO判断基準
- › SEOに強いURL・ディレクトリ設計|階層・命名・変更時の注意点
- › サブディレクトリとサブドメインの違い|SEO・運用の判断基準
- › リッチリザルトとは?種類・構造化データ・表示確認方法を解説
- › Google Search Consoleとは?登録方法と最初に見る4つの指標