生成AIを記事制作に取り入れるとき、最初に決めるべきなのは「AIを使ってよいか、禁止するか」ではありません。企画、調査、構成、下書き、校正などの工程ごとにAIへ任せてよい範囲を決め、公開責任は人間に残すことが先です。
「使うか、使わないか」の二択で決めると、禁止すればAI導入の効果を失い、無条件に許可すれば誤った情報や機密情報の扱いを現場任せにしてしまいます。そこで、次の5点を決めます。
- 利用できるAI
- 入力してよい情報
- AI出力の確認方法
- 公開承認者
- 利用記録と事故対応
この記事では、マーケティング部門やオウンドメディア編集部が生成AIを安全に活用するためのルールを、実際の制作工程に沿って整理します。読み終えた後、自社のAI利用範囲とレビュー工程をそのまま設計できる状態を目指します。
関連する全体像や前提は「コンテンツ制作・運用体制とは?編集フロー・役割分担・品質チェックの仕組みを体系的に整理」で解説しています。
生成AIの記事制作ルールは「禁止事項」ではなく「任せてよい範囲」から決める
この節では、ルール作りの出発点を決めます。出発点は、AI利用そのものを一律に禁止・許可することではありません。記事制作を工程に分解し、工程ごとに「AIへ任せる」「人間が確認する」「AIへ任せない」を決めることです。
経済産業省の「AI事業者ガイドライン(第1.2版)」は、2026年3月31日に取りまとめられ、AIのリスクをライフサイクル全体で管理する考え方を示しています。AIを利用する企業も、用途やリスクに応じて管理方法を変える必要があると考えます。
記事制作でも同じ考え方が使えます。たとえば、誤字脱字の確認と、法律に関する結論の作成を同じルールで扱うべきではありません。前者はAIによる自動化と相性がよい一方、後者は一次資料の確認や専門家による判断が必要になる場合があります。
次の表は、制作工程ごとにAI利用の基本方針と人間の担当をまとめたものです。この分類をもとにすると、ルールを作りやすくなります。
| 制作工程 | AI利用の基本方針 | 人間が担当すること |
|---|---|---|
| テーマ案・企画補助 | 利用可 | 採用する企画の決定 |
| キーワード・論点整理 | 利用可 | 検索意図・事業との整合確認 |
| 資料探索 | 補助利用可 | 原典へのアクセスと採否判断 |
| 情報要約 | 条件付き利用 | 原文との照合 |
| 構成案 | 利用可 | 読者課題・記事目的との整合確認 |
| 下書き | 条件付き利用 | 内容、表現、独自性の編集 |
| 数字・固有名詞・制度 | AIだけで確定しない | 一次情報で確認 |
| 引用 | AIだけで確定しない | 原文・引用範囲・出典確認 |
| 校正・表記統一 | 利用可 | 最終確認 |
| 公開判断 | AIへ任せない | 責任者が承認 |
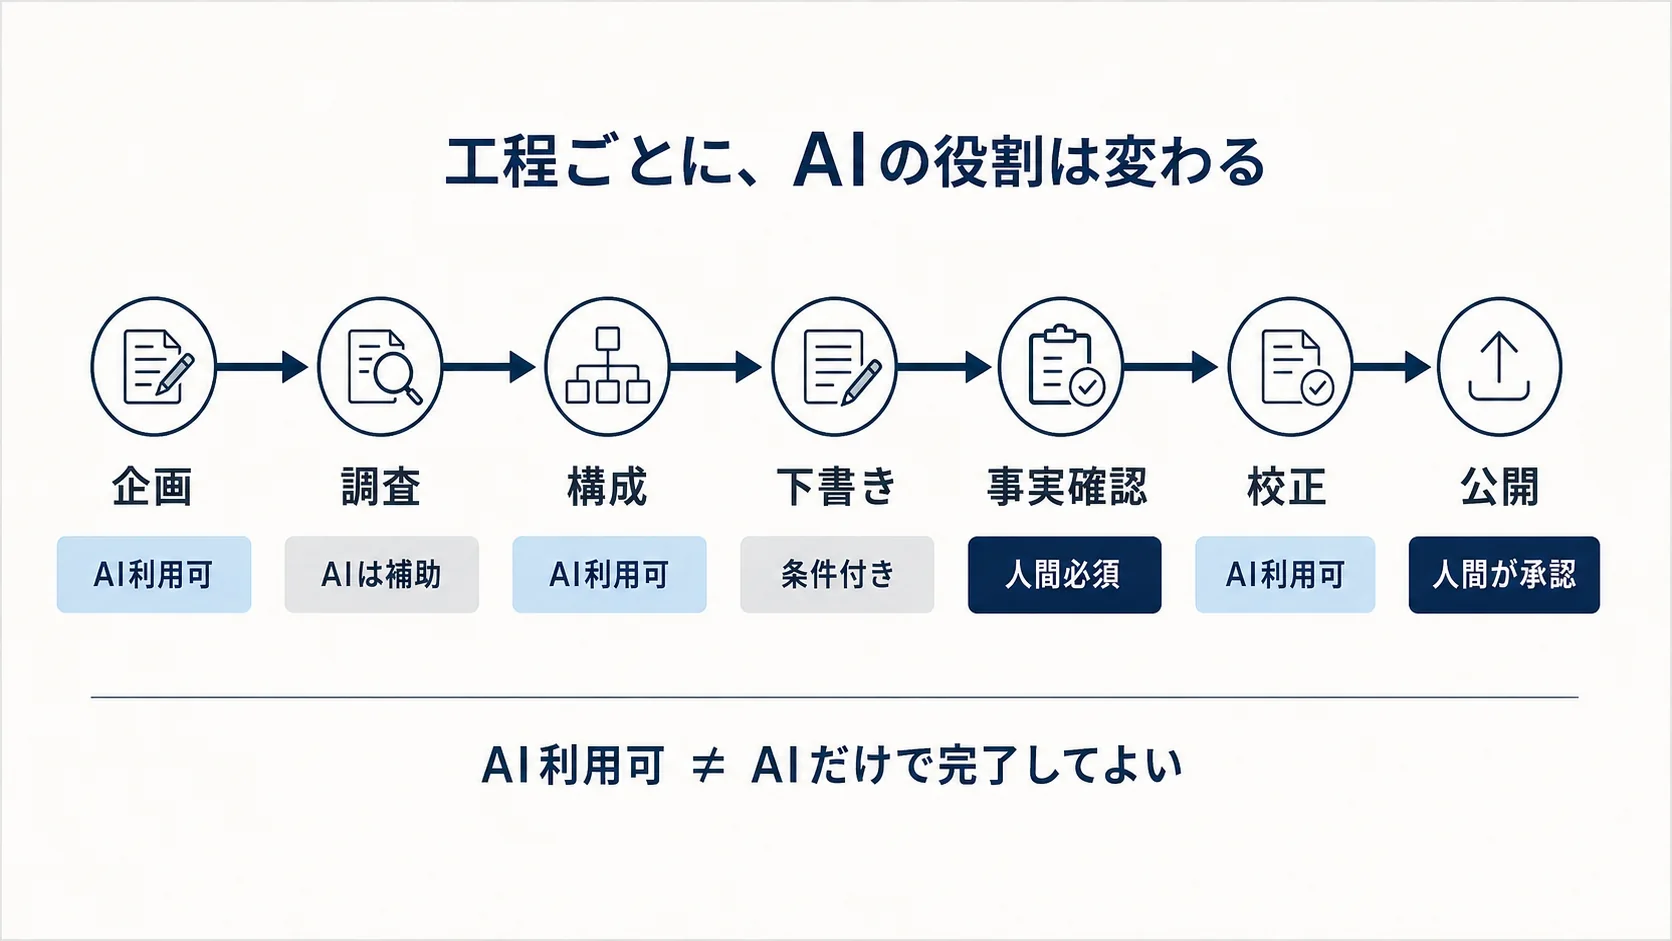
表と図の読み方で押さえたいのは、AIを使えるかどうかではなく、AI出力だけで工程を完了してよいかを定義することです。「利用可」の工程でも、AI出力だけで完了してよいとは限りません。たとえば校正・表記統一は「利用可」ですが、人間が最終確認します。さらに、数字・固有名詞・制度や引用は「AIだけで確定しない」、公開判断は「AIへ任せない」とし、事実確認と公開判断は人間側に残します。
記事制作で最初に決める5つの運用ルール(前半3つ:利用できるAI・入力してよい情報・AI出力の確認方法)
記事制作で生成AIを使う場合は、冒頭で挙げた5点(利用できるAI、入力してよい情報、AI出力の確認方法、公開承認者、利用記録と事故対応)を、最低でも決めておく必要があります。この節では前半の3つを順に整理します。公開承認者は導入順の節とAI利用ログの節、利用記録はAI利用ログの節、事故報告先はひな形の節で扱います。
1.業務で使ってよいAIを、契約・設定条件まで含めて決める
社員が自由に生成AIサービスを選べる状態では、入力データの扱い、保存期間、管理機能などがサービスごとに異なるため、情報管理が難しくなります。そこで、利用ルールとして次の項目を決めます。
- 利用可能なサービス
- 利用可能なプラン
- 業務アカウントの使用条件
- 個人アカウントの扱い
- 外部サービスとの連携可否
ここで見落としやすいのは、サービス名だけで判断して、契約・設定条件まで確認しないことです。たとえばOpenAIは、ChatGPT Business、Enterprise、Edu、APIなどのビジネス向け製品について、組織の入力・出力データをデフォルトではモデル学習に使用しないと説明しています。
したがって、「ChatGPTだから入力可」と判断するのではなく、「どの契約環境を、どの設定で利用するか」までルールに書きます。
2.AIへ入力してよい情報を3段階に分ける
記事制作では、公開情報のほかに、顧客情報、インタビュー記録、社内資料、公開前の商品情報などを扱う場合があります。入力してよいかどうかを担当者の判断に任せると、ばらつきが出ます。そこで、入力する情報を少なくとも次の3段階に分けます。
| 情報区分 | 例 | 基本方針 |
|---|---|---|
| 公開情報 | 公開済みWebページ、官公庁資料 | 承認済みAIで利用可 |
| 社内情報 | 社内マニュアル、未公開企画 | 利用環境・目的に応じて判断 |
| 機密・個人情報 | 顧客情報、個人データ、契約情報、未公開数値 | 原則入力しない。必要時は個別承認 |
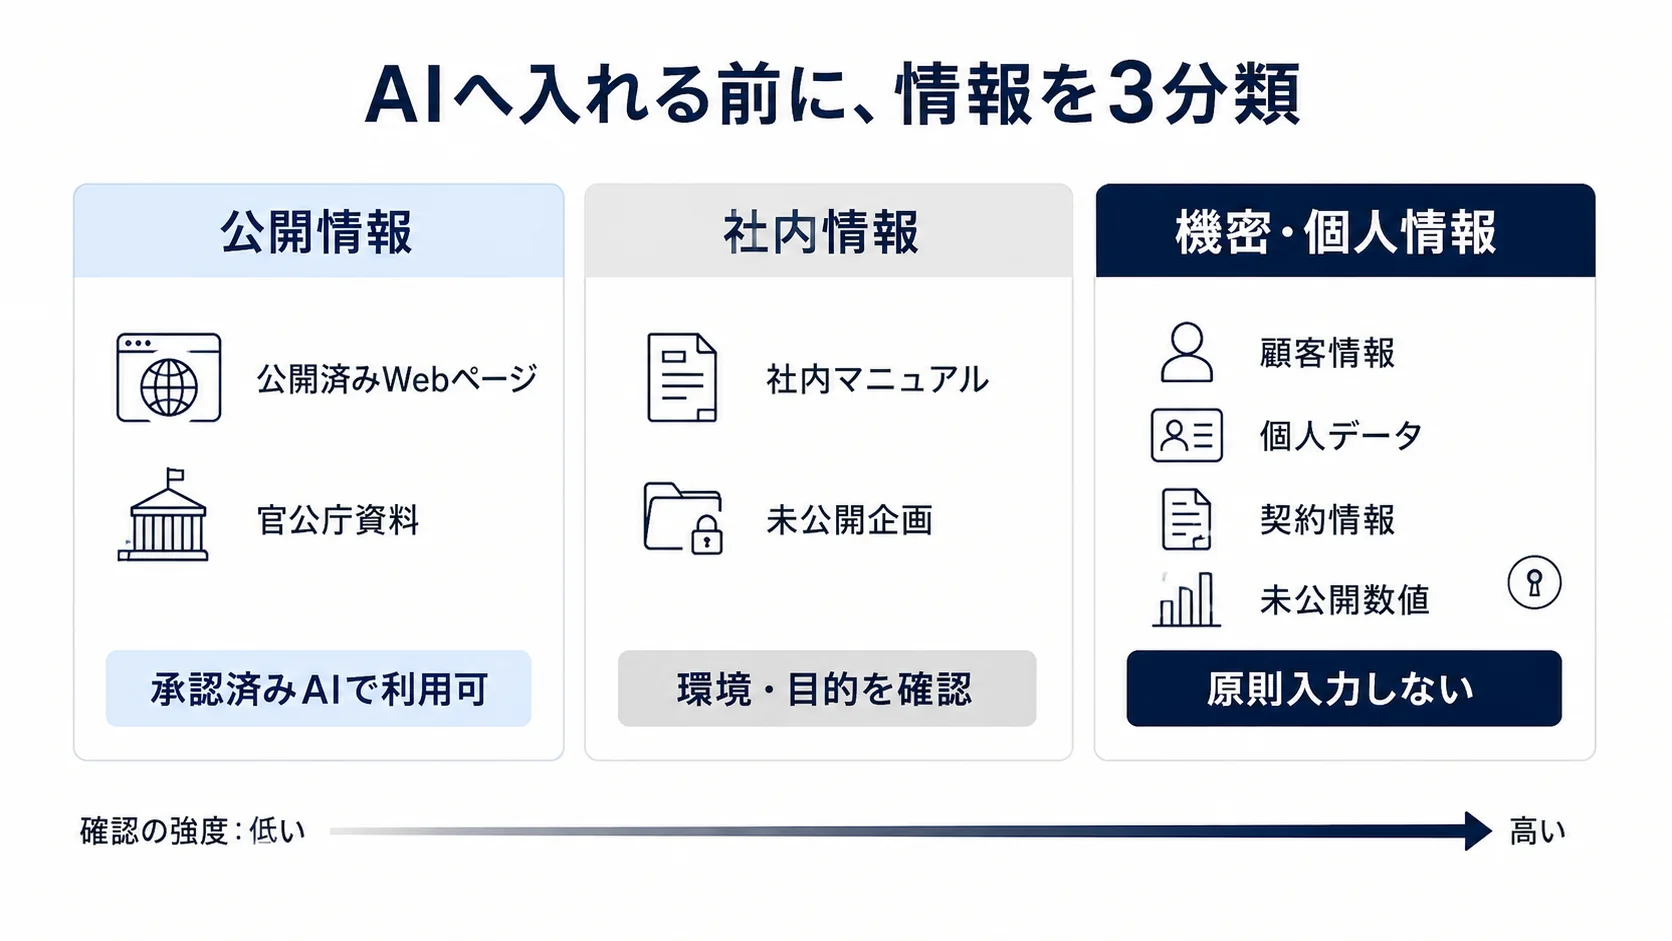
入力の可否は「社内情報かどうか」だけで決めず、情報区分と利用環境を組み合わせて判断します。
個人情報保護委員会は、事業者が生成AIへ個人情報を入力する場合、特定した利用目的の範囲内であることを確認するよう注意喚起しています。また、個人データが出力以外の目的で取り扱われる可能性がある場合には、サービス提供者によるデータ利用条件を十分確認する必要があるとしています。
「社外秘は入力禁止」とだけ決めても、担当者によって判断が変わります。判断が分かれないように、実際の記事制作で扱う情報を具体例として示しておきましょう。
3.AIが示した事実は原典まで戻って確認する
生成AIを調査に利用する場合、「AIが出典を示したから確認済み」としてはいけません。数字、制度、法律、料金、日付、固有名詞、調査結果など、記事の結論に影響する事実は、原典(一次情報)まで戻って確認します。
推奨する確認順序は次のとおりです。
- AIで論点や資料候補を探す
- 元となるWebページ・論文・PDFを開く
- 原文で該当箇所を確認する
- 公開日・更新日・対象期間を確認する
- 記事内の表現と原典を照合する
- 出典を記録する
Googleも、生成AIをコンテンツ制作に使う場合は正確性・品質・関連性を重視するよう案内しています。また、ユーザーへの価値を追加せず大量のページを生成する行為は、scaled content abuseに該当する可能性があるとしています。
こうした案内を踏まえると、編集部の品質基準は「AIが正しい文章を書けたか」ではなく、公開する主張を人間が証拠で確認できるかに置く方が安定すると考えます。
人間レビューは「全文を読む」だけでは不十分
この節では、AIを使った記事を公開する前に、人間が何を確認するかを決めます。人が全文を読むだけでは、十分なレビューにならない場合があるためです。
AIの文章は自然に読めるため、誤った内容でも違和感を持ちにくいことがあります。AIなどの自動システムを過度に信用してしまう現象は「オートメーション・バイアス」と呼ばれます。
2024年に公表されたAI意思決定支援に関する研究では、210人を対象とした実験で、誤ったAIの推奨へ同意する行動が確認され、専門的な訓練などが誤った同意を減らす要因として示されました。医療分野の研究であるため、その結果をそのまま編集業務へ当てはめることはできませんが、「人が確認した」という事実だけではAI依存を防げないことを考える参考になります。
そこで記事制作では、レビューする項目を分けて確認します。
公開前に確認する5つの観点
- 事実:数字、日付、固有名詞、制度に原典があるか
- 引用:原文と一致し、出典と引用範囲が適切か
- 権利:既存著作物との不自然な類似や無断利用がないか
- 編集品質:読者の問いへ回答し、独自情報があるか
- 責任:最終的な主張を公開責任者自身が説明できるか
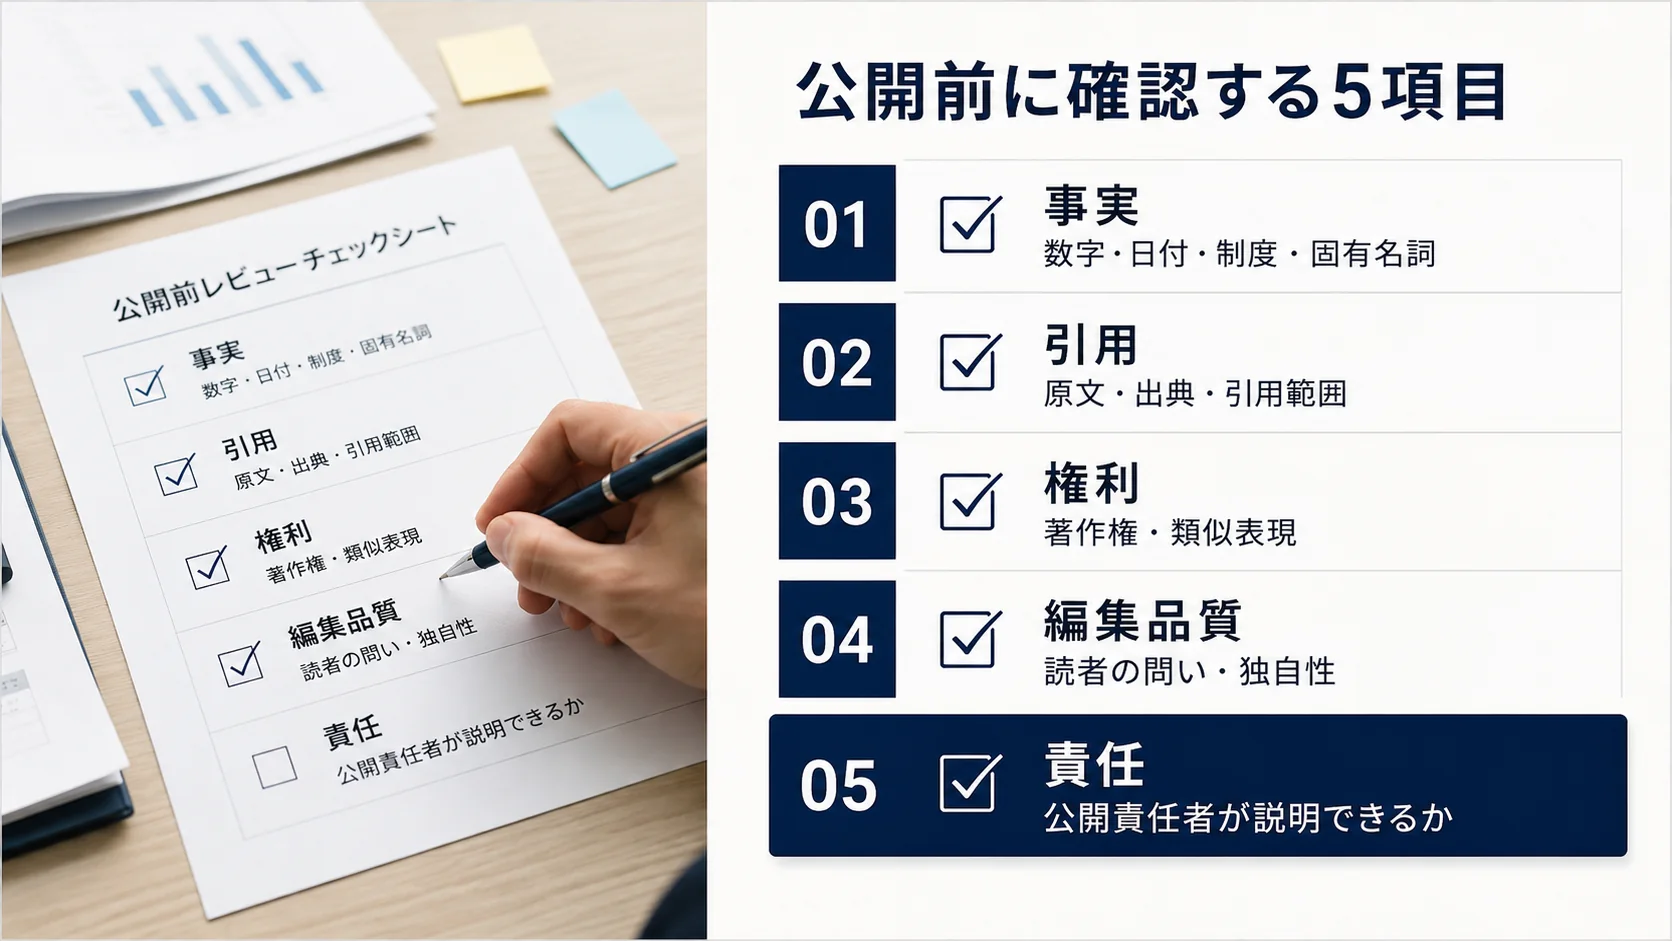
生成AIの記事は「人が読んだか」ではなく、事実・引用・権利・編集品質・公開責任をそれぞれ確認したかでレビューします。この5つの観点を確認した人を記録すれば、「誰かが一度読んだ」状態から、確認責任を追跡できる運用へ変えられます。
著作権は「AI生成だから自由に使える」と判断しない
生成AIが作った文章だからといって、第三者の権利確認が不要になるわけではありません。
文化庁は「AIと著作権に関する考え方について」を公表するとともに、生成AI利用者などが著作権リスクを低減するためのチェックリスト・ガイダンスを公開しています。AI生成物についても、既存著作物との類似性など、個別の状況に応じた確認が必要です。
記事制作では、特に次の点をルール化します。
- 特定記事を模倣させる目的で長文を入力しない
- 競合記事の文章を言い換えるだけの制作をしない
- AIが生成した引用文を原典確認なしで掲載しない
- 特徴的な表現や事例が既存コンテンツと酷似していないか確認する
- 画像、図表、文章などコンテンツ種別ごとの権利確認を行う
また、人がAIを創作の「道具」として利用したと評価できるかについては、創作意図や創作的寄与などを含め、個別事情によって判断されると文化庁は説明しています。そのため、重要なコンテンツでは、人間が企画・選択・修正・編集した過程を残しておくことも有効です。
生成AIの利用レベルを4段階にすると現場で迷いにくい
制作工程をすべて個別に規定すると、ルールが長くなります。そこで実務では、AI利用を4段階に分類しておくと運用しやすくなります。次の表は、各レベルでのAIの役割、例、公開条件を整理したものです。
| レベル | AIの役割 | 例 | 公開条件 |
|---|---|---|---|
| Lv.1 補助 | 整理・校正 | 誤字修正、表記統一 | 担当者確認 |
| Lv.2 たたき台 | 案を生成 | タイトル案、構成案 | 編集者が選択・修正 |
| Lv.3 本文生成 | 文章を作成 | 解説文、要約、下書き | 原典確認+編集レビュー |
| Lv.4 重要判断 | 結論を左右 | 法的評価、専門判断、公開判断 | AI単独は禁止 |
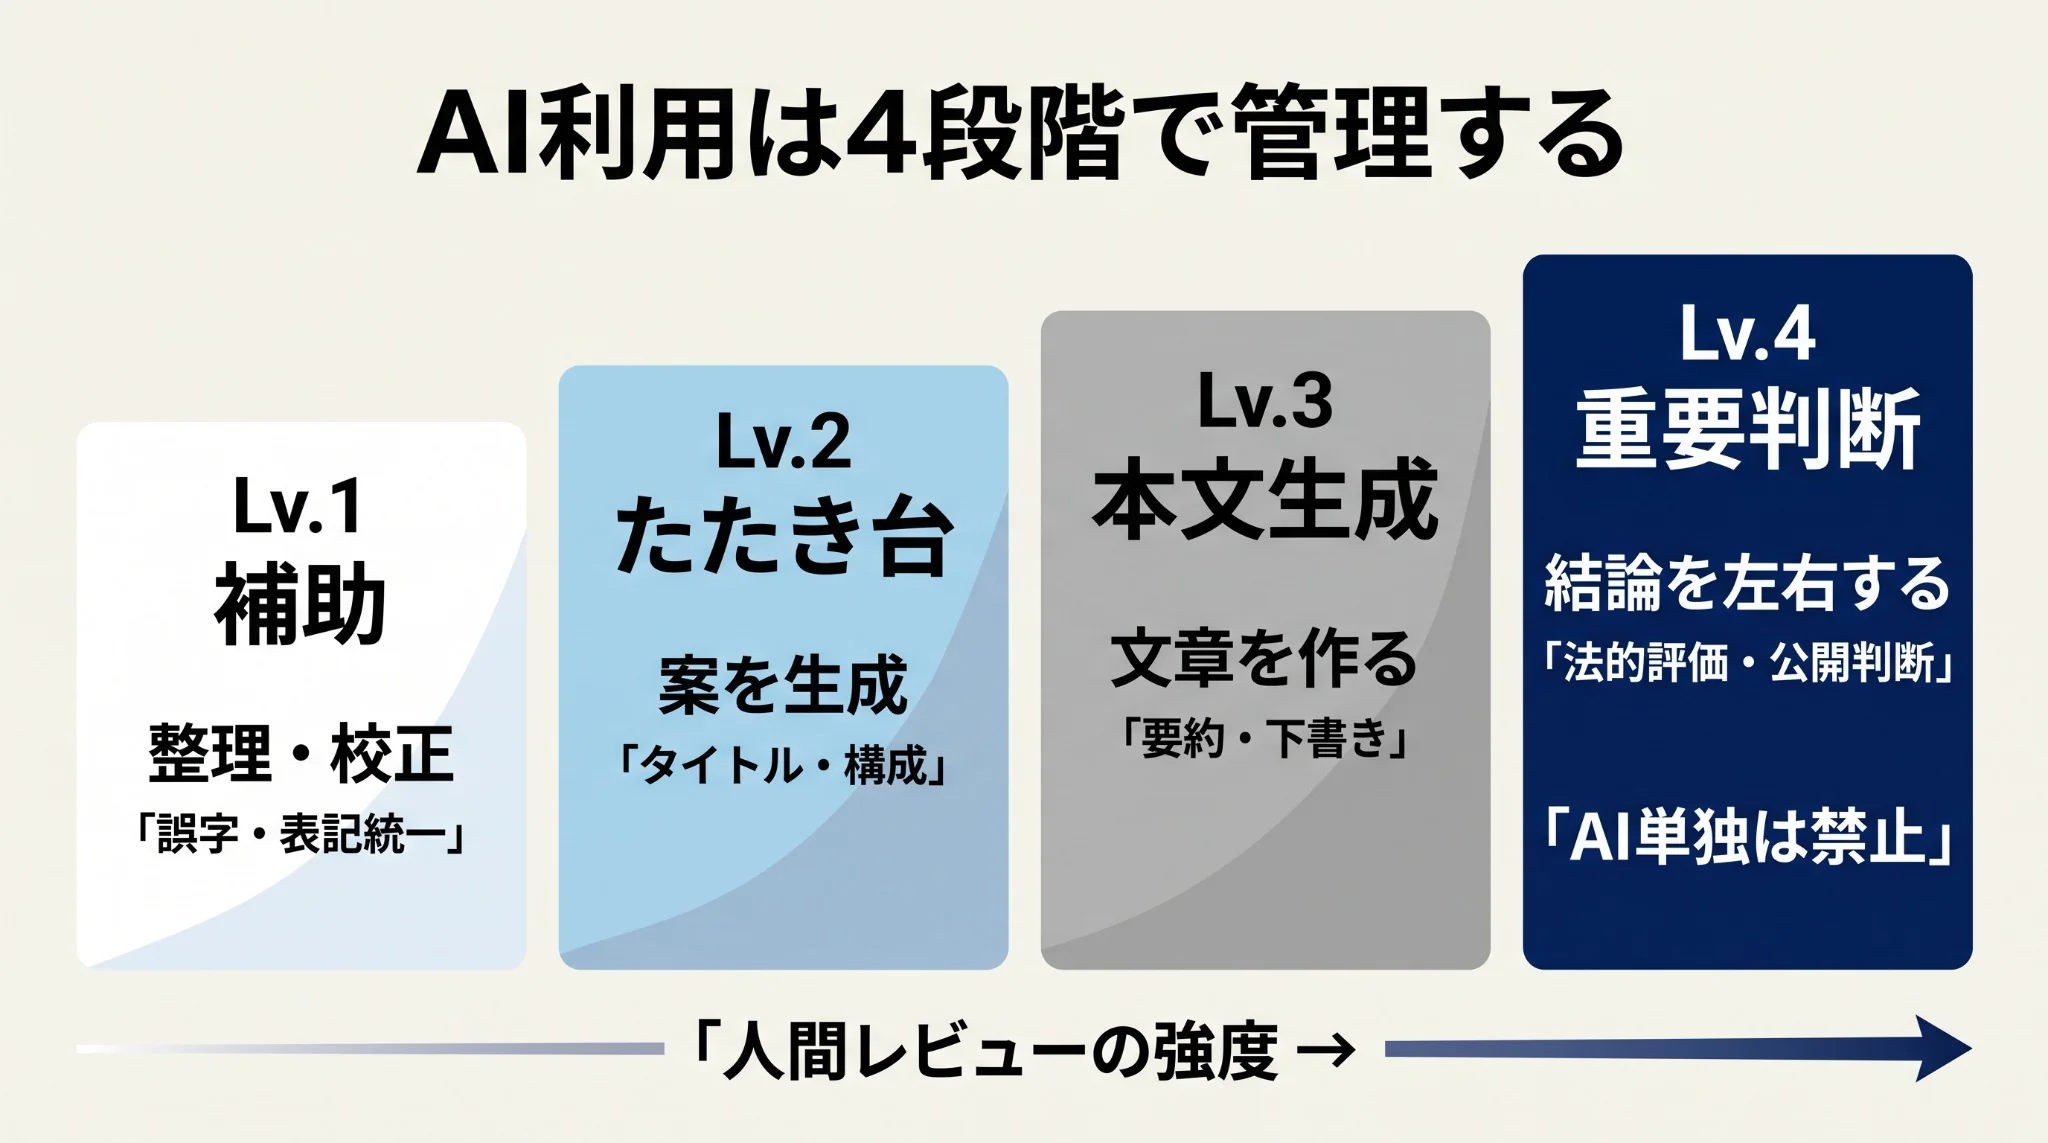
ツール名ではなく、AIが成果物や意思決定へ与える影響の大きさで利用レベルを決めると、サービスが変わってもルールを使い続けられます。「ChatGPTでは○○禁止」「Geminiでは○○可能」のようなルールだけでは、新しいサービスが導入されるたびに書き換える必要があるためです。
一方、「事実確認を伴わない本文生成はLv.3」のように業務とリスクを基準にすれば、使用ツールが変わっても基本ルールを維持できます。
記事のリスクに応じてレビュー強度を変える
すべての記事を同じ強度でレビューすると、安全側へ寄せすぎてAI導入の効果が失われます。逆に、すべてを同じ簡易フローで公開すると、高リスクの記事を見逃します。
そのため、記事自体もリスク別に分類します。基準は、「AIを使った記事だから厳しく確認する」ではなく、間違えた場合の影響に応じてレビュー強度を決めることです。
低リスクの記事:通常の編集レビューで公開
例として、次のような記事があります。
- 基礎用語の解説
- 自社サービスの一般的な使い方
- 公開済み情報の整理
これらは、通常の編集レビューで公開します。
中リスクの記事:一次情報との照合と担当者以外の確認を追加
例として、次のような記事があります。
- 統計データを使う記事
- 他社サービスを比較する記事
- 調査・ランキング記事
- 採用・人事など判断へ影響する記事
これらは、一次情報との照合と、担当編集者以外による確認を追加します。
高リスクの記事:編集責任者や専門家の確認を公開条件にする
例として、次のような記事があります。
- 法律
- 医療
- 金融
- 個人情報
- 企業や個人への評価
- トラブル対応
これらは、編集責任者や必要な専門家の確認を公開条件にします。
AI利用ログは全文保存ではなく「後から説明できる情報」を残す
AIの利用を組織として管理するうえでも、記録を残すことは重要です。ただし、すべてのプロンプトと回答を無期限に保存すればよいわけではありません。ログそのものに機密情報が含まれる可能性があるためです。
最低限、記事単位で次を記録します。
- 使用したAIサービス
- AIを利用した工程
- 利用した主要資料
- 重要な事実を確認した出典
- 確認担当者
- 公開承認者
- 公開日
- 修正履歴
ログの目的は、「AIを使った証拠」を集めることではありません。問題が起きたときに、どの情報をもとに、誰が何を確認して公開したかを説明できる状態にすることです。
NISTのGenerative AI Profileも、生成AIのリスク管理を「Govern・Map・Measure・Manage」の考え方で整理し、組織の目的やリスク許容度に合わせて管理することを重視しています。ログの範囲も、自社の目的とリスクに合わせて決めましょう。
AIを使ったことは必ず表示すべきか
すべての記事に一律で「生成AIを使用しました」と表示する必要があるとは限りません。
Googleは、コンテンツの作成方法について読者が背景を知ることに意味がある場合、AIや自動化の利用について説明することを検討するよう案内しています。一方、検索評価では制作手段そのものより、正確で価値のあるコンテンツかどうかが重要です。
したがって、開示の基準をあらかじめ決めます。次のような場合は、開示を検討します。
- AIが本文の大部分を生成した
- AI生成画像を使用した
- 読者が制作方法を知ることが判断に影響する
- 媒体や取引先のルールで開示が必要
- 人間による取材や執筆と誤認させる可能性がある
逆に、誤字修正や表記統一だけにAIを使った場合まで、同じ表示を行う必要性は低いでしょう。重要なのは、表示の有無を担当者の感覚で決めず、編集方針として統一することです。
生成AI記事制作ルールのひな形|まず決める10項目
最初から詳細な規程を作る必要はありません。まず次の10項目を決めれば、編集部の初期ルールとして運用を始められます。
- 業務利用できるAIサービスを指定する
- 個人アカウント利用の可否を決める
- AIへ入力禁止とする情報を定義する
- 制作工程別のAI利用レベルを決める
- 数字・引用・固有名詞は一次情報で確認する
- AI出力をそのまま公開しない
- 記事リスクに応じて確認者を決める
- AI利用の開示基準を決める
- 利用記録と修正履歴を残す
- 事故報告先とルール見直し責任者を決める
ルール策定後は、実際の記事を数本制作し、「判断に迷った箇所」を集めます。生成AIサービスや関連ガイドラインは更新されるため、完成した規程として固定するのではなく、実務で迷った事例と外部環境の変化をもとに継続して改定する運用が適しています。
生成AIの記事制作ルールは、どの順番で導入するか
これから整備する企業は、すべてを一度に完成させる必要はありません。次の順番で進めると、運用を始めやすくなります。
- 利用可能なAIを決める:まず、社員が業務で利用してよい環境を統一します。
- 入力禁止情報を決める:顧客情報、個人情報、契約情報、未公開情報などを具体化します。
- 公開前の証拠確認を決める:数字、制度、引用、固有名詞は原典へ戻るというルールを固定します。
- 公開承認者を決める:「AIが作った」「担当者が確認した」で責任を終わらせず、公開判断を行う人を明確にします。
- 工程別ルールを細分化する:実際の運用で迷った箇所から、企画・調査・構成・執筆・校正のルールを追加します。
最初に細かな禁止事項を大量に作るより、重大な事故を防ぐ冒頭の5点を先に固定し、実務を回しながら詳細化する方が定着しやすくなります。
まとめ|AIに任せる範囲と人間の責任を決める
生成AIの記事制作ルールでは、「AIを使うか、使わないか」という二択ではなく、何をAIへ任せ、どこから人間が責任を持つかを決めることが出発点です。
最初に決めるのは、冒頭の5点(利用できるAI、入力してよい情報、AI出力の確認方法、公開承認者、利用記録と事故対応)です。そのうえで、AI利用を「補助」「たたき台」「本文生成」「重要判断」の4段階に分け、記事自体もリスク別に分ければ、必要以上にAIを禁止せずに品質と情報管理を両立できます。
生成AIは記事制作の速度を上げられます。しかし、公開する情報の正確性や責任までAIへ移すことはできません。「AIが作った記事を人間が読む」という運用ではなく、AIを組み込んだ編集工程そのものを設計することが、継続的に生成AIを活用するための前提になります。
最初の一歩は、業務で使ってよいAIの環境を決めることです。そこから、入力禁止情報、公開前の証拠確認、公開承認者の順に決めていきましょう。ルールを決めたあとに、実際にAIで記事を書き進める手順を知りたい場合は、AIでブログ記事を書く手順|品質と事実確認の進め方をご覧ください。
参考文献・データ元
この記事で参照した情報を確認できます。
- 「AI事業者ガイドライン(第1.2版)」経済産業省、2026年3月31日取りまとめ・2026年4月1日最終更新。AI利用におけるガバナンス、リスク管理の考え方を参照。
- 「生成AIサービスの利用に関する注意喚起等」個人情報保護委員会。生成AIへ個人情報・個人データを入力する際の注意事項を参照。
- 「AIと著作権について」文化庁。AI利用時の著作権に関する考え方、チェックリスト等を参照。
- 「Google Search’s guidance on using generative AI content on your website」Google Search Central、2025年12月10日更新。生成AIコンテンツの品質・正確性・開示に関する考え方を参照。
- 「Spam Policies for Google Web Search」Google Search Central。scaled content abuseの基準を参照。
- 「Business data privacy, security, and compliance」OpenAI。ビジネス向けサービスのデータ取扱いを参照。
- 「Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile」NIST、2024年。生成AIリスク管理の枠組みを参照。
- Kücking, F. et al., “Automation Bias in AI-Decision Support: Results from an Empirical Study,” 2024. AI支援に対する過度な依存を考える補助研究として参照。
‹ 親記事: コンテンツ制作・運用体制とは?編集フロー・役割分担・品質チェックの仕組みを体系的に整理
関連記事
- › 記事品質チェックリストの作り方|編集基準・校正・根拠確認・公開承認を標準化する
- › SEO記事のコンテンツブリーフ作成方法|検索意図・見出し・根拠・内部リンクを制作前に定義する
- › オウンドメディアの著者・監修者設計|誰が書き、誰が確認したかを記事単位で明示する方法
- › オウンドメディア編集部の作り方|編集長・ライター・監修者・SEO担当の役割分担
- › 記事の更新期限を決める方法|鮮度・重要度・順位下落で判断
- › 記事の出典・根拠を管理するエビデンス台帳の作り方|更新期限・一次情報・引用箇所を追跡
- › オウンドメディアの編集権限・版管理を設計する方法|誤公開・上書き・承認漏れを防ぐ
- › 記事の出典を定期確認|リンク切れ・情報鮮度・一次情報をチェック
- › オウンドメディアのアクセス権限を定期確認|退職・異動時の対応
- › 生成AIを使った記事制作の検証ログを作る方法|プロンプト・根拠確認・修正履歴を残す
- › コンテンツ制作の遅れを確認|企画・執筆・確認・公開を可視化
- › 外注記事の受入れ基準を作る方法|納品形式・根拠・著作権・修正責任を標準化
- › オウンドメディアの画像・図版ライセンスを管理する方法|出典・利用範囲・期限を台帳化
- › 外注ライター・制作会社の評価スコアカードを作る方法|品質・納期・修正回数・専門性を継続評価
- › オウンドメディアの緊急訂正・公開停止フロー|訂正・一時非公開・削除の判断基準と復旧手順
- › 法人向けサービスページの比較表の作り方|料金・対象・対応範囲・実績・契約条件を同じ軸で整理
- › 導入事例ページの作り方|成果数値・導入期間・取り組み内容
- › オウンドメディア担当者の引き継ぎチェックリスト|記事・CMS・編集ルール・分析データ・進行中企画を整理
- › 導入事例ページの作り方|業種・課題・成果で探せる構成と導線
- › 法人向けサービスページのFAQの作り方|料金・対象・導入条件・契約・セキュリティの質問を整理
- › 法人向けサービスページの導入フローの作り方|期間・準備物・担当・例外条件まで整理
- › 法人向けサービスのセキュリティ情報の載せ方|認証・データ保管・権限・問い合わせ先の整理方法
- › 法人向けサービスサイトの情報更新を誰が持つ?営業・法務・制作で料金・実績・契約条件を管理する方法
- › オウンドメディアの表記ガイドラインの作り方|表記ゆれ・数字・固有名詞・引用ルールを統一
- › オウンドメディアのインタビュー記事の作り方|企画・質問設計・取材・原稿確認・公開まで
- › オウンドメディアの記事テンプレートの作り方|原稿フォーマット・出典・CTA・FAQ・著者欄を標準化
- › Claudeの料金プラン比較|無料・Pro・Team・法人向けの選び方
- › NotebookLMの使い方|資料の読み込み・要約・質問の基本手順