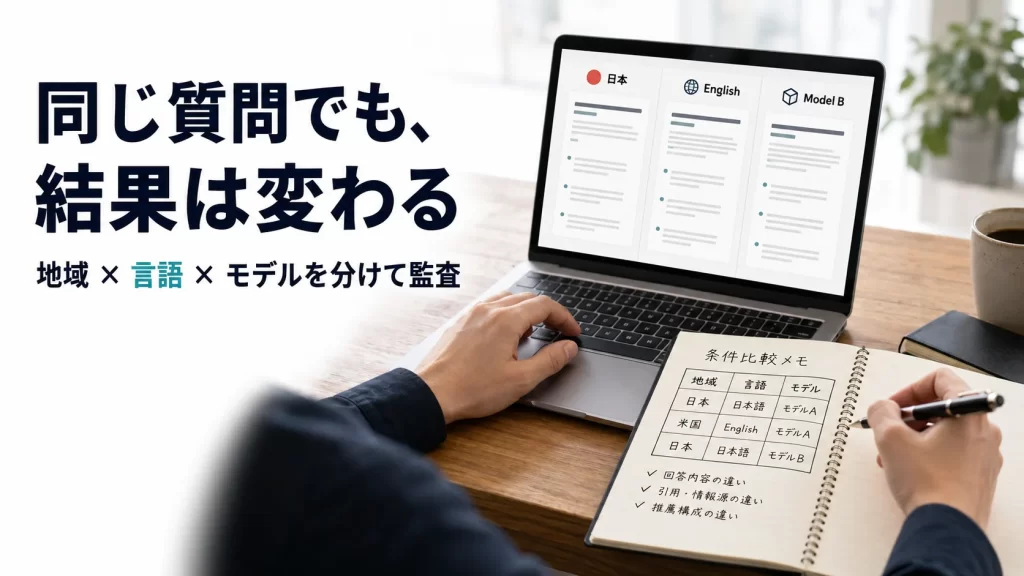
同じ質問をAI検索に入力しても、日本と海外、日本語と英語、ChatGPTとGeminiなど、条件が変われば回答・引用元・推薦企業が変わる可能性があります。ただし、数字が違っただけでは、それが地域や言語による差なのか、同じ条件でも起こる通常の揺れなのかを区別できません。差を評価するには、まず「同一条件ならどこまで揺れるか」という基準線が必要です。
この基準線の作り方は、既存記事「AI回答の再現性監査」で扱っています。本記事は、その基準線がすでにある前提で、地域・言語・モデルを変えたときの条件間の差を比較します。条件IDを付けた実験行列を作り、回答・引用・推薦の3軸で基準条件との差を読み、どの地域・言語・モデルだけが弱いのかを切り分けて、改善の優先度につなげます。
読み終えると、AI検索の地域差・言語差を再現できる形で確認する手順と、結果の読み方、差が見つかったときの改善の進め方が分かります。
地域・言語・モデルの差は、条件を一つずつ変えて確認する
この節で決めるのは、比較の進め方です。地域差・言語差を確認するときに最も重要なのは、地域、言語、モデルを一度に変更せず、確認したい因子だけを変えることです。
一度に変えてはいけないのは、各サービスが利用者の位置や言語などの条件に応じて結果を調整する場合があり、複数の条件を同時に変えると、その影響を分けられないためです。ChatGPT Searchは、IPアドレスから推定したおおよその位置情報を、地域に合った検索結果を返すために利用する場合があります。端末の位置情報を許可した場合は、さらに具体的な位置情報を利用できます。また、Memoryが有効な場合には、検索クエリの書き換えに関連する記憶が使われることもあります。
Googleも、検索結果を現在の地域に合わせて調整すると説明しています。検索結果の言語についても、入力した言語だけでなく、Googleの設定、端末の言語、現在地など複数の要素から判断します。Perplexityも、プロフィールで回答言語やLocationを設定でき、回答をユーザーに合わせるための情報として利用しています。
つまり、「日本・日本語・ChatGPT」と「米国・英語・Gemini」を1回ずつ比べても、差の原因が地域なのか、言語なのか、モデルなのかは分かりません。そこで、比較する因子ごとに「変えるもの」と「固定するもの」を決めます。次の表は、その組み合わせを整理したものです。
| 比較因子 | 変えるもの | 固定するもの |
|---|---|---|
| 地域差 | 地域・位置条件 | 質問言語、モデル、質問文、実行時期など |
| 言語差 | 質問言語 | 地域、モデル、質問意図、実行時期など |
| モデル差 | AI・モデル | 地域、言語、質問文、実行時期など |
| 時系列差 | 実行日・期間 | 地域、言語、モデル、質問文など |
表の「時系列差」は、実行日や期間を変えて見る比較です。地域・言語・モデルの比較をするときは、実行時期も固定する条件に入れます。
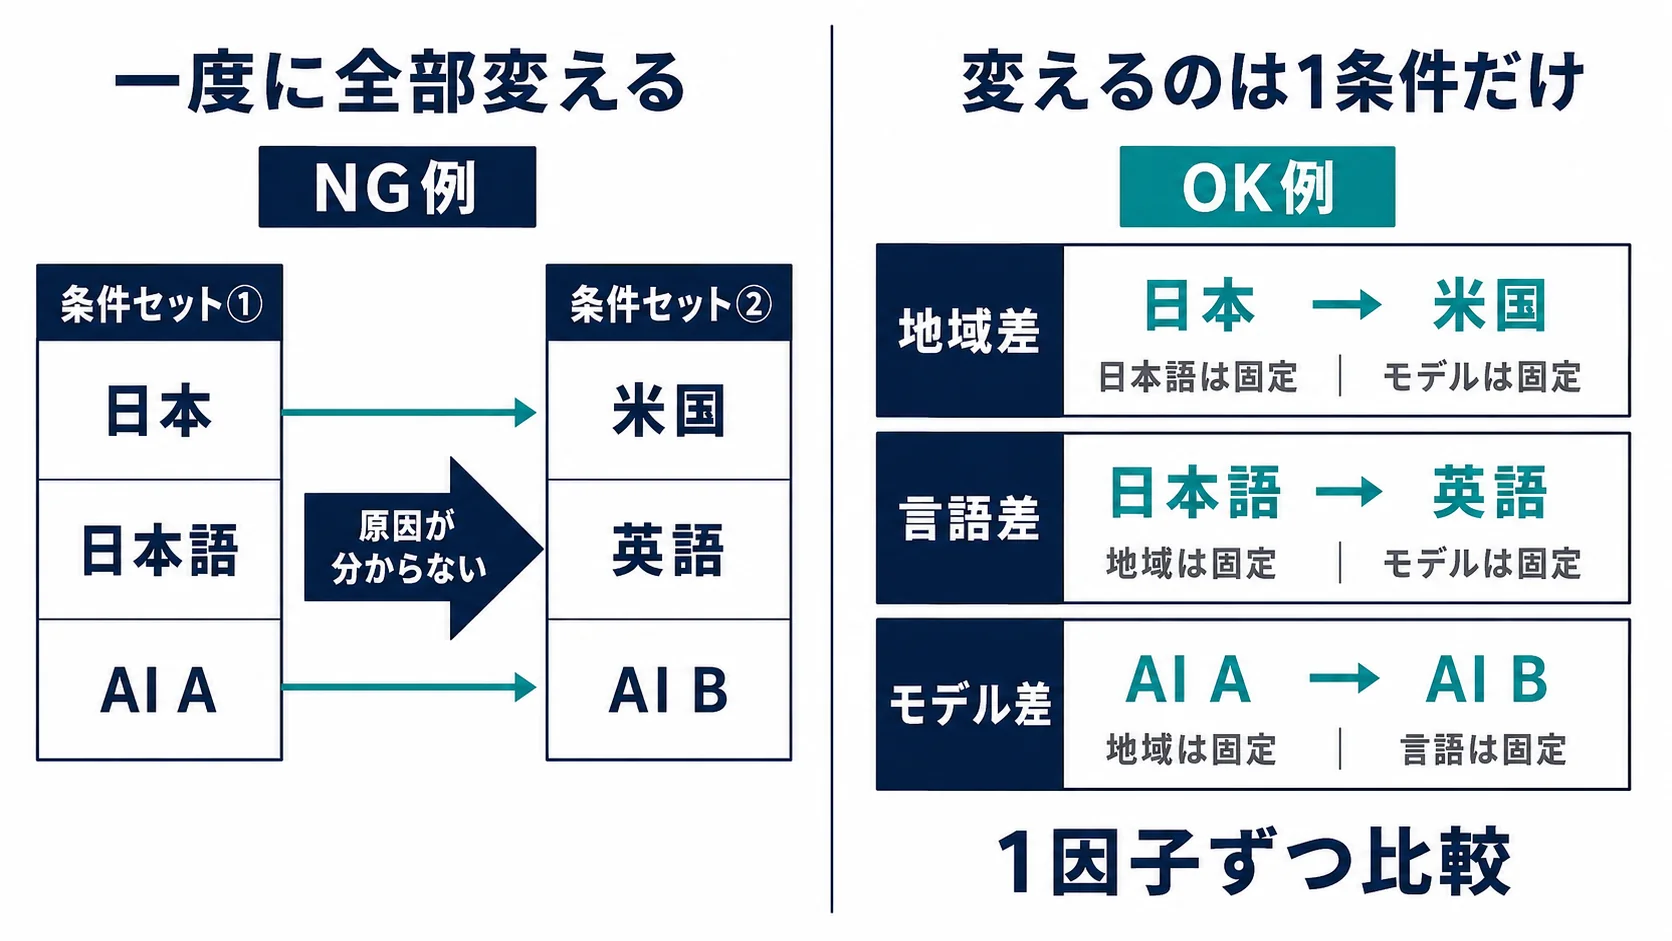
どの因子を比べる場合も、変えるのは1つだけにして、残りはできるだけ固定します。
この記事では、AIOを「AI検索での引用・推薦・可視性を改善する取り組み」の意味で使います。
地域・言語・モデル差を測る前提となるAIO全体のKPI体系は、AIOの効果測定とKPI設計で整理しています。
同一条件の通常揺れは、再現性監査の基準線として引き継ぐ
この節で決めるのは、同一条件の揺れを本記事でどう扱うかです。結論は、測り直さずに、再現性監査で作った基準線を読み込むことです。そのために、2つの言葉を分けます。条件内変動は、同一条件でも起こる通常の揺れです。条件間差分は、地域・言語・モデルを変更したときに生じる、基準条件との差です。
本記事では、条件内変動の測り方や反復回数を再設計しません。先に「AI回答の再現性監査」で作成した通常揺れの基準線を読み込み、条件間差分がその基準線を超えるかだけを比較します。基準線が未作成の場合は、先に再現性監査を完了してから、本記事の比較へ進みます。
実験行列に条件IDを付けて、比較条件を管理する
この節では、比較条件の決め方と、回答の記録方法を決めます。比較条件は回答を取得する前に固定し、各セルへ条件IDを付けます。条件IDがあれば「どの条件を何と比較したのか」が残るため、地域差・言語差・モデル差を後から混同しにくくなります。
最初は基準条件を1つ置き、比較したい因子だけを1つ変えた条件を並べます。次の表は、その最小の例です。
| 条件ID | 地域 | 言語 | AI・モデル | 基準条件から変えた因子 | 比較目的 |
|---|---|---|---|---|---|
| C001 | 日本 | 日本語 | ChatGPT | なし | 基準条件 |
| C002 | 米国 | 日本語 | ChatGPT | 地域のみ | 地域差 |
| C003 | 日本 | 英語 | ChatGPT | 言語のみ | 言語差 |
| C004 | 日本 | 日本語 | Gemini | モデルのみ | モデル差 |
C001が基準条件で、C002は地域だけ、C003は言語だけ、C004はモデルだけを変えた条件です。実際の監査では、対象市場と利用モデルに合わせて条件を増やします。地域・言語・モデルのすべての組み合わせ(フルファクタ)で比較する場合も、基準条件と一因子だけ違うペアを先に持つと、どの因子で差が生じたかを切り分けやすくなります。
各回答には、条件IDに加えて、質問IDと実行条件も保存します。次の表は、C003の回答を記録する例です。
| 項目 | 記録例 |
|---|---|
| 条件ID | C003 |
| 質問ID | Q001 |
| 質問意図 | AIO対策会社を比較したい |
| 地域条件 | 日本 |
| 質問言語 | 英語 |
| AIサービス | ChatGPT |
| モデル・モード | 実行時に表示された名称を記録 |
| Web検索 | ON |
| ログイン状態 | ログイン済み |
| パーソナライズ | 可能な範囲で固定 |
| 実行日時 | 2026-09-01 10:00 JST |
| 回答 | 原文保存 |
| 引用URL | URL単位で保存 |
| 推薦企業 | 出現順も記録 |
| 比較基準 | C001 |
質問文にも注意が必要です。日本語から英語へ変換するとき、単語を直訳するだけでは検索意図そのものが変わる場合があります。「おすすめ」「比較」「評判」「近く」などは、地域や文化によって受け取られ方が変わるためです。そのため、多言語の監査では「文字列が同じ意味か」だけでなく、検索者が達成したい目的が同じかを確認します。
自分で固定できない条件も、観測できた状態として記録する
すべてのAIサービスで、国・地域を任意に完全固定できるとは限りません。IPベースの位置推定、ログイン情報、過去の会話、検索機能の内部挙動など、利用者側から完全には制御できない条件があるためです。
この場合は、無理に「日本条件」「米国条件」と断定せず、観測できた状態を次のように残します。
- 設定した地域
- 実際の接続地域
- VPN等の利用有無
- サービス画面上で確認できた地域
- 位置情報共有のON/OFF
- アカウント・Memory・パーソナライズ状態
再現できない条件を記録せずに比較するより、「どこまで固定できたか」を残すほうが、結果の解釈に使える情報が増えます。
回答・引用・推薦の3軸で、基準条件との差を読む
この節で決めるのは、条件間の差をどの軸で読むかです。条件間比較では、各条件の内部でどれだけ分布したかを詳しく説明するのではなく、基準条件と比較条件の差を同じ3軸でそろえて読むことが中心です。次の表に、軸ごとの確認項目と、条件間差として見るものをまとめます。
| 比較軸 | 主な確認項目 | 条件間差として見るもの |
|---|---|---|
| 回答 | 主要論点、結論、ブランド言及 | 論点の欠落・追加、言及率の差 |
| 引用 | 自社URL、引用ドメイン、地域・言語 | 引用率、引用元構成、ローカルソース率の差 |
| 推薦 | 推薦有無、順位、競合構成 | 推薦率、Top3率、推薦集合の差 |
引用は、URL単位の一致だけでなくドメイン単位でも集計すると、言語によって「引用ページだけ変わった」のか、「参照する企業・媒体そのものが変わった」のかを区別できます。
条件IDごとに基準との差を記録するテンプレート
次の表は、条件ID単位で基準との差を記録するための架空の記録例です。数値自体は基準値ではありません。
| 条件ID | 比較軸 | 基準条件 C001 | 比較条件 | 基準との差 | 再現性監査の通常揺れ | 読み方 |
|---|---|---|---|---|---|---|
| C002 | 推薦率 | 70% | 55% | -15pt | ±10pt | 地域差候補。追加確認へ |
| C003 | 引用率 | 50% | 20% | -30pt | ±10pt | 言語差候補。引用元を確認 |
| C004 | Top3率 | 60% | 56% | -4pt | ±8pt | 通常揺れ内。優先度を上げない |
C002は推薦率が15pt低く、通常揺れの±10ptを超えているため、地域差の候補として追加確認に進みます。C003は引用率が30pt低く、±10ptを大きく超えているため、言語差の候補として引用元を確認します。C004のTop3率は4pt低いものの、通常揺れの±8pt以内なので、優先度を上げません。
重要なのは「30pt差なら必ず問題」と固定することではありません。差の大きさを、その質問・指標で事前に作った通常揺れと比較することです。通常揺れの外へ出た条件だけを、構造的な差の候補として次の判定へ進めます。
地域差・言語差の判定は3段階で進める
この節で決めるのは、数字の違いをどう判定につなげるかです。条件間で数字が違っただけでは、すぐに「地域差がある」「言語差がある」と断定しません。既存の再現性基準線に対して、次の図の3段階で読みます。
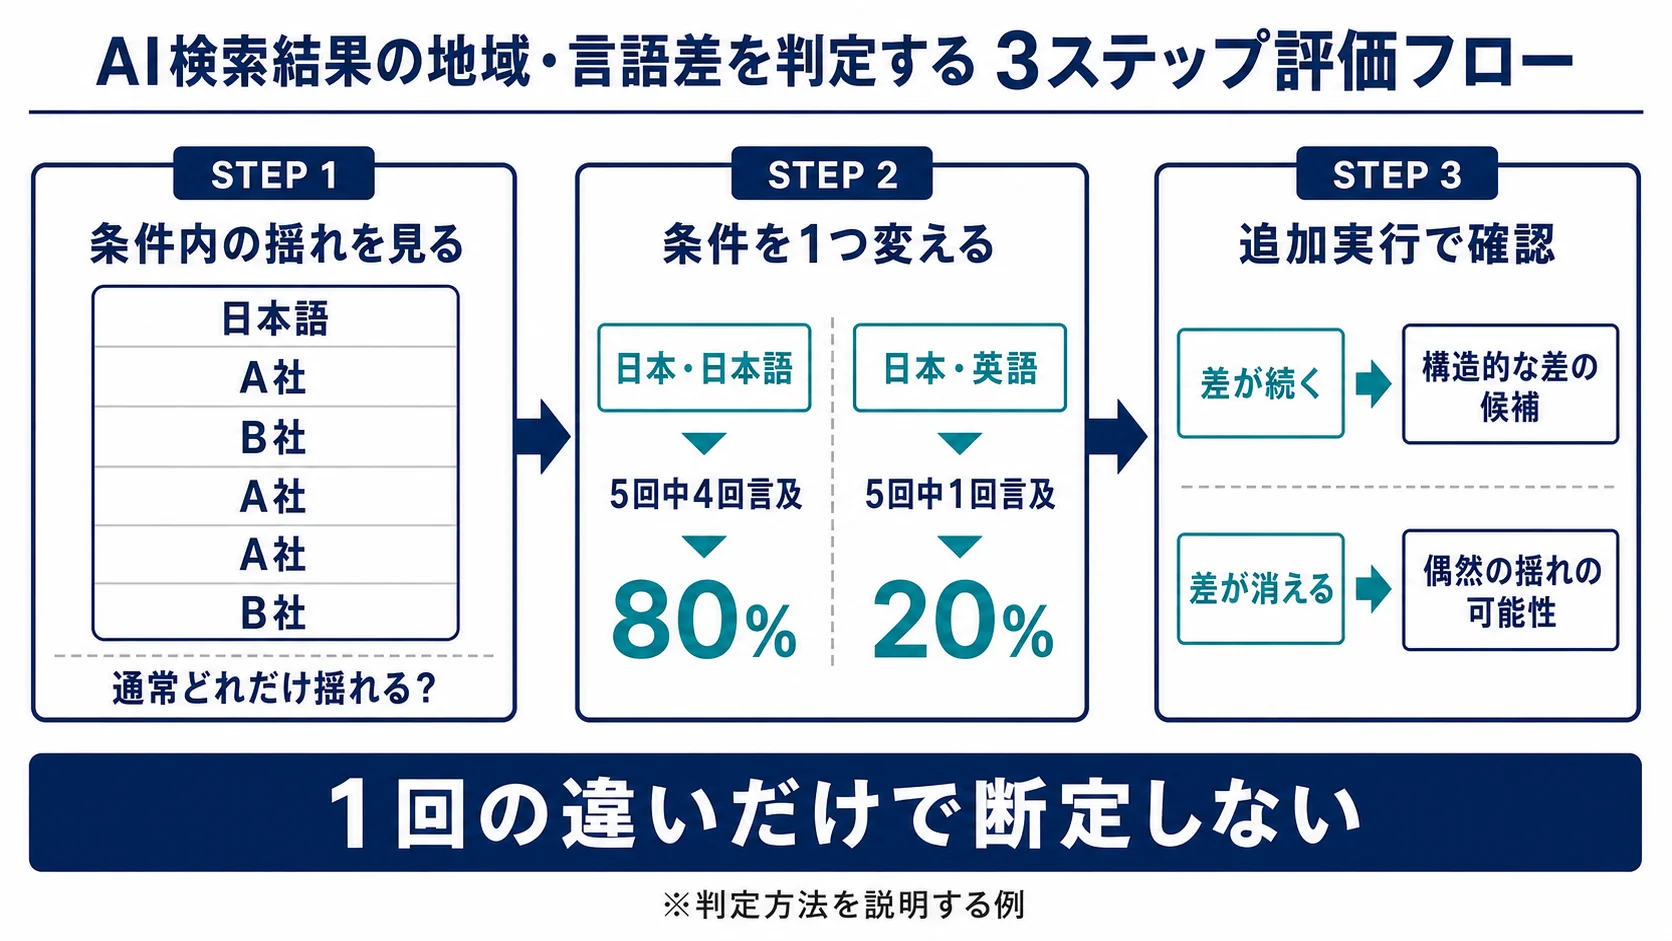
1|基準条件の通常揺れを確認する
最初に、C001など基準条件について、再現性監査で保存した通常揺れを読み込みます。ここでは反復回数や基準線の作り方を決め直しません。
2|条件間差が通常揺れを超えるかを見る
次に、地域だけ・言語だけ・モデルだけを変えたペアを比較します。たとえばC001とC003で引用率の差が大きく、再現性監査で確認した通常揺れの範囲を明確に超えるなら、言語条件に関連する構造的な差の候補として扱います。
見るのは単一の指標だけではありません。回答・引用・推薦の3軸のうち、どの軸で差が出ているかを分けます。回答内容は近いのに引用元だけが変わるケースと、推薦企業そのものが変わるケースでは、改善方法が異なるためです。
3|差が出た条件を固定したまま確認する
重要な差が見つかった条件は、その条件IDを変えずに確認します。条件を追加で変えてしまうと、地域・言語・モデルのどれが関係した差か分からなくなるためです。
差が続く場合でも、この監査で確認できるのは条件と結果の関係です。「英語にしたことそのものが原因」といった因果関係までは証明できません。検索インデックス、取得できる情報源、モデルの内部処理、地域設定、質問表現など、複数の要因が関係する可能性があります。
言語や地域で回答が変わる可能性は、研究でも示されている
この節では、条件間の差を調べる意味を、研究の報告から確認します。言語別の違いは、AI検索の運用だけの問題ではありません。
2025年に発表された「Found in Translation」は、同じ意味の問い合わせに対するLLMの回答を30言語で比較し、情報内容などに明確な言語間の不一致があることを報告しています。また、2025年のACM IUI論文「Unequal Opportunities」は、6つのLLMを対象に、移住、観光、事業立地という3分野で米国の都市・地域の推薦を調査しました。その結果、推薦される地域には地理的・社会経済的な偏りが確認されています。
これらの研究は、「日本語なら必ずこうなる」「特定のAIは必ずこの地域を優先する」と示すものではありません。一方で、言語や地理条件を変えたときのAI回答を同一の結果とみなせない可能性があることは示しています。
そのため、海外展開や多言語サイトを運営する企業では、日本から日本語で1回確認した結果だけを、グローバルなAI可視性として扱わないようにします。
AI検索の地域・言語差を監査する9ステップ
この節では、ここまでの考え方を実務の順番に並べます。再現性監査で通常揺れの基準線ができている状態から、次の順で進めます。
-
監査する質問を固定する
ブランド名を含む指名質問と、ブランド名を含まない比較・推薦質問を分けます。 -
質問の検索意図を一文で定義する
翻訳後も同じ目的の質問になっているか確認します。 -
基準条件に条件IDを付ける
地域、言語、モデル、検索機能、アカウント状態などをC001などの条件IDへまとめます。 -
再現性監査の基準線を読み込む
同一条件の通常揺れを既存監査から引き継ぎ、本記事では反復回数や基準線を作り直しません。 -
一因子だけ変えた比較条件を作る
地域だけ、言語だけ、モデルだけを変えたC002、C003、C004などを用意します。 -
回答・引用・推薦を同じ形式で記録する
回答原文、引用URL、推薦企業、順位を条件ID単位で保存します。 -
基準条件との差を3軸で計算する
回答・引用・推薦それぞれについて、基準条件との差分を記録します。 -
通常揺れを超えた条件だけ切り分ける
差が出た条件の引用元、地域、言語、ページ種類を確認し、どの条件だけ弱いかを特定します。 -
改善後も同じ条件IDで再測定する
改善前後で条件を変えず、同じ比較軸で差が縮小したかを確認します。
この9ステップの中心は、同一条件の揺れをもう一度測ることではありません。作成済みの基準線に対して条件間差を比較し、差が出た地域・言語・モデルを特定することです。
差が見つかったら、どの条件だけが弱いかを特定して改善する
地域・言語差の監査は、差を発見することが目的ではありません。改善する対象を特定することが目的です。差の出方によって、最初に確認する場所が変わります。
特定言語だけ自社が出ない場合
まず、その言語でAIが何を引用しているか確認します。自社の日本語ページは引用されるのに英語ページが引用されない場合は、次のような差がないかを確かめます。
- 英語ページそのものが不足している
- 英語ページの内容が日本語版より薄い
- 地域固有の実績や根拠が不足している
- 海外の第三者サイトから自社情報を確認しにくい
- 企業名・商品名の表記が言語間で統一されていない
日本語記事を単純に翻訳するだけでは足りません。その地域のユーザーが意思決定に必要とする情報まで、ローカライズすることを考えます。
特定地域だけ引用元が変わる場合
地域固有のページや情報源を確認します。
Googleは、多地域・多言語サイトについて、ユーザーの言語や地域に適したページを検索結果へ出すための設計を案内しており、地域別URLやhreflangの利用も推奨しています。この案内を踏まえると、AI検索だけを独立して改善するのではなく、検索エンジンや外部サイトから地域別の情報を発見できる状態を整えることが基本になると考えます。
特定モデルだけ弱い場合
全言語・全地域のコンテンツを一度に変更する必要はありません。他のモデルでは安定して引用・推薦されているのに、1つのモデルだけが弱い場合は、次の点を先に調べます。
- そのモデルが使っている引用元
- 検索機能の有無
- 回答が参照するページ種類
- ブランドを推薦する際の論点
モデル固有の問題を、サイト全体の問題と取り違えないようにします。
改善の優先順位は「重要度×差の大きさ×安定性」で決める
すべての地域・言語差を同じ優先度で改善する必要はありません。優先順位は、次の3軸で考えると整理しやすくなります。
| 評価軸 | 確認すること |
|---|---|
| 事業上の重要度 | 売上・問い合わせ・採用などへの影響が大きい市場か |
| 差の大きさ | 他地域・他言語と比べて言及・引用・推薦がどの程度低いか |
| 差の安定性 | 複数回測定しても同じ差が続くか |
たとえば、海外売上の大きい英語圏で、自社の推薦率だけが安定して低い場合は、優先度が高くなります。一方、対象顧客がほとんどいない地域で1回だけ回答が違った場合は、すぐに改善案件にする必要はありません。
AIOを前述の意味で考えると、目的は全モデルで同じ結果を作ることではなく、重要な顧客が実際に使う地域・言語・AI環境で、自社情報が正しく発見される状態を作ることです。条件IDに「どの市場のどの検索利用者を想定した条件か」も紐づけておくと、差の大きさだけでなく事業上の優先度を判断しやすくなります。
まとめ
AI検索の地域・言語差を確認するときは、同じ質問を異なる国や言語で1回ずつ試して終わりにせず、既存の再現性監査で作った通常揺れの基準線と、条件間差を比較することが基本です。
本記事では、同一条件の反復回数や通常揺れの作り方は扱いません。地域・言語・モデルの各条件へ条件IDを付け、基準条件との差を回答・引用・推薦の3軸で記録します。そのうえで、通常揺れを超えた条件だけを、地域差・言語差・モデル差の候補として切り分けます。
この切り分けができれば、「AI検索で自社が出ない」という漠然とした問題を、「英語条件だけ引用が弱い」「特定地域でローカル情報源への置換が起きる」「特定モデルだけ推薦率が低い」といった、改善できる課題に変えられます。最初は、9ステップのうち1から4、つまり質問と検索意図の固定、基準条件C001の設定、再現性監査の基準線の読み込みから始めます。
参考文献・データ元
この記事で参照した情報を確認できます。
- OpenAI「ChatGPT Search / Searching the web with ChatGPT」。ChatGPT SearchにおけるIPベースの概算位置情報、端末位置情報、Memoryの利用条件を確認。取得日:2026年9月1日。
URL: https://help.openai.com/en/articles/9237897-chatgpt-search - Google「Google が検索結果に表示する言語を判断する方法」。検索言語、端末言語、Google設定、現在地などの利用を確認。取得日:2026年9月1日。
URL: https://support.google.com/websearch/answer/13511324?hl=ja - Google「別の国の検索結果を表示する」。検索結果が現在の地域に応じて調整されることを確認。取得日:2026年9月1日。
URL: https://support.google.com/websearch/answer/873?co=GENIE.Platform%3DDesktop&hl=ja - Perplexity「How should I fill out the Profile section of my Settings?」。回答言語とLocation設定を確認。最終更新:2026年7月16日。
URL: https://www.perplexity.ai/help-center/en/articles/10354948-how-should-i-fill-out-the-profile-section-of-my-settings - Gupta, A., Mehta, M., Xu, Z., & Srikumar, V. “Found in Translation: Measuring Multilingual LLM Consistency as Simple as Translate then Evaluate.” IJCNLP-AACL 2025. DOI: 10.18653/v1/2025.ijcnlp-long.185。30言語におけるLLM回答の言語間一貫性の検証に使用。
URL: https://aclanthology.org/2025.ijcnlp-long.185/ - Dudy, S. et al. “Unequal Opportunities: Examining the Bias in Geographical Recommendations by Large Language Models.” IUI 2025, pp.1499–1516. DOI: 10.1145/3708359.3712111。LLMによる地理的推薦の偏りに関する検証として使用。
URL: https://doi.org/10.1145/3708359.3712111 - Google「多地域、多言語サイトの管理」「Google が地域対応ページをクロールする方法」。地域・言語別ページの検索向け設計とhreflangに関する確認に使用。取得日:2026年9月1日。
URL(多地域、多言語サイトの管理): https://developers.google.com/search/docs/specialty/international/managing-multi-regional-sites?hl=ja
URL(Google が地域対応ページをクロールする方法): https://developers.google.com/search/docs/specialty/international/locale-adaptive-pages?hl=ja
‹ 親記事: AIOの効果測定は何から始める?表示・引用・流入・成果、4段階で分かる全体像
関連記事
- › AI検索で競合だけが引用されるのはなぜ?引用差分の分析方法と改善手順
- › AI検索の引用率を定点観測する方法|質問セット・記録項目・KPI・変化点の見方
- › AI検索のブランドShare of Voiceを測る方法|競合別の言及シェア・掲載順位を比較する
- › AI回答の引用元を分析する方法|ドメイン・ページ種別・一次情報の偏りを可視化する
- › AI回答で自社が推薦される理由を分析する方法|評価属性・根拠・競合差を分類
- › AI推薦の評価属性を改善優先度に変える方法|影響度・実現性・競合差で施策化
- › AIO施策の実験ログを作る方法|変更点・AI回答・引用率・学びを施策単位で残す
- › AIO指標の異常アラート設計|引用率・SOV・回答差分を監視
- › AI検索で引用された後の成果を測る方法|AI流入・指名検索・CVを質問群でつなぐ
- › AI回答の引用文脈を確認|自社ページが何の根拠に使われるか
- › AI回答の再現性を確認|同じ条件で測り通常の揺れ幅を把握
- › AI検索の地域企業推薦を確認|店舗情報・口コミ・距離条件を比較
- › AI Overviews表示時のSEOクリック変化を分析する方法|同一クエリ・近似順位でCTR差を測る
- › AI ModeとAI Overviewsで引用元がどう変わる?同一質問・同一ブランドで露出差を比較する方法
- › AIO月次レポートの作り方|質問セット・AI回答・引用・競合・改善内容・次月計画を整理
- › 生成AIで自社が候補に出ないときの診断方法|質問・公式情報・第三者評価・口コミを確認
- › AI検索で自社名は出るのに公式サイトが引用されないのはなぜ?引用元・根拠情報を診断する方法
- › 生成AIに古い自社情報が出るのはなぜ?公式サイト・引用元・第三者情報を切り分ける方法
- › 従業員規模でAIOスコアに差。300人以上の企業で最も低い結果に