ChatGPTやGeminiなどのAI回答を分析すると、「実績が弱い」「価格の説明が薄い」「第三者評価が不足している」といった、自社が推薦されにくい理由が見えてきます。この記事では、AI回答の中で推薦理由として挙がるこうした項目を「評価属性」と呼びます。ただ、評価属性を一覧にしただけでは、改善は進みません。
次に必要なのは、評価属性ごとに「推薦への影響が大きいか」「競合との差があるか」「実際に改善できるか」を見きわめ、具体的な施策に変えることです。
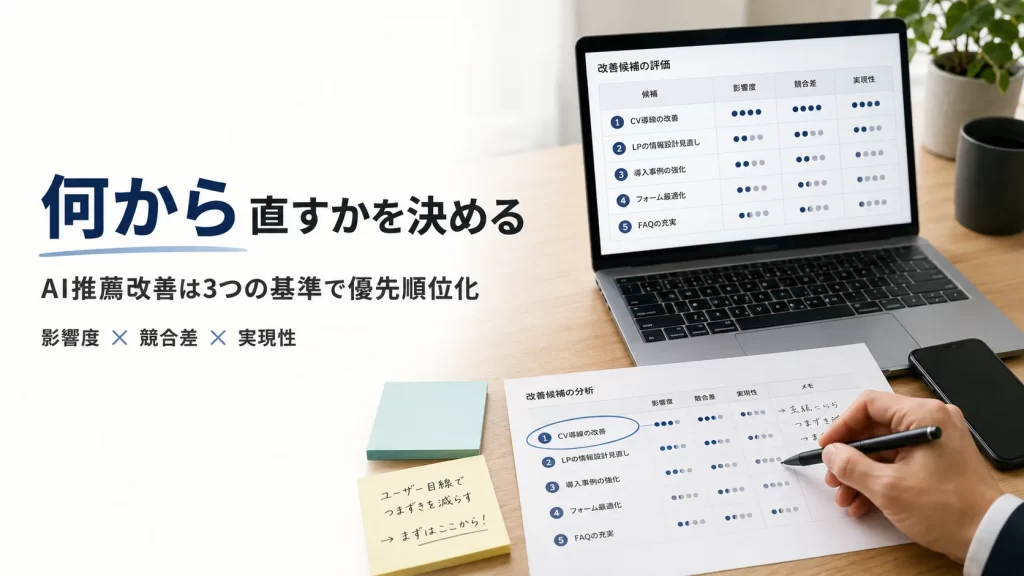
結論からいえば、AI推薦の改善では、スコアが低い属性から順に直すのではなく、影響度・競合差・実現性の3軸で優先順位を決めるのが実務的です。本記事では、評価属性の分析結果を、担当者・期限・検証方法まで決めた改善バックログ(実施する施策の一覧)に変える方法を、判断基準、点数化の例、施策への分解、再測定の順に解説します。
なお、改善優先度を決める前提となる「表示・引用・流入・成果」の測定の全体像は、AIOの効果測定とKPI設計で整理しています。
どの評価属性から直すか:「低いもの」ではなく「推薦結果を変えられるもの」を選ぶ
AI推薦の分析後に最初に決めるのは、「どの評価属性を改善すれば、推薦結果が変わる可能性が高いか」です。この節では、その選び方の前提と考え方を整理します。
前提として押さえておきたいのは、ChatGPTやGeminiなどのAIサービスが、ブランド推薦に使う評価項目や重みを、公式なランキング要因として公開しているわけではないことです。そのため、「導入実績を増やせば推薦率が必ず上がる」「構造化データを入れれば推薦順位が上がる」といった断定はできません。
一方で、AI回答を継続的に観測すると、特定の質問に対して「価格」「導入実績」「対象企業」「専門性」「第三者評価」など、推薦理由として繰り返し使われる属性を確認できます。実務では、このAI回答上で観測した評価属性を起点に、改善する対象を決めます。
たとえば、AIが競合Aを次のように推薦していたとします。
- 中小企業でも導入しやすい
- 導入実績が豊富
- サポート体制が明確
- 第三者メディアでの評価が多い
一方、自社については「機能が豊富」としか説明されていない場合、競合Aの推薦理由に対応する4つの属性が、いずれも改善候補になります。ただし、すべてを同時に改善する必要はありません。
先に選ぶのは、「推薦結果への影響が大きく、競合との差があり、かつ現実的に改善できる属性」です。次の節では、この3つの条件を軸として整理します。
改善優先順位は「影響度・競合差・実現性」の3軸で判断する
評価属性を施策に変える際は、最低でも影響度・競合差・実現性の3軸を確認します。
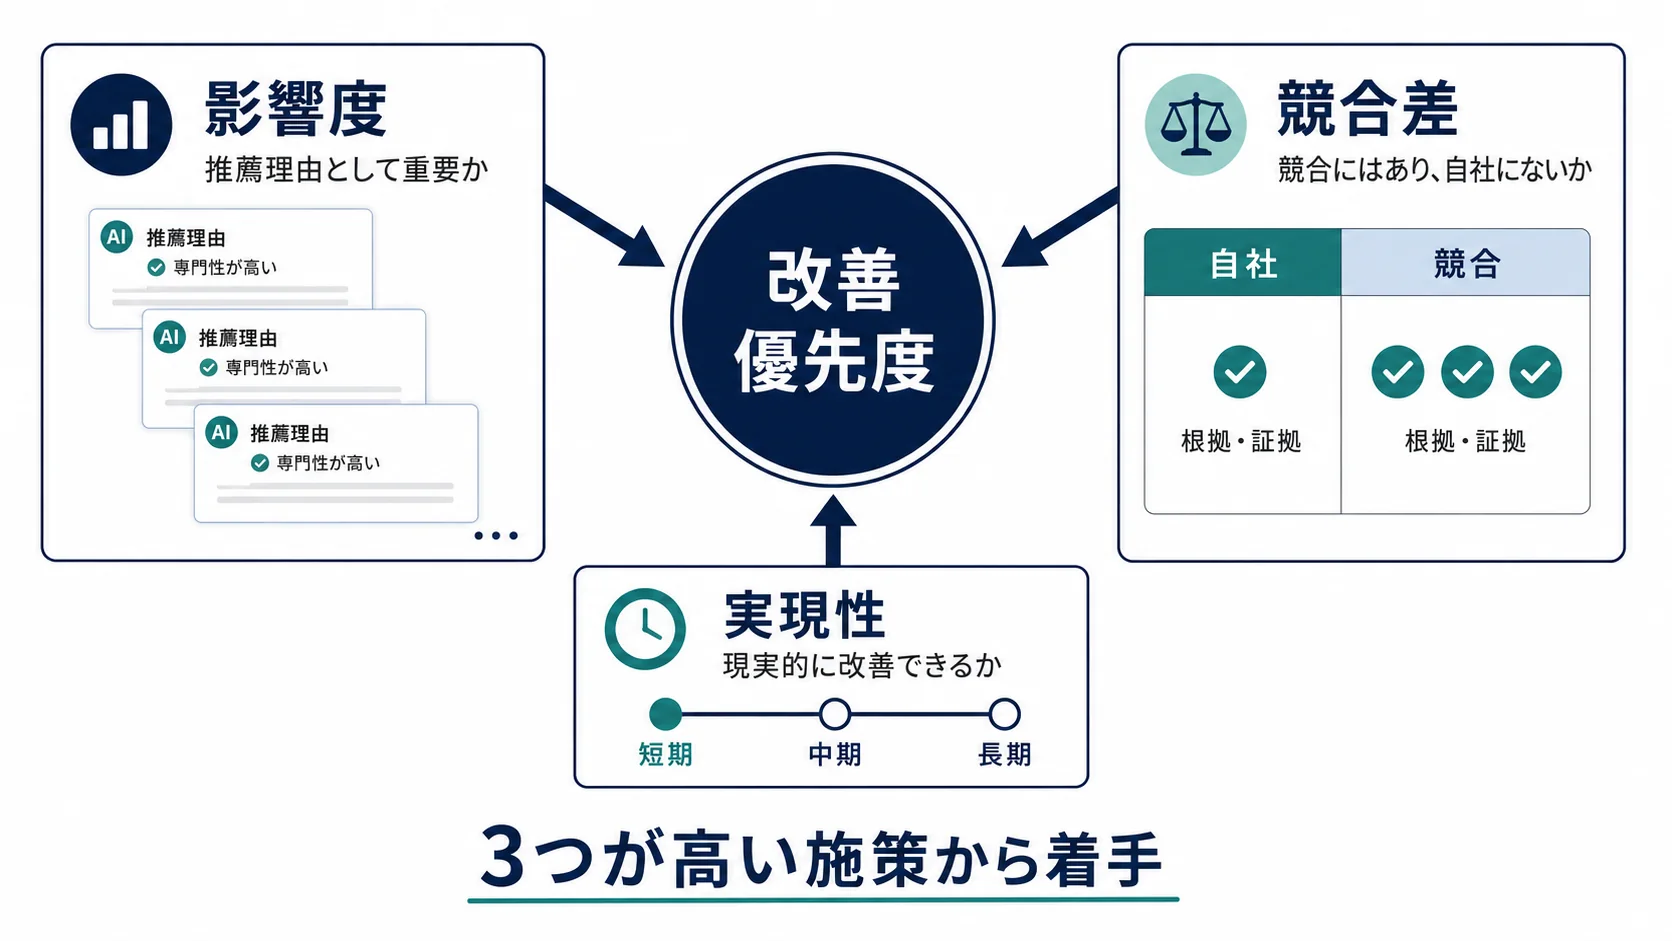
単に評価が低い項目ではなく、3軸がそろって高い属性から優先します。各軸で確認することと、満点の5点にあたる状態は、次の表のとおりです。
| 評価軸 | 確認すること | 5点の状態 |
|---|---|---|
| 影響度 | その属性が対象プロンプトの推薦理由としてどの程度使われているか | 多くの回答で主要な推薦理由になっている |
| 競合差 | 自社と推薦上位競合との情報差がどの程度あるか | 競合には明確な根拠があり、自社にはほぼない |
| 実現性 | 自社が情報・商品・運用を現実的に改善できるか | 短期間・低負荷で改善可能 |
表の「対象プロンプト」は、AIに入力する質問のことです。なお、この3軸はAIサービス内部のランキング式ではありません。観測した推薦理由を、マーケティング施策の優先順位へ変換するための実務上の判断基準です。
影響度は、出現回数に加えて「どの質問で使われたか」で見る
影響度を見るときは、評価属性の出現回数だけでなく、どの質問で使われているかまで確認します。回数が多くても、商談から遠い場面での出現であれば、優先度は上がらないからです。
たとえば「価格の安さ」が10回出ていても、情報収集段階の質問だけで出現しているなら、商談への影響は限定的かもしれません。一方で、「導入実績」が5回しか出ていなくても、次のような比較・検討段階の質問で推薦理由として使われているなら、優先度は高くなります。
- おすすめ企業を教えて
- A社とB社ならどちらがよいか
- 大企業でも導入できるか
影響度は、評価属性ごとに次の3点を確認すると判断しやすくなります。
- 出現した質問数
- 推薦理由として使われた回数
- 購買・問い合わせに近い質問で使われたか
競合差は「情報量」ではなく「推薦に使える根拠の差」で見る
競合差を見るときは、単純なページ数や記事数だけを比べてはいけません。見るべきなのは、AIが推薦理由として利用できる具体的な根拠が存在するかです。
たとえば「サポートが充実」という属性で比べるとします。
- 自社:「充実したサポートをご提供します」
- 競合:「導入時に専任担当者が付き、初期設定・データ移行・操作研修まで支援」
この場合、文字数は大きく変わらなくても、競合のほうが推薦理由として使える情報が具体的です。差の大きさは、分量ではなく、根拠の具体性で判断します。
LANYが2026年8月に公開したLLMO解説でも、AI回答から選定基準を抽出し、自社と競合の差を比較したうえで、その根拠をWeb上へ配置する考え方が紹介されています。
実現性は「コンテンツを直せば解決する問題か」で見る
評価属性には、すぐ改善できるものと、事業そのものを変えなければ改善できないものがあります。次のような問題は、すでに社内に情報があれば、比較的短期間で改善できます。
- 導入対象業種がサイトに書かれていない
- 料金体系の説明が曖昧
- 実績数が公開されていない
一方、次のような問題は、コンテンツの修正だけでは解決できません。
- 導入社数そのものが競合より少ない
- 商品機能が不足している
- 第三者評価がほとんど存在しない
そのため、改善対象を「情報表現の問題」と「実態の問題」に分けて考えます。状態ごとの主な改善方法は、次の表のとおりです。
| 状態 | 主な改善方法 |
|---|---|
| 実態はあるがWeb上にない | コンテンツ追加・FAQ・事例・構造整理 |
| 情報はあるが分かりにくい | 比較表・数値化・条件明示 |
| 自社サイトだけに存在する | PR・第三者掲載・レビュー・調査データ |
| そもそも実態がない | 商品・サービス・運用改善 |
上の2行は、すでにある情報を書く、整える側の改善です。下の2行は、社外に根拠を求める、または実態そのものを変える改善で、コンテンツの修正だけでは終わりません。
コンテンツを整えるときの土台としては、Googleの生成AI検索向けの公式ガイドも参考になります。Googleは同ガイドで、独自性があり、利用者に役立つコンテンツを重視するとともに、既存SEOの基本、クロール可能性、構造化データと表示内容の整合などを推奨しています。Google AI OverviewsやAI Modeのためだけの特殊な追加要件が存在するわけではありません。
3軸を1〜5点で点数化し、改善候補を並べる
実務では、影響度・競合差・実現性を各1〜5点で評価すると、候補を比べやすくなります。たとえばBtoBサービスで、次の4属性が見つかったとします。点数は説明用の例です。
| 評価属性 | 影響度 | 競合差 | 実現性 | 合計 |
|---|---|---|---|---|
| 導入対象企業の明確さ | 5 | 4 | 5 | 14 |
| 導入実績 | 5 | 5 | 2 | 12 |
| サポート体制 | 4 | 3 | 5 | 12 |
| 第三者評価 | 4 | 5 | 2 | 11 |
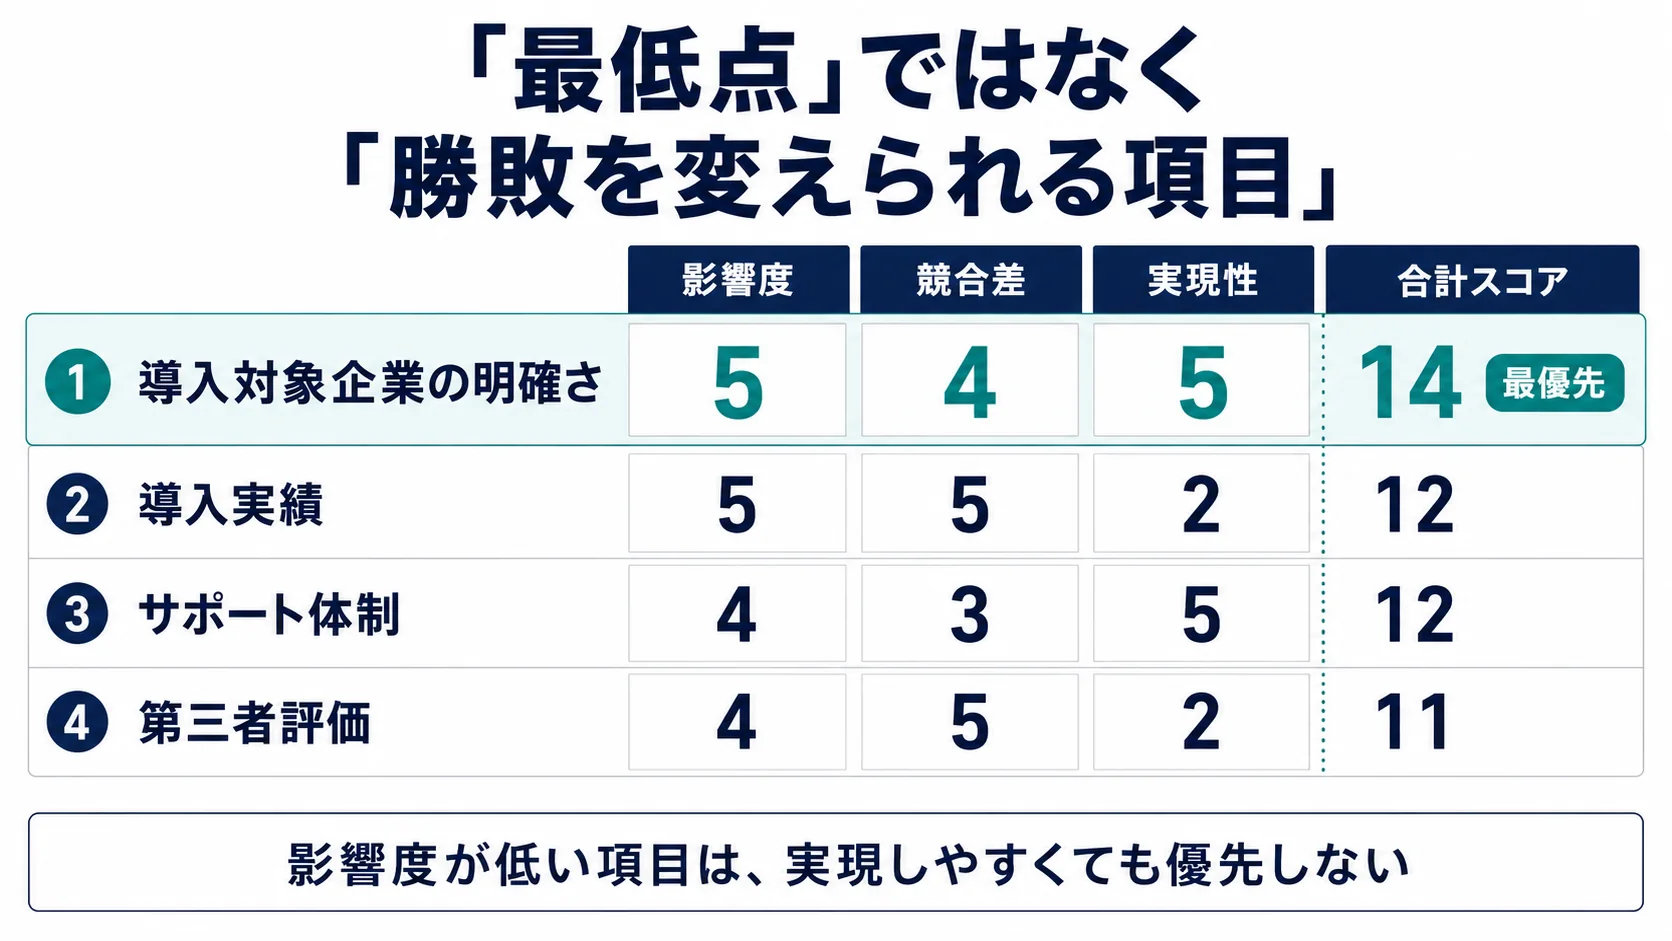
合計が最も高いのは「導入対象企業の明確さ」の14点で、この例では最初に改善する属性になります。理由は、AI回答で重視されていて(影響度5)、競合との差があり(競合差4)、自社側で短期間に改善できる(実現性5)からです。
実現性の点数だけを見れば、サポート体制も5点で並びます。しかし、サポート体制は影響度が4点、競合差が3点で、合計は12点です。改善しやすいことだけでは、先に着手する理由になりません。
反対に、導入実績と第三者評価は、影響度や競合差が高いものの、実現性が2点と低い属性です。コンテンツの修正だけでは解決しにくいため、最初の着手対象にはせず、時間をかけて取り組む課題として扱います。なお、導入実績とサポート体制は合計が12点で並びますが、この例では実現性の高いサポート体制を先に進めます。
ただし、合計点だけで決めると判断を誤ることがあります。たとえば影響度が2点しかない項目は、実現性だけが高くても最優先にはしません。そのため実務では、影響度3点未満は原則として優先対象外とする足切り条件を置く方法も有効です。
優先する属性は、担当者が動ける「具体的な施策」に分解する
優先する属性が決まったら、次に「改善する」という抽象的な言い方を、具体的な作業に分解します。たとえば「導入対象企業の明確さ」が弱い場合、「対象企業を明確にする」とだけ書いても、担当者は動けません。次の表の粒度まで落とします。
| 項目 | 内容例 |
|---|---|
| 評価属性 | 導入対象企業の明確さ |
| 現状 | 「幅広い企業に対応」とのみ記載 |
| 競合との差 | 競合は業種・従業員規模・利用シーンを明記 |
| 改善施策 | 対象業種・企業規模・利用条件をサービスページへ追加 |
| 証拠 | 導入企業データ・営業ヒアリング |
| 実装場所 | サービスページ、FAQ、導入事例 |
| 担当 | マーケティング+営業 |
| 期限 | 次回計測の2週間前 |
| 検証指標 | 対象プロンプトでの推薦理由・推薦率 |
この表は、現状と競合との差から改善施策を決め、その根拠と実装場所、担当、期限、検証指標までを1行ずつ埋める形になっています。ここまで整理して初めて、「分析結果」が「改善施策」になります。
施策は「属性→根拠→掲載場所」の順に設計する
施策を設計するときは、コンテンツ施策・PR施策・SEO施策を別々に考えるより、まず改善したい評価属性を固定したほうが整理しやすくなります。基本形は、評価属性 → その属性を証明する根拠 → 根拠を掲載する場所の順です。
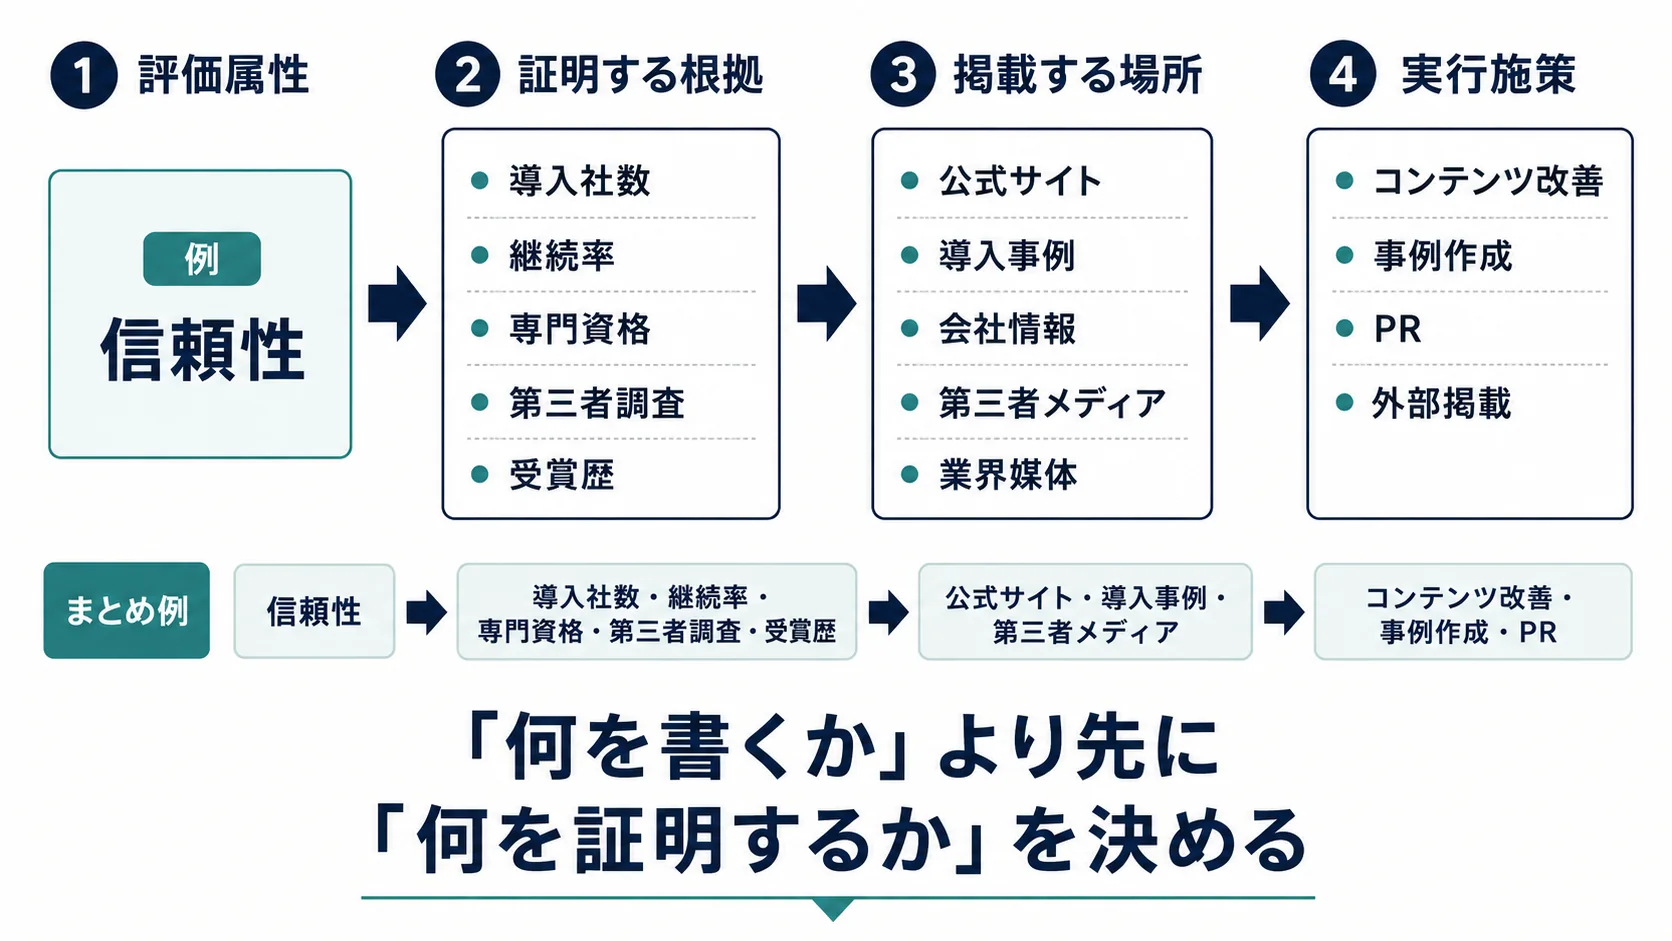
評価属性から直接コンテンツ制作へ進まず、その属性を証明できる根拠と掲載場所を先に決めると、施策が具体化します。たとえば「信頼性」という評価属性を改善するなら、次の流れになります。
- 評価属性:信頼性
- 必要な根拠:導入社数、継続率、専門資格、第三者調査、受賞歴
- 掲載場所:公式サイト、導入事例、会社情報、第三者メディア、業界媒体
LLM Monitorは2026年5月の記事で、ブランド推薦に関して、第三者情報源への言及、情報源の多様性、ブランド属性の意味的一貫性、第三者比較記事内での位置などに観測上の関連があると報告しています。ただし同社自身も、公開された正式なランキング要因ではなく、回答データから確認されたパターンとして説明しています。
この報告を踏まえると、自社サイトの記事を増やすだけでは足りない場合があります。「どの属性について、どの根拠が不足しているか」から、掲載する情報源を設計しましょう。
「改善しやすい施策」だけを優先すると失敗する
実現性を評価すると、すぐ直せる施策ばかり選びたくなります。しかし、次のような作業は簡単ですが、AI推薦への影響が大きいとは限りません。
- titleを書き換える
- FAQを増やす
- 構造化データを追加する
- 記事を1本追加する
反対に、第三者評価や顧客実績の獲得は時間がかかりますが、競合との差が非常に大きい場合には、中長期の重点施策になります。そのため、改善施策は期間で短期・中期・長期に分けます。
| 区分 | 期間 | 代表施策 |
|---|---|---|
| 短期 | 数日〜1か月 | 既存実績の明記、FAQ改善、対象条件の明示、比較表追加 |
| 中期 | 1〜3か月 | 導入事例作成、一次調査、専門記事、外部掲載 |
| 長期 | 3か月以上 | 商品改善、認知形成、第三者評価・レビュー蓄積 |
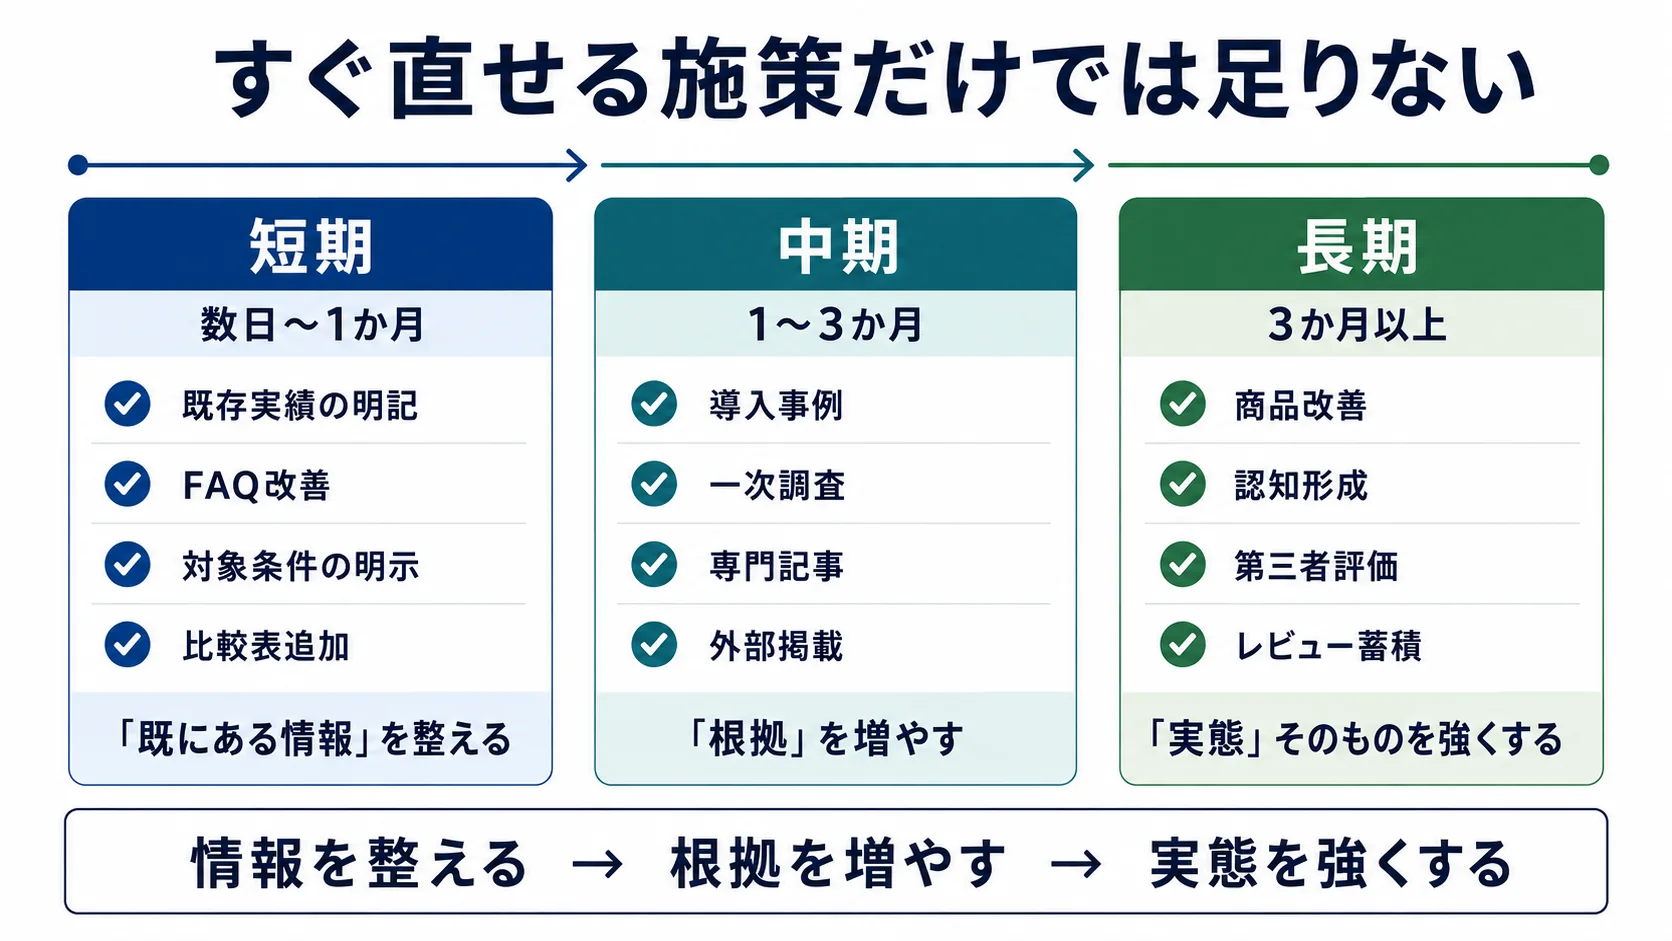
AI推薦の改善には、既存情報を整える短期施策だけでなく、根拠や事業実態を強くする中長期施策も必要です。短期施策だけで結果が動かなくても、「AIOは効かない」と判断するのは早すぎます。属性によって、必要な改善方法と、反映までにかかる時間が異なるためです。
改善後は同じ質問・条件で再測定する
改善施策を実行した後は、必ず同じ条件で再測定します。条件が変わると、改善の効果と条件の違いを区別できなくなるためです。
2026年のIEEE Conference on Artificial Intelligenceで発表されたAarabiらの研究では、ブランドの公開コンテンツを管理し、基準値を測定したうえで特定のコンテンツ変更を行い、推薦結果の変化を比較する反復型の検証フレームが提案されています。実務でも考え方は同じです。改善前と改善後で、次の項目を比較します。このうち、使用したAI・質問文・ペルソナ条件・計測回数の4つは、できるだけそろえます。
- 使用したAI
- 質問文
- ペルソナ条件
- 計測回数
- 評価属性
- 推薦ブランド
- 推薦順位
- 推薦理由
- 引用元
このとき、推薦率だけで評価しないようにします。
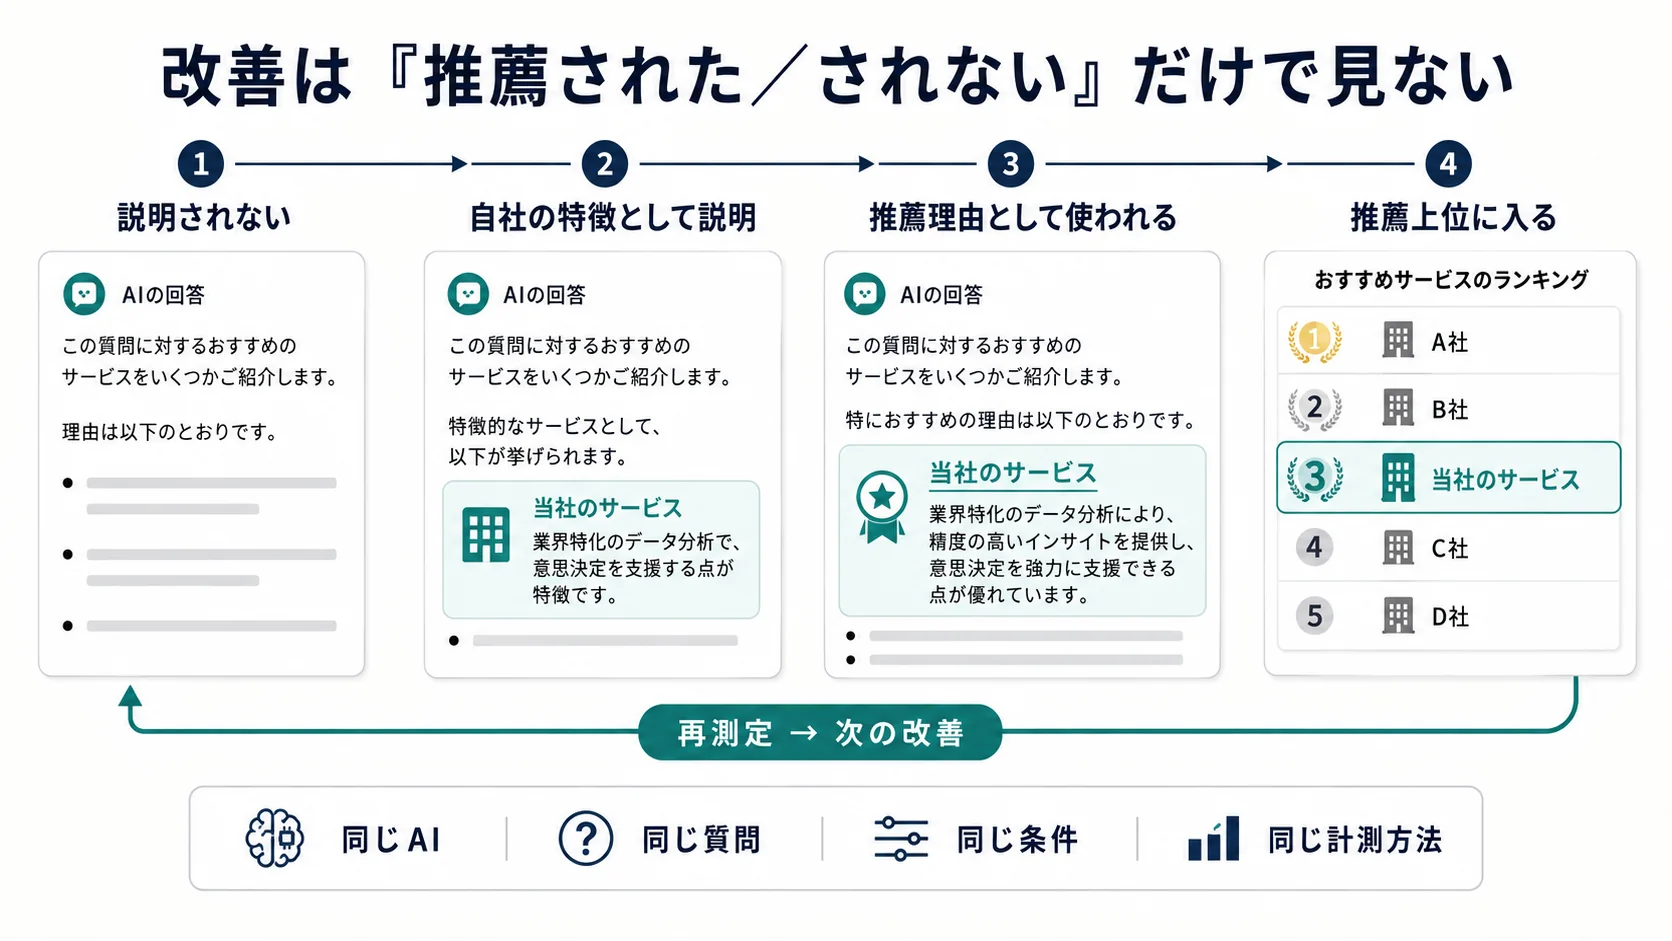
評価では、「特徴として説明されたか」「推薦理由として使われたか」という途中の変化も追うと、改善の兆候を確認できます。改善した属性が、次のように変化していれば、推薦ブランドとして上位に入る前の段階でも、改善の兆候を確認できます。
- 説明されなかった
- 自社の特徴として説明された
- 推薦理由として使われた
- 推薦ブランドとして上位に入った
1つのAIだけで優先順位を決めない
AI推薦はモデルによって結果が変わります。2026年に公開された50ブランド・5業界・3モデル・3,750回答を対象とした探索的研究では、3モデル間で「最も推薦されたブランド」が一致した割合は41.6%でした。研究対象や方法には限界がありますが、1モデルの観測結果だけで市場全体を判断することの危険性を示す材料になります。
したがって、次のような属性を上位にします。
- 複数AIで共通して弱い
- 複数質問で繰り返し現れる
- 重要な購買文脈で使われる
逆に、1つのAI・1つの質問だけで一度現れた評価属性は、すぐ大規模な施策へつなげず、再現性を確認したほうが安全です。
改善バックログは「担当者・期限・再測定日」まで決める
最終的には、分析結果を次のような改善バックログにまとめます。優先度と評価属性ごとに、施策、担当、期限、再測定日を1行で確認できる形です。
| 優先度 | 評価属性 | 施策 | 担当 | 期限 | 再測定 |
|---|---|---|---|---|---|
| P1 | 導入対象企業の明確さ | 業種・規模・利用条件をサービスページとFAQへ追加 | マーケ | 8/31 | 9/14 |
| P1 | サポート体制 | 支援範囲を具体化し導入フローを作成 | CS+マーケ | 9/7 | 9/21 |
| P2 | 導入実績 | 公開可能な実績値を整理し事例へ追加 | 営業+広報 | 9/30 | 10/14 |
| P2 | 第三者評価 | 業界媒体への調査データ提供・PR | 広報 | 10/31 | 11/14 |
バックログに最低限含めてほしいのは、次の5点です。
- 何を直すか
- なぜ直すか
- 誰が直すか
- いつまでに直すか
- 何を再測定するか
AI推薦分析の価値は、分析レポートを作ることではありません。推薦理由を具体的な仕事へ変え、改善前後を比較できる状態を作ることにあります。
まとめ:優先順位から再測定までの進め方
AI推薦の評価属性を改善施策へ変えるときは、低い属性を順番に直すのではなく、影響度・競合差・実現性で優先順位を決めます。要になるのは、AI回答で観測された「選ばれる理由」と、自社・競合がWeb上に持っている根拠の差をつなげることです。実務では、次の順番で進めます。
- AI回答から評価属性を抽出する
- 影響度を確認する
- 自社と競合の根拠差を確認する
- 実現性を判断する
- 優先属性を決める
- 属性→根拠→掲載場所へ変換する
- 担当者・期限を設定する
- 同条件で再測定する
AI推薦の仕組みそのものを完全に把握することはできません。しかし、回答を継続的に観測し、競合との差を特定し、改善と再測定を繰り返すことはできます。
まず、いま手元にある評価属性の分析結果を3軸で採点し、最初に着手する1つの属性と、その担当者・期限・再測定日を決めてください。評価属性の分析を「分かった」で終わらせず、施策と検証条件まで決めることが、AI推薦改善を継続的なマーケティング業務に変えるポイントです。
参考文献・データ元
この記事で参照した情報を確認できます。
- Google Search Central「AI features and your website」。AI Overviews・AI Modeにおいても既存SEOの基本が有効で、特別な追加要件はないことを確認。
- Google Search Central「Optimizing your website for generative AI features on Google Search」。独自性・有用性の高いコンテンツ、クロール可能性などの公式推奨事項を確認。
- LANY「LLMOとは?AIに選ばれる仕組みと対策をLANYの支援実績から解説」、2026年8月13日。AI回答の評価軸、自社・競合ギャップ、根拠配置の実務例を参照。
- LLM Monitor「How AI choose the brands they recommend」、2026年5月。ブランド推薦と情報源・属性の関係についての観測結果を参照。
- Aarabi, P., Qin, Y., Garmash, A. “A Framework for the Systematic Optimization of Brand Recommendation Rates in Large Language Models,” IEEE CAI 2026. DOI: 10.1109/CAI68641.2026.11536471。コンテンツ変更前後の反復検証フレームを参照。
- Żatuchin, D. “Who Owns the AI Recommendation? A Multi-Industry Empirical Map of Brand Category Ownership Across Large Language Models,” 2026。3モデル間の推薦差に関する探索的分析を参照。
‹ 親記事: AIOの効果測定は何から始める?表示・引用・流入・成果、4段階で分かる全体像
関連記事
- › AI検索で競合だけが引用されるのはなぜ?引用差分の分析方法と改善手順
- › AI検索の引用率を定点観測する方法|質問セット・記録項目・KPI・変化点の見方
- › AI検索のブランドShare of Voiceを測る方法|競合別の言及シェア・掲載順位を比較する
- › AI回答の引用元を分析する方法|ドメイン・ページ種別・一次情報の偏りを可視化する
- › AI回答で自社が推薦される理由を分析する方法|評価属性・根拠・競合差を分類
- › AIO施策の実験ログを作る方法|変更点・AI回答・引用率・学びを施策単位で残す
- › AIO指標の異常アラート設計|引用率・SOV・回答差分を監視
- › AI検索で引用された後の成果を測る方法|AI流入・指名検索・CVを質問群でつなぐ
- › AI回答の引用文脈を確認|自社ページが何の根拠に使われるか
- › AI回答の再現性を確認|同じ条件で測り通常の揺れ幅を把握
- › AI検索の地域・言語差を確認|地域×言語×モデルで回答比較
- › AI検索の地域企業推薦を確認|店舗情報・口コミ・距離条件を比較
- › AI Overviews表示時のSEOクリック変化を分析する方法|同一クエリ・近似順位でCTR差を測る
- › AI ModeとAI Overviewsで引用元がどう変わる?同一質問・同一ブランドで露出差を比較する方法
- › AIO月次レポートの作り方|質問セット・AI回答・引用・競合・改善内容・次月計画を整理
- › 生成AIで自社が候補に出ないときの診断方法|質問・公式情報・第三者評価・口コミを確認
- › AI検索で自社名は出るのに公式サイトが引用されないのはなぜ?引用元・根拠情報を診断する方法
- › 生成AIに古い自社情報が出るのはなぜ?公式サイト・引用元・第三者情報を切り分ける方法
- › 従業員規模でAIOスコアに差。300人以上の企業で最も低い結果に