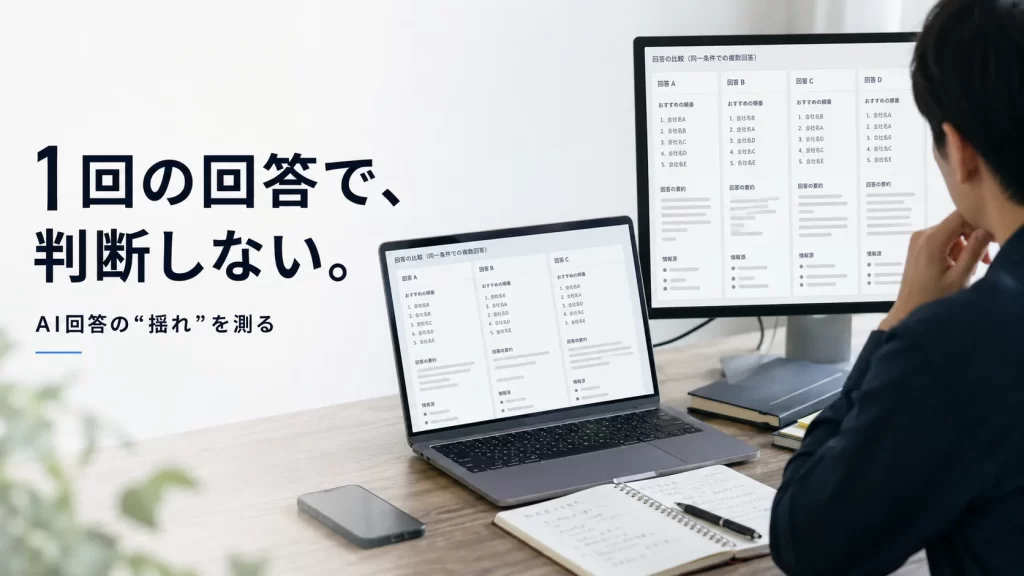
AI回答の数値が前回より下がったとき、それは本当に変化なのでしょうか。それとも、同じ条件で測っても起きる通常のばらつきなのでしょうか。単発の回答を並べるだけでは、この2つを区別できません。
区別するには、同じ時点・同じ条件で独立した反復測定を行い、回答・引用・推薦順位がどの程度ばらつくかを分布で確認します。この記事では、同じ時点・同じ条件で行う一連の反復測定を「バッチ」、その分布から決める基準の幅を「通常の揺れ幅」と呼びます。通常の揺れ幅を保存しておけば、時系列の変化がその幅を超えたときだけ、追加の確認バッチへ進む判定ルールを作れます。
この記事は、固定質問セット・対象AI・引用や推薦の判定ルールなど、定点観測の基本設計がすでに完了している担当者を対象にしています。質問セットの作り方、引用率KPI、週次・月次の観測運用は、「AI検索の引用率を定点観測する方法」で解説しています。ここで扱うのは、その次の測定品質です。
読み進めると、同一バッチでそろえる条件、反復回数の考え方、基準線を作る7つのステップ、そして変化を3段階で判定する方法が分かります。なお、この記事で「引用」と書くときは回答に出典として示されたURLを、「言及・推薦」と書くときは回答の中で自社名が挙がることや、自社が勧められることを指します。
再現性監査は何をするのか|同一時点のばらつきを基準にする
この節では、再現性監査の目的を確認します。目的は、AI回答を毎回一致させることではありません。同一時点・同一条件で複数回測ったときに生じるばらつきを、時系列変化を判定する前のノイズ基準として保存することです。ここでいうノイズとは、条件をそろえても生じる回答のばらつきのことです。
反復して測る必要がある理由を、研究から確認します。2026年2月に公開されたCuiとAlexanderの研究では、2種類のプロンプト方法、6モデル、4つのtemperature条件について各10回、計480回の実行を比較し、同じタスク・データ・設定でも分析結果に相当のばらつきが確認されました。著者らは、LLMによる分析では独立した複数回実行を行い、結果の分布を見る必要があるとしています。
したがって、再現性監査では「今回1回の回答」と「前回1回の回答」を比べません。同じ時点で得た回答群を1バッチとしてまとめ、バッチ内の分布から通常の揺れ幅を作り、次のバッチをその幅と比較することが中心になります。
定点観測と再現性監査は何が違うのか
定点観測と再現性監査は似ていますが、担当する問いが異なります。次の表は、4つの工程が答える問いと決めるものを並べたものです。この記事が扱うのは、「再現性監査」と「変化確認」の2行です。
| 工程 | 答える問い | この工程で決めるもの | 本記事での扱い |
|---|---|---|---|
| 定点観測設計 | 何を継続して測るか | 固定質問セット、対象AI、引用・言及の判定、KPI、観測頻度 | 定点観測の記事で解説 |
| 再現性監査 | 同じ時点でどこまで揺れるか | 独立反復、バッチ内分布、通常揺れの基準線 | 本記事の中心 |
| 変化確認 | 通常揺れを超えたか | 確認バッチの要否、3段階判定 | 本記事の中心 |
| 原因分析 | なぜ変わったか | モデル更新、検索環境、競合、自社施策の切り分け | 確認バッチ後に実施 |
表のとおり、再現性監査のために質問セットを作り直したり、引用率KPIを再定義したりする必要はありません。定点観測で固定した仕様をそのまま使い、同一時点の反復だけを追加して測定ノイズを見える化するのが役割です。原因分析は、通常の揺れ幅を超えた変化が確認バッチでも続いてから行います。
なお、AIO全体のKPIや「表示→引用→流入→成果」の整理は、AIOの効果測定の全体像で確認できます。
同一バッチの反復で、追加でそろえる条件は何か
定点観測ですでに固定している質問文、対象AI、判定ルールは、ここで再設計しません。同一バッチ内の結果を比較できるようにするために、次の差分条件だけをそろえます。
| 追加で固定・記録する項目 | 再現性監査での扱い |
|---|---|
| 独立実行 | 直前の回答を次の実行へ持ち込まない。原則は新規チャット・独立リクエスト |
| 実行時間帯 | 同一バッチはできるだけ近い時間帯で完了し、時点差を小さくする |
| 会話・メモリ状態 | 同一バッチ内でON/OFFや新規・継続条件を変えない |
| Web検索状態 | ON/OFFなど利用者が確認できる条件をそろえる |
| 地域・言語等 | 同一バッチ内で変更しない。固定できないものは記録する |
| API設定 | API利用時はtemperature、top_p等を同一バッチ内で固定する |
| 保存形式 | 全実行で回答全文、引用URL、推薦順、実行時刻を同じ形式で保存する |
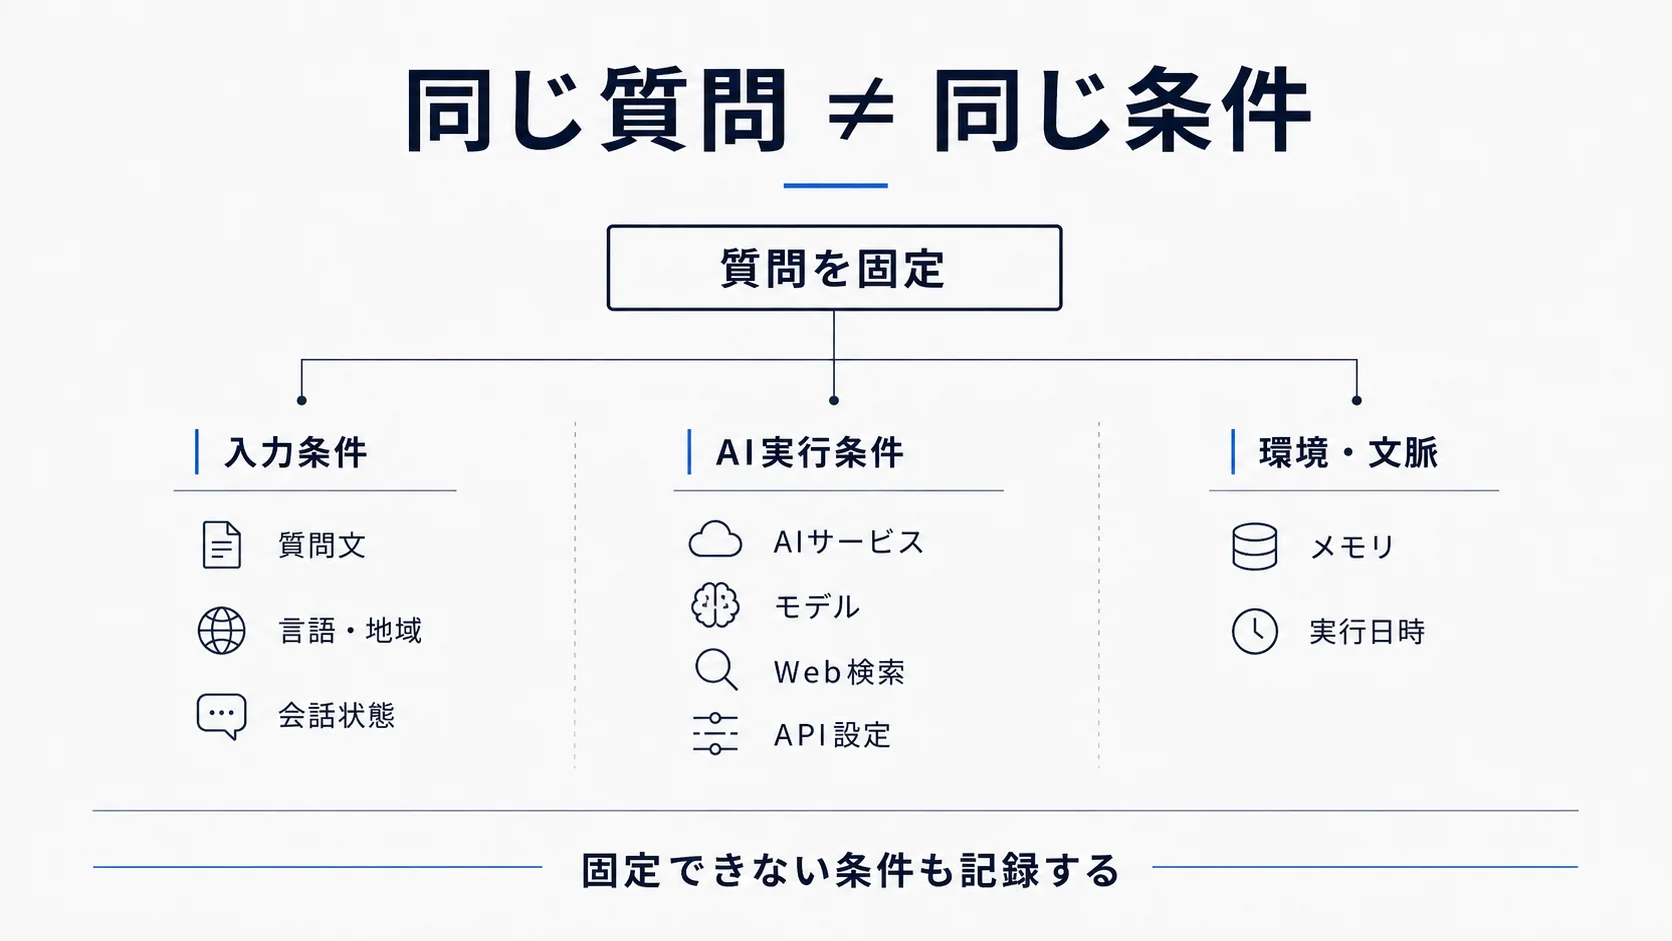
ブラウザ版などでは、内部条件を完全には固定できないことがあります。その場合でも、監査は成り立ちます。すべての変動を消そうとするのではなく、同一バッチ内で意図的な条件変更を入れず、固定できない条件を記録しておくことが、基準線を後から使える状態に保つ条件です。
回答・引用・推薦順位は、なぜ別々に分布で読むのか
1回の「出た・出なかった」では、ばらつきの大きさは分かりません。そこで同一バッチ内で、どの程度ばらついたかを見ます。回答内容、言及・推薦、引用、順位は性質が異なるため、同じ数値にまとめず、別々の指標として記録して分布を確認します。次の表は、観測対象ごとの指標例と、通常の揺れとしての読み方です。
| 観測対象 | バッチ内で記録する指標例 | 通常揺れとしての読み方 |
|---|---|---|
| 回答内容 | 主要主張の一致率、結論カテゴリ別件数 | 結論や論点がどこまで入れ替わるか |
| 言及・推薦 | 自社出現回数 ÷ 反復回数 | 同一時点での出現率の幅を見る |
| 引用元 | URL・ドメイン別の採用回数、重複率 | 引用元の入れ替わり幅を見る |
| 推薦順位 | 1位率、Top3率、中央値、最小・最大順位 | 順位の中心とレンジを見る |
| 競合 | 同時出現回数、競合別出現率 | 推薦集合そのものの入れ替わりを見る |
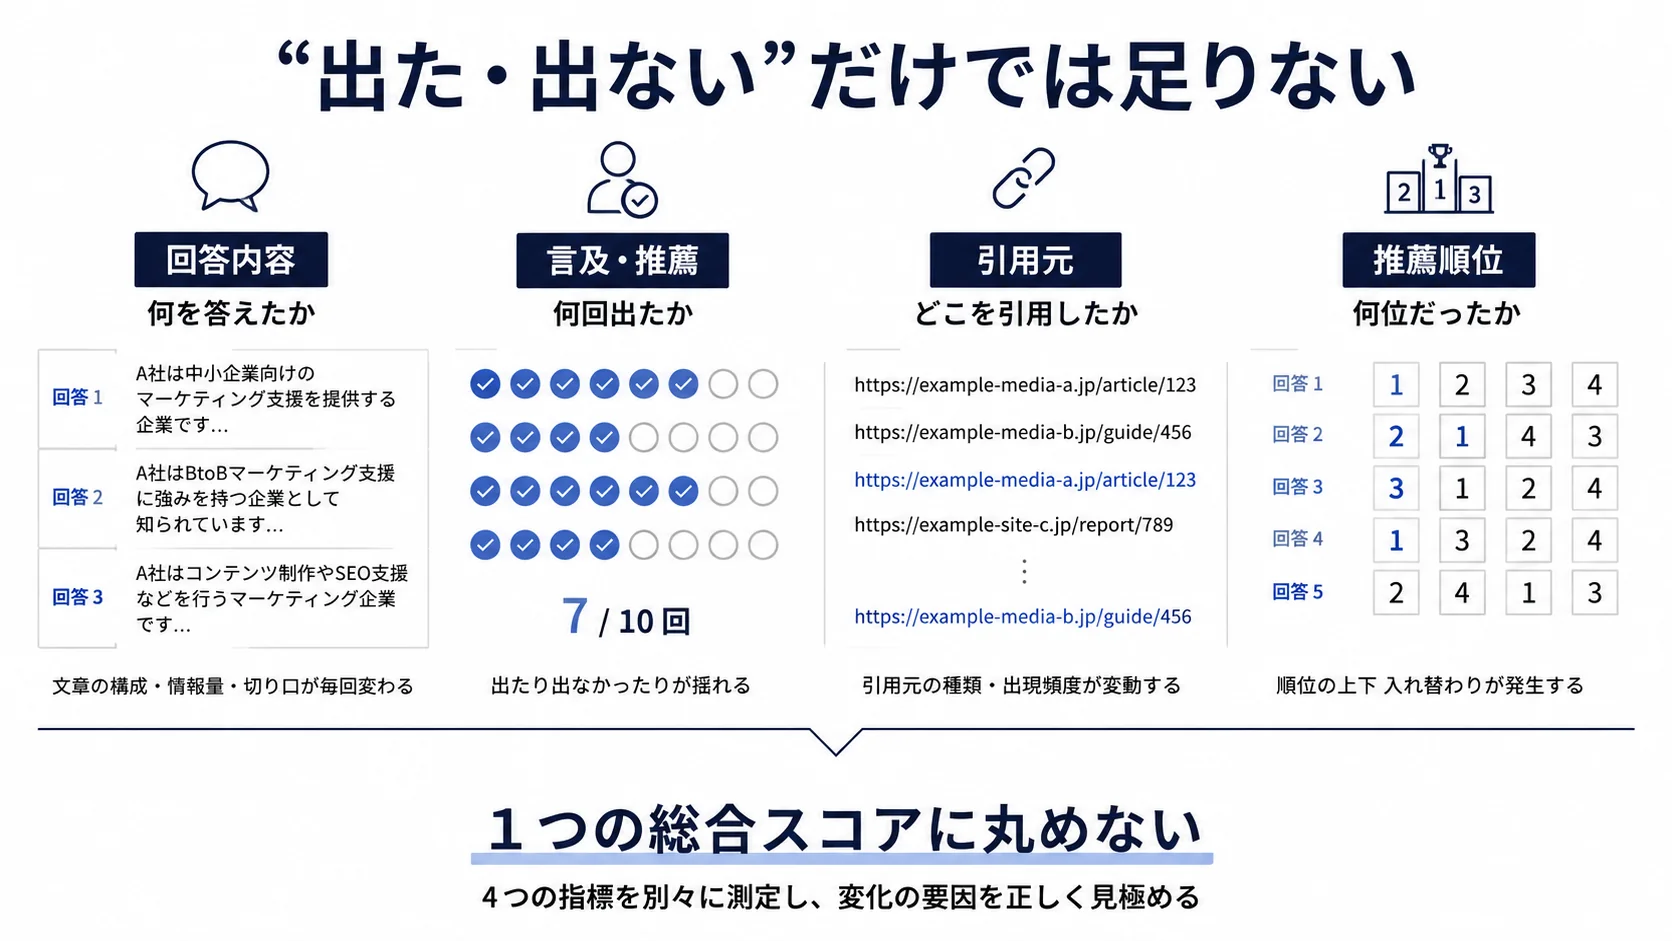
数え方の例を挙げます。10回中7回自社が推薦された場合は、「今回の観測では7/10回」と記録します。ここから「AIは70%の確率で必ず自社を推薦する」と一般化してはいけません。観測は有限回であり、そこには不確実性が残るためです。
反復回数は「何回なら正解」ではなく、判断に必要な精度で決める
反復回数に、すべてのケースで通用する唯一の正解はありません。実務では、少ない回数で揺れの有無を確認し、重要な判断ほど回数を増やす段階設計が扱いやすくなります。
目安として、5回はスクリーニング、10回は重要質問の基準線づくり、20回以上は判断が割れる質問や小さな差を確認したい場合の追加観測と位置づける方法があります。これは業界標準ではなく、監査を始めるための運用上の目安です。
ただし、10回という回数そのものを「十分」とみなすのは危険です。二項比率をWilson法の95%信頼区間で試算すると、10回中5回の観測率50%は約23.7〜76.3%、20回中10回では約29.9〜70.1%、50回中25回でも約36.6〜63.4%です。【弊社算出】これは各回を独立に近い二項事象として扱った単純な計算例で、AI回答の真の確率を保証するものではありません。
では、回数を増やせば十分かというと、そうとも限りません。2026年7月のブランド回答の分散研究では、12,933件のLLM回答を分析し、同一質問内の再実行だけでなく、質問の言い換え、モデル、言語もばらつきの要因になると報告されました。その研究条件では、5回を超える反復より、モデルや言語を広げる方がクエリ予算当たりの信頼性改善が大きい結果でした。ただし、これは中央・東欧20ブランド、8言語、3モデルを対象にしたプレプリントの結果であり、あらゆるAIO監査へそのまま当てはめる数字ではありません。
この結果を踏まえても、本記事の通常揺れ基準には、質問の言い換え、モデル変更、言語変更を混ぜません。それらは別条件の比較実験として分離します。再現性監査の1バッチでは、同一条件の反復だけを行い、その条件下での分布を基準化することに絞ります。
AI回答の再現性を監査する7ステップ
ここからは、通常揺れの基準線を作る手順です。固定質問セット・対象AI・判定ルールがある状態から、次の7つを順に進めます。
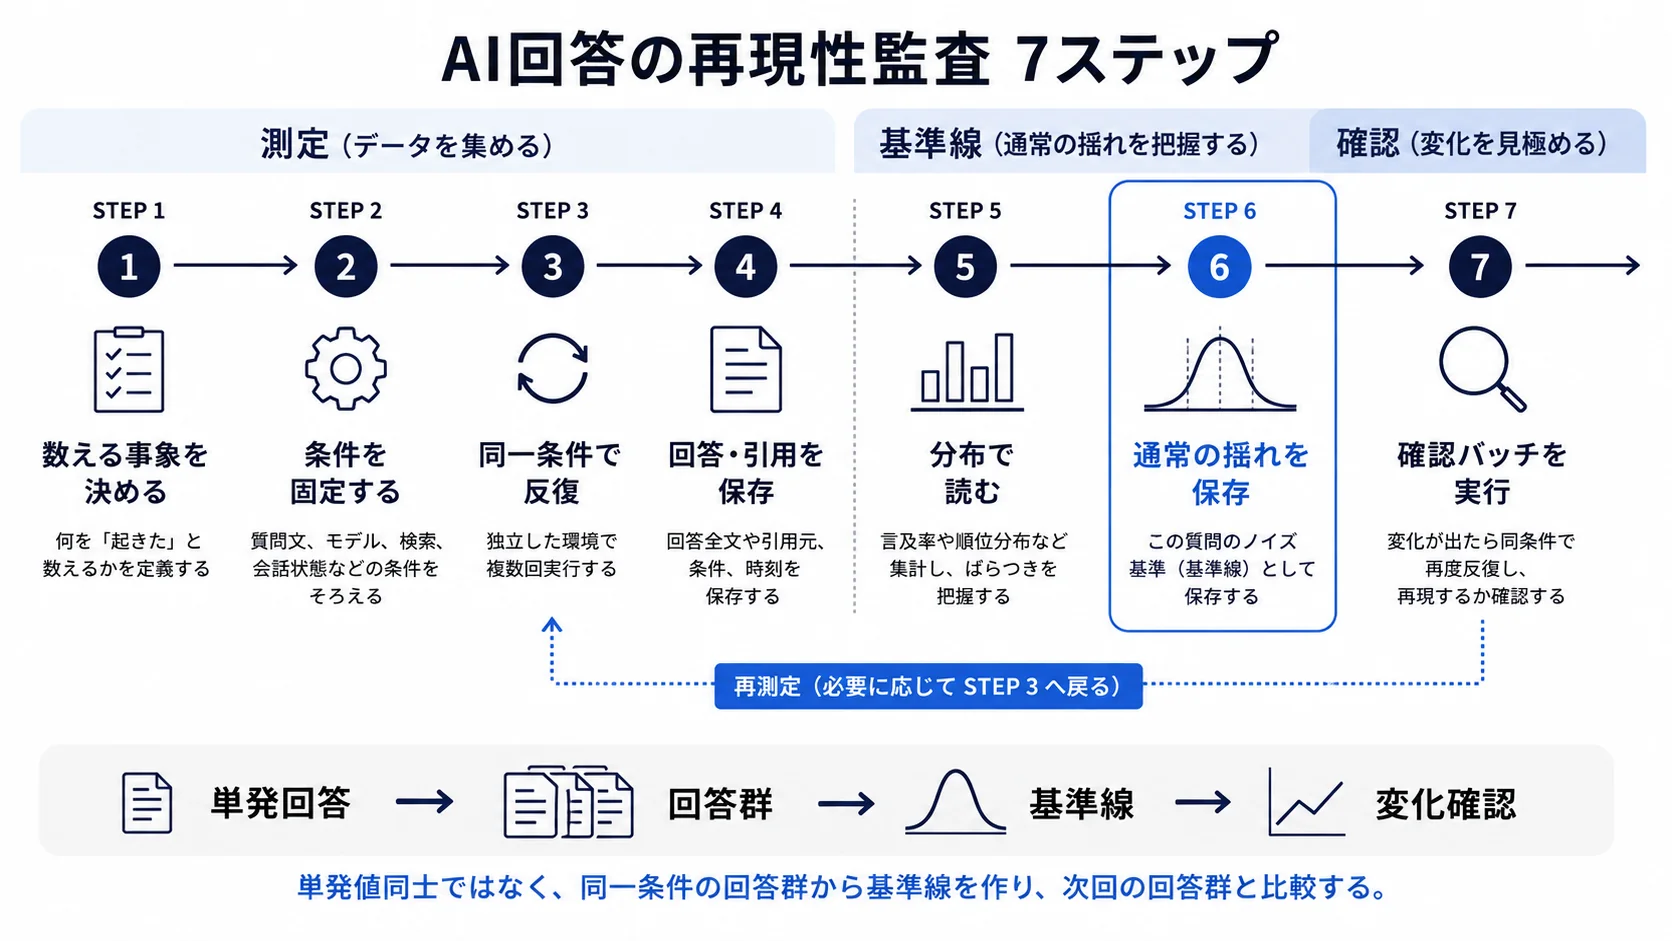
ステップ1|定点観測の既存仕様を読み込む
最初に、使用する質問ID、質問文、対象AI、引用・言及・推薦の判定ルールを確認します。ここで新しい質問やKPIは追加しません。定点観測の仕様をそのまま反復測定へ持ち込みます。
ステップ2|1バッチの独立反復回数を決める
次に、その質問で通常揺れを確認するための回数を、測る前に決めます。5回、10回、20回以上のどれにするかは、前の節の目安で選びます。途中で結果を見ながら都合よく回数を変えるのではなく、追加測定が必要な場合は別バッチとして残します。
ステップ3|同一時点で独立実行する
1回目の回答を2回目の文脈に持ち込まないよう、新規チャットや独立リクエストを使います。同一バッチはできるだけ近い時間帯で完了させ、時系列変化とバッチ内ノイズが混ざらないようにします。
ステップ4|生の回答・引用・推薦順を保存する
集計値だけでなく、回答全文、引用URL、推薦順、実行時刻、固定できなかった条件を保存します。後から判定ルールを確認したり、分布を再集計したりできる状態を残すためです。
ステップ5|バッチ内の分布を出す
保存した記録から、言及率、引用採用率、Top3率、順位中央値、順位範囲、引用URLの入れ替わりなどを集計します。回答文は主要主張をカテゴリ化し、どの結論が何回出たかを確認します。
ステップ6|通常の揺れ幅として基準線を保存する
同一時点の反復結果を、その質問・AI・条件におけるノイズ基準として保存します。次の時系列観測では、単発の回答同士を比べるのではなく、新しいバッチの分布がこの基準線からどこまで外れたかを見ます。
ステップ7|基準線を外れたときだけ確認バッチを回す
通常揺れを超える変化が出ても、すぐに異常や施策効果と断定しません。同じ仕様でもう一度独立反復し、同方向の変化が再現するかを確認します。
一時的な揺れと実質的な変化は、どのように3段階で分けるのか
異常判定では、「前回より下がった」だけでは足りません。バッチ内で観測した通常揺れを基準にし、その幅を外れた場合だけ確認バッチへ進みます。さらに、業務上意味のある変化幅も事前に決めておきます。
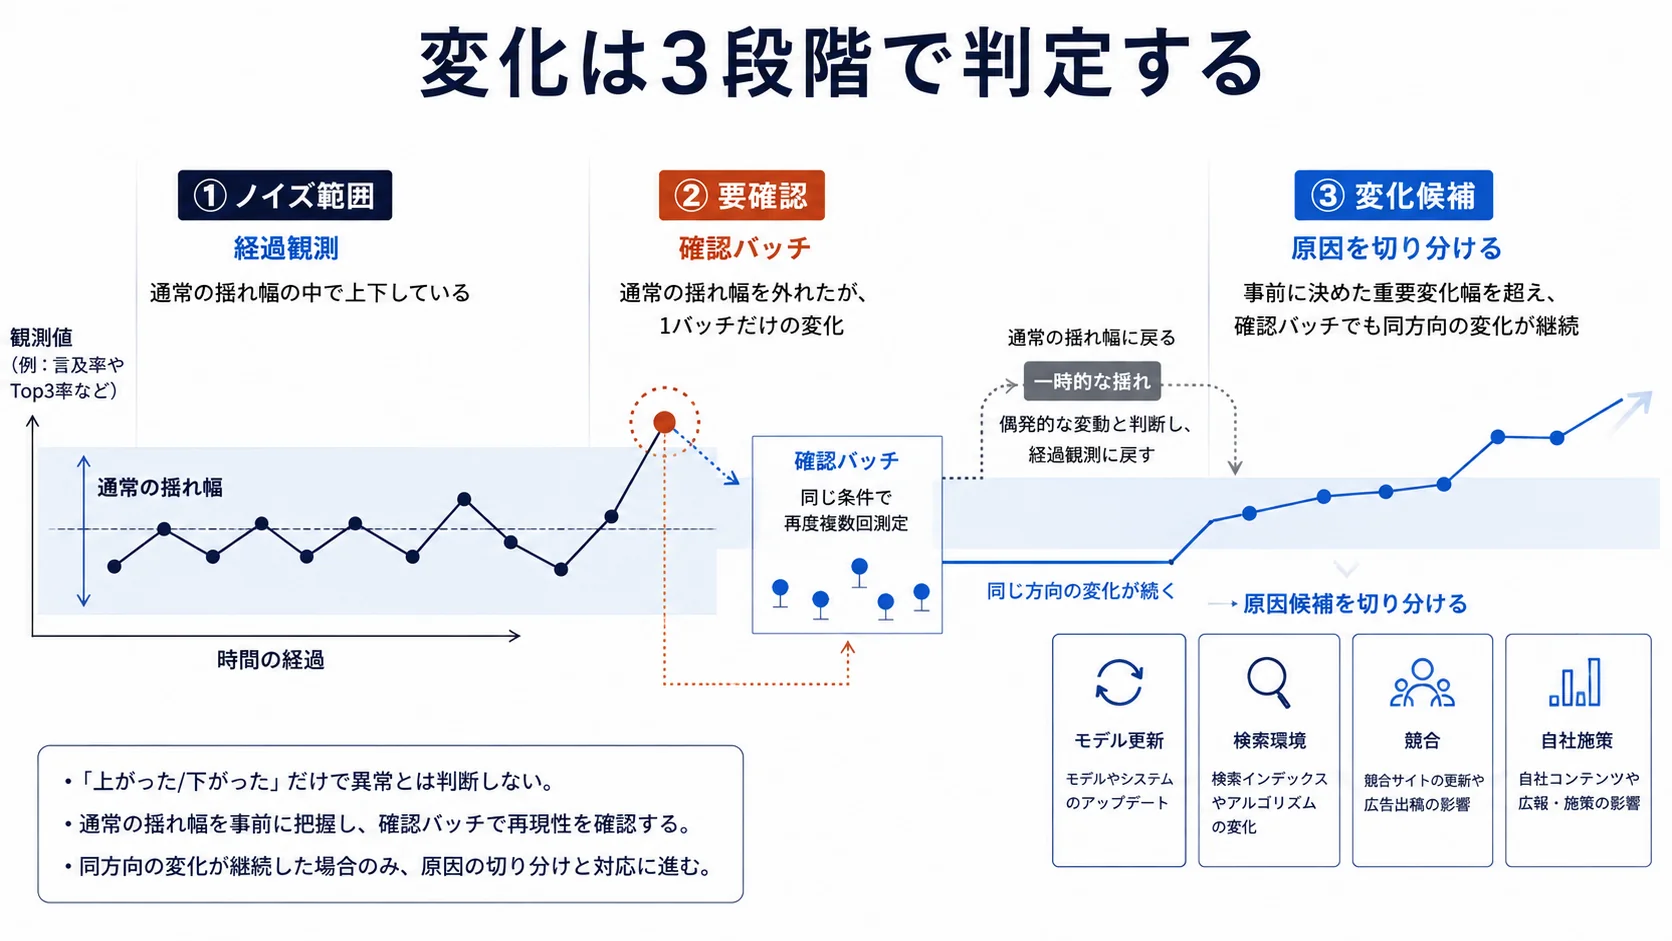
次の表は、判定ごとの状態と対応です。通常の揺れ幅を外れただけでは異常と断定せず、同条件の確認バッチでも変化が続いた場合に、原因分析へ進みます。
| 判定 | 状態 | 対応 |
|---|---|---|
| ノイズ範囲 | 基準線のばらつきの中で上下している | 原則として経過観測 |
| 要確認 | 通常幅を外れたが、1バッチだけの変化 | 同条件で確認バッチを実行 |
| 変化候補 | 事前に決めた重要変化幅を超え、確認バッチでも同方向 | モデル更新、検索環境、競合、自社施策を切り分ける |
表の「重要変化幅」は、「20ポイント下がれば異常」のような数字を後から都合よく決めないよう、先に決めておく幅です。問い合わせや経営判断に使う重要質問なら小さな変化でも追加観測し、探索用質問なら大きな変化だけを見るなど、用途ごとに決めます。
また、確認バッチで変化が再現しても、自社施策が原因とは限りません。モデル更新、検索インデックス、ニュース、競合サイト、地域条件などが同時に変わっていないかを確認してから、原因仮説を立てます。
「毎回同じ回答」でも正しいとは限らない
再現性と正確性は別の品質です。2025年のEMNLP論文では、LLMが複数回の確率的サンプルで同じ誤答を繰り返す「self-consistent error」が扱われ、既存の誤り検出手法がこうした一貫した誤りを見逃しやすいことが報告されています。
そのため、「10回中10回同じ引用だった」と分かっても、その引用や回答内容が正しいとは限りません。再現性監査の後に、引用先の実在性、本文との一致、情報の更新日、企業名・商品・数値などの事実確認を、別工程で行います。
再現性監査は「答えが正しいか」を判定する工程ではなく、「観測値がどの程度安定しているか」を判定する工程です。この2つを分けると、AIO計測の判断精度が上がります。
再現性監査バッチで、最低限残すチェック項目は何か
毎回の監査で次の項目を残しておけば、後から同条件で再測定しやすくなります。大きく分けると、バッチの条件(監査ID〜反復回数)、生の記録(回答全文〜引用URL)、集計と判断(言及率〜外部変化メモ)の3つです。
- 監査ID
- 定点観測側の質問ID
- 定点観測側の対象AI・モデル
- バッチ開始・終了時刻
- 独立実行の方法
- Web検索・会話・メモリなどバッチ内で揃えた条件
- 固定できなかった条件
- 反復回数
- 回答全文
- 自社・競合の言及有無
- 推薦順位
- 引用URL
- 言及率・Top3率・引用採用率
- 順位中央値・順位範囲
- 前回バッチとの差
- 確認バッチの要否
- モデル・検索・競合等の外部変化メモ
このバッチ記録を定点観測の時系列データへ接続すると、「数値が変わった」という結果だけでなく、「通常の揺れを超えたため確認バッチが必要」という判断まで残せます。
まとめ|通常揺れを超えたときだけ、次の確認へ進む
再現性監査は、固定質問セットや引用率KPIを作る工程ではありません。定点観測の設計が完了した後に、同一時点・同一条件で独立反復し、測定ノイズの基準線を作る工程です。
判断は3段階です。新しい観測が通常の揺れ幅の中なら経過観測、幅を外れたら確認バッチ、確認バッチでも事前に決めた重要変化幅を超えて同方向なら変化候補として原因分析へ進みます。基準線には、回答内容、言及・推薦、引用元、推薦順位をバッチ内の分布として保存します。
定点観測と再現性監査の工程を分けると、定点観測が扱う「何を継続して測るか」と、再現性監査が扱う「同じ時点でどこまで揺れるか」を別々に管理できます。単発回答の増減ではなく、通常揺れを超えたときだけ次の確認工程へ進む測定ルールが、再現性監査のゴールです。
最初の一歩として、重要な質問を1つ選び、定点観測の仕様のまま、決めた回数の独立反復を同一バッチで実行して、生の回答・引用・推薦順を保存しましょう。
参考文献・データ元
この記事で参照した情報を確認できます。
- OpenAI「Why am I getting different completions on Playground vs. the API?」更新:2026年8月。使用内容:temperature、モデル、プロンプト、APIパラメータなど出力差の条件。
OpenAIヘルプ「Why am I getting different completions on Playground vs. the API?」を見る - OpenAI「Memory FAQ」更新:2026年8月。使用内容:メモリ・過去の会話等が応答文脈として利用されること。
OpenAIヘルプ「Memory FAQ」を見る - OpenAI「Searching the web with ChatGPT」更新:2026年8月。使用内容:検索クエリの書き換え、メモリ・概算位置情報とWeb検索条件。
OpenAIヘルプ「Searching the web with ChatGPT」を見る - Jiaxin Cui, Rohan Alexander「Same Prompt, Different Outcomes: Evaluating the Reproducibility of Data Analysis by LLMs」2026年。対象:2プロンプト方式、6モデル、4 temperature条件、計480回。使用内容:LLM分析の再現性と複数回観測の必要性。DOI:10.48550/arXiv.2602.14349。
arXivで論文(arXiv:2602.14349)を見る - Dmitrij Żatuchin「Where Does the Noise Come From? A Variance-Components Decomposition of Non-Determinism in LLM Brand Answers」2026年。対象:12,933回答、20ブランド、8言語、3モデル。使用内容:ブランド回答の分散要因、反復・言語・モデル等の比較。プレプリント。DOI:10.48550/arXiv.2607.13304。
arXivでプレプリント(arXiv:2607.13304)を見る - Hexiang Tan et al.「Too Consistent to Detect: A Study of Self-Consistent Errors in LLMs」EMNLP 2025。使用内容:複数回で同じ誤答が続くself-consistent errorと再現性・正確性の区別。DOI:10.18653/v1/2025.emnlp-main.238。
ACL Anthologyの論文ページを見る
‹ 親記事: AIOの効果測定は何から始める?表示・引用・流入・成果、4段階で分かる全体像
関連記事
- › AI検索で競合だけが引用されるのはなぜ?引用差分の分析方法と改善手順
- › AI検索の引用率を定点観測する方法|質問セット・記録項目・KPI・変化点の見方
- › AI検索のブランドShare of Voiceを測る方法|競合別の言及シェア・掲載順位を比較する
- › AI回答の引用元を分析する方法|ドメイン・ページ種別・一次情報の偏りを可視化する
- › AI回答で自社が推薦される理由を分析する方法|評価属性・根拠・競合差を分類
- › AI推薦の評価属性を改善優先度に変える方法|影響度・実現性・競合差で施策化
- › AIO施策の実験ログを作る方法|変更点・AI回答・引用率・学びを施策単位で残す
- › AIO指標の異常アラート設計|引用率・SOV・回答差分を監視
- › AI検索で引用された後の成果を測る方法|AI流入・指名検索・CVを質問群でつなぐ
- › AI回答の引用文脈を確認|自社ページが何の根拠に使われるか
- › AI検索の地域・言語差を確認|地域×言語×モデルで回答比較
- › AI検索の地域企業推薦を確認|店舗情報・口コミ・距離条件を比較
- › AI Overviews表示時のSEOクリック変化を分析する方法|同一クエリ・近似順位でCTR差を測る
- › AI ModeとAI Overviewsで引用元がどう変わる?同一質問・同一ブランドで露出差を比較する方法
- › AIO月次レポートの作り方|質問セット・AI回答・引用・競合・改善内容・次月計画を整理
- › 生成AIで自社が候補に出ないときの診断方法|質問・公式情報・第三者評価・口コミを確認
- › AI検索で自社名は出るのに公式サイトが引用されないのはなぜ?引用元・根拠情報を診断する方法
- › 生成AIに古い自社情報が出るのはなぜ?公式サイト・引用元・第三者情報を切り分ける方法
- › 従業員規模でAIOスコアに差。300人以上の企業で最も低い結果に