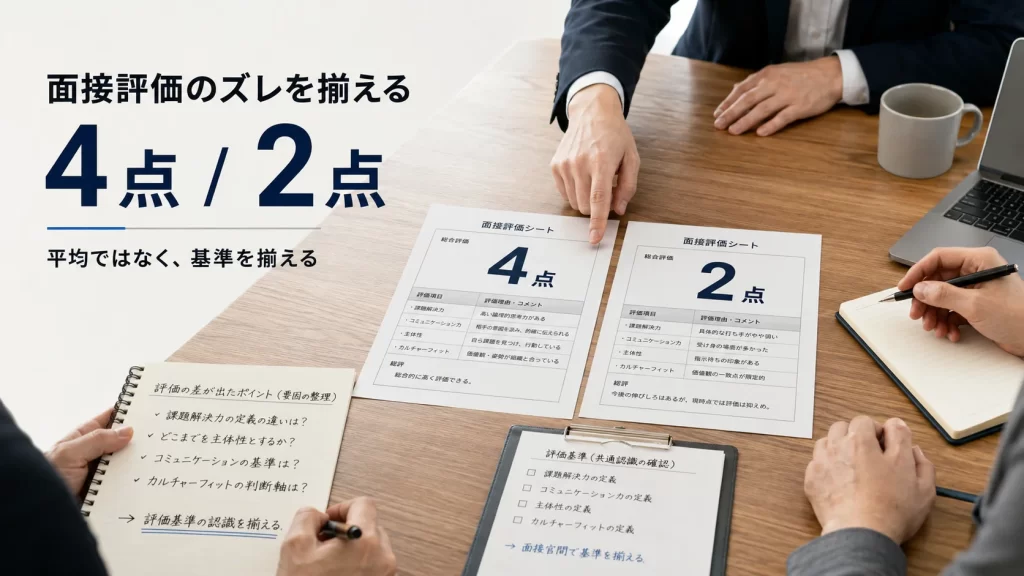
同じ候補者の回答を聞いても、ある面接官は4点、別の面接官は2点を付けることがあります。評価シートや質問を統一しても、このような差が残ることがあります。
このとき必要なのは、評価結果を平均することではありません。「どの回答事実を、どの基準に照らして、何点と判断するのか」を面接官の間で揃え直すキャリブレーションです。
キャリブレーションでは、同じ回答例を各面接官が独立して採点し、評価差が生じた理由を確認します。そのうえで評価基準を修正し、別の回答例や模擬面接で再採点して、差が縮んだかどうかを確かめます。
この記事では、評価差が見つかった後に開くキャリブレーション会議について、事前準備、採点例、差分の議論、基準の修正、再測定の順に説明します。読み終えると、会議の進め方と、45分で行う場合の時間配分が分かります。
面接評価の改善を採用ファネル全体の効果測定とつなげて考える場合は、「採用改善の効果測定は何をどう見ればいい?指標体系とPDCAの全体像」を参照してください。
面接官キャリブレーションとは、同じ評価基準を同じ意味で使える状態にすること
面接官キャリブレーションとは、複数の面接官が、同じ候補者の回答を同じ評価基準で判断できるように認識を調整する取り組みです。
目的は、「全員が同じ点数を付けること」ではありません。候補者の回答に複数の解釈が成り立つ場合、評価が完全に一致しないことはあります。問題になるのは、評価差の理由が「候補者に対する見方の違い」ではなく、「3点の意味を面接官ごとに違って理解している」といった評価基準の解釈差になっている状態です。
基準を揃える考え方は、公的な資料にも示されています。米国人事管理局(OPM)は、構造化面接について、候補者全員に同じ質問を行い、同じ評価尺度と基準で回答を評価する方法と説明しています。また、複数の面接官がいる場合も、まず個別に候補者を評価する運用が基本になります。
厚生労働省も、公正な採用選考のため、面接前に職務遂行上必要な適性・能力に基づく質問項目と評価基準を定め、できるだけ客観的かつ公平に評価することを求めています。
つまり、評価シートを作るだけでは不十分です。
評価基準を面接官が実際に同じ意味で使えているかを確認し、ずれていれば修正する工程まで含めて運用する必要があります。
キャリブレーション会議の前に4つを準備する
会議室で「うちの3点ってどのくらい?」と話し始めても、評価の精度は上がりません。材料を先にそろえておく必要があります。最低限、次の4つを準備します。
| 準備物 | 内容 | 目的 |
|---|---|---|
| 評価項目 | 主体性、問題解決力など | 何を評価するか固定する |
| 採点基準 | 1〜5点などの基準 | 各点数の意味を共有する |
| 共通回答例 | 匿名化した面接記録や模擬回答 | 同じ材料を全員で採点する |
| 個別採点結果 | 面接官ごとの点数と根拠 | 誰と誰がどこでずれたか確認する |
4つのうち特に重要なのが、「会議前の個別採点」です。
英国政府の構造化面接ガイドでも、面接官がグループで議論する前に、各自で回答を記録・採点することが推奨されています。先に意見交換すると、他の面接官、とくに影響力の強い人の判断に引っ張られる可能性があるためです。
したがって、キャリブレーション会議でも、個別採点 → 差分確認 → 議論の順番を崩さないようにします。
面接官キャリブレーション会議は6ステップで進める
キャリブレーション会議では、評価結果そのものではなく「評価差が発生した原因」を順番に取り除きます。流れは次の図のとおりです。
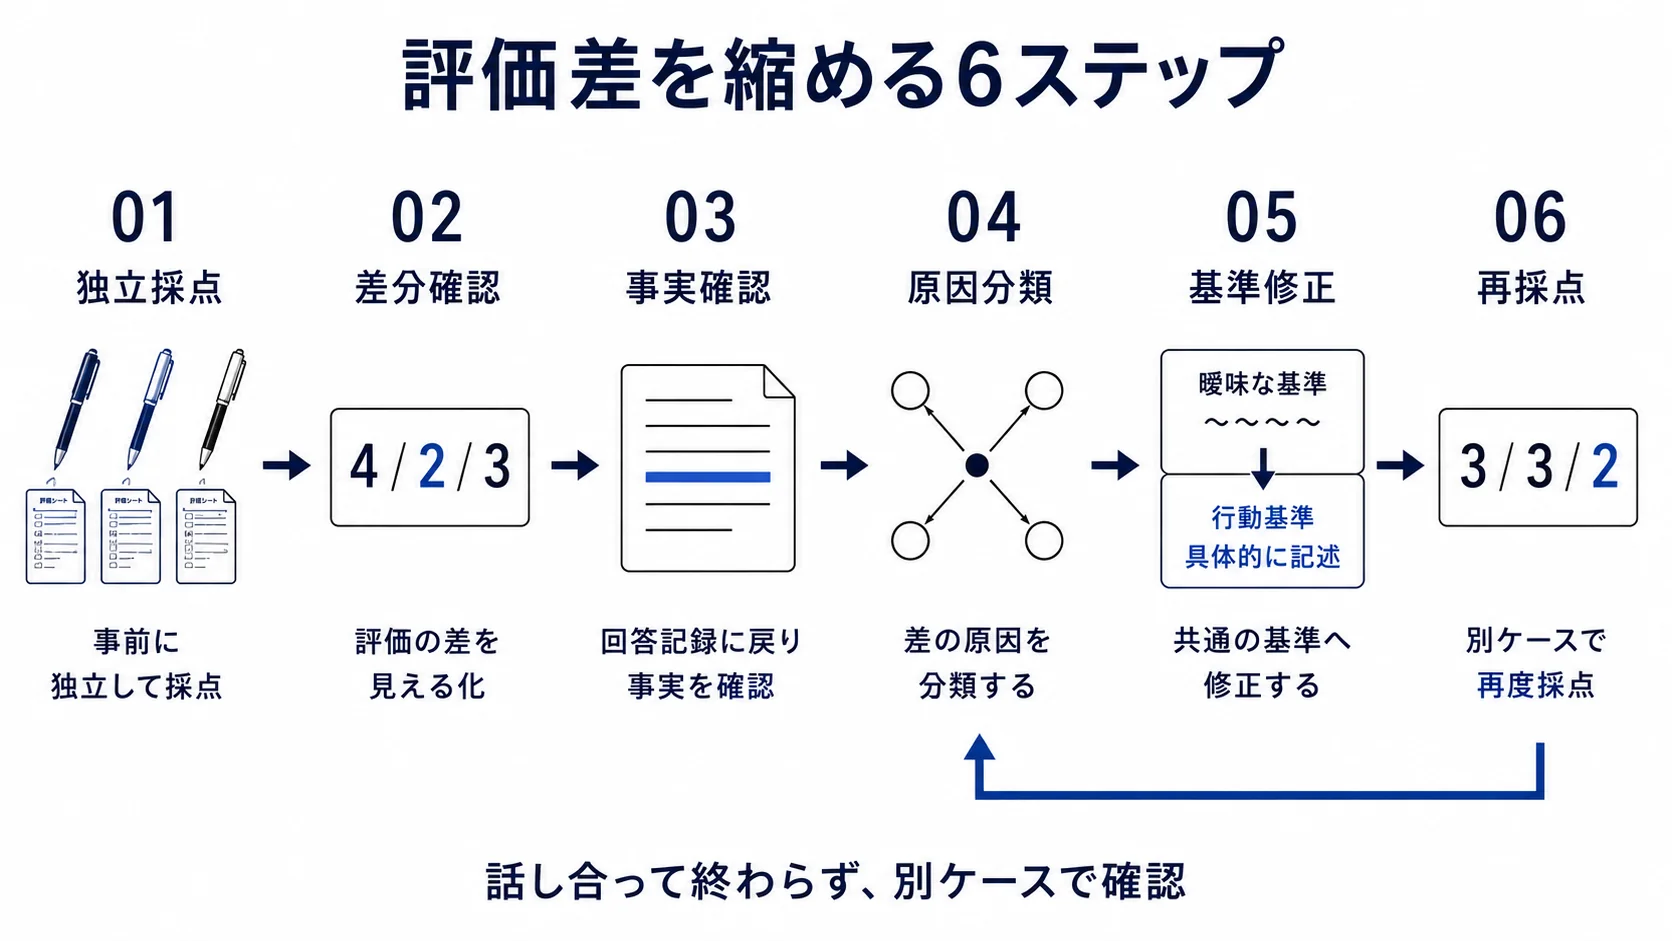
評価差を話し合って終わりにせず、基準を修正した後に別の回答例でもう一度採点し、差が縮んだかを確認するところまでが1回の会議の範囲です。
STEP1|全員が同じ回答例を事前に採点する
まず、実際の候補者の匿名化記録、過去の面接回答、模擬候補者の回答などを1〜3件用意します。面接官は会議前に、それぞれ独立して採点します。
記録するのは点数だけではありません。次の5つを残します。
- 評価項目
- 点数
- 点数の根拠となった回答事実
- 判断に迷った部分
- 不足していた情報
例えば「主体性:4点」だけでなく、「本人が課題を発見し、上司の指示を待たず関係部署へ改善案を提案したため4点」のように、観察した事実と点数をセットにします。
STEP2|評価差が大きい項目から確認する
全項目に同じ時間をかけて議論する必要はありません。5段階評価で、次のような点数であれば、優先度は高くありません。
- A面接官:4点
- B面接官:4点
- C面接官:3点
一方、次のような点数であれば、評価基準の解釈差が隠れている可能性があります。
- A面接官:5点
- B面接官:3点
- C面接官:2点
本記事では、最初の運用ルールとして「2点以上の差が出た項目」を優先して確認する方法を推奨します。これは統計上の普遍的な合格基準ではなく、限られた会議時間で大きな差から修正するための実務ルールです。
STEP3|「なぜその点数か」を回答事実まで戻って確認する
評価差を確認するときに避けたいのは、「私はこの人を高く評価します」「私はあまり良く感じませんでした」という印象同士の議論です。確認する順番は、回答事実 → 評価基準 → 点数です。
例えば問題解決力について、A面接官が4点、B面接官が2点だったとします。A面接官は「関係者を巻き込みながら自分で解決策を作ったので4点」と判断し、B面接官は「最終判断は上司だったので、自律的な問題解決とはいえず2点」と判断したとします。
ここで議論すべきなのは、どちらの面接官が正しいかではありません。論点は、「自律性とは、最終決裁まで本人が行うことなのか。それとも、自ら解決案を作って関係者を動かせれば満たすのか」という評価基準そのものの曖昧さです。
STEP4|評価差を4種類に分類する
評価が割れた原因は、次の4種類に分けると整理しやすくなります。なお、表にある行動アンカーとは、各点数の基準を観察できる行動で書いたものです。書き方はSTEP5で説明します。
| 評価差の原因 | 例 | 主な改善方法 |
|---|---|---|
| 基準の解釈差 | 「3点」の意味が違う | 行動アンカーを修正 |
| 取得情報の差 | 深掘り質問が違う | 共通の確認質問を追加 |
| 記録の差 | 一方だけ重要発言を記録 | 記録フォーマットを統一 |
| 判断対象の差 | 能力と人柄を混ぜている | 評価項目の定義を修正 |
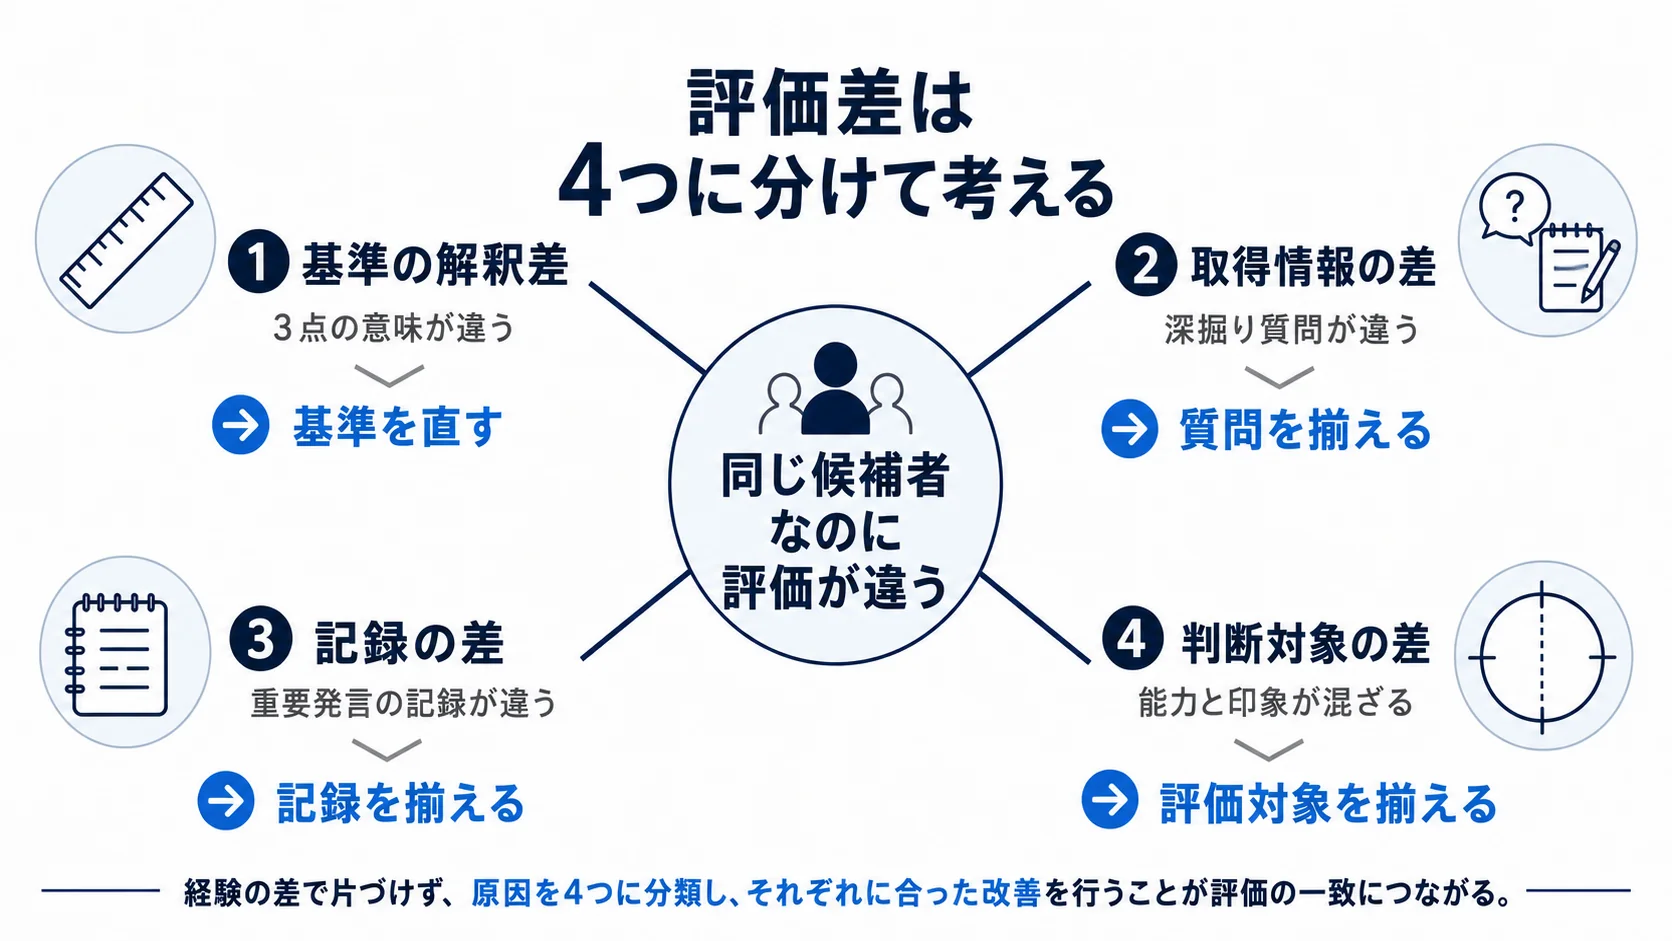
原因によって、直すべき場所は異なります。評価基準だけでなく、質問方法や記録方法まで分けて確認します。
この分類をすると、すべての問題を「面接官研修不足」として処理しなくて済みます。質問設計、評価基準、記録方法のどこに問題があるのかを、分けて判断できます。
STEP5|採点基準を「形容詞」ではなく行動例へ書き換える
差が出た項目は、評価基準を書き換えます。次の表は、問題解決力を例にした書き換えです。
| 点数 | 修正前 | 修正後の例 |
|---|---|---|
| 1 | 低い | 問題を自分で特定できず、対応も他者の指示に依存している |
| 3 | 標準 | 問題を特定し、自分の担当範囲で選択肢を比較して対応している |
| 5 | 非常に高い | 複雑な問題を構造化し、複数案を比較し、関係者を動かして結果まで改善している |
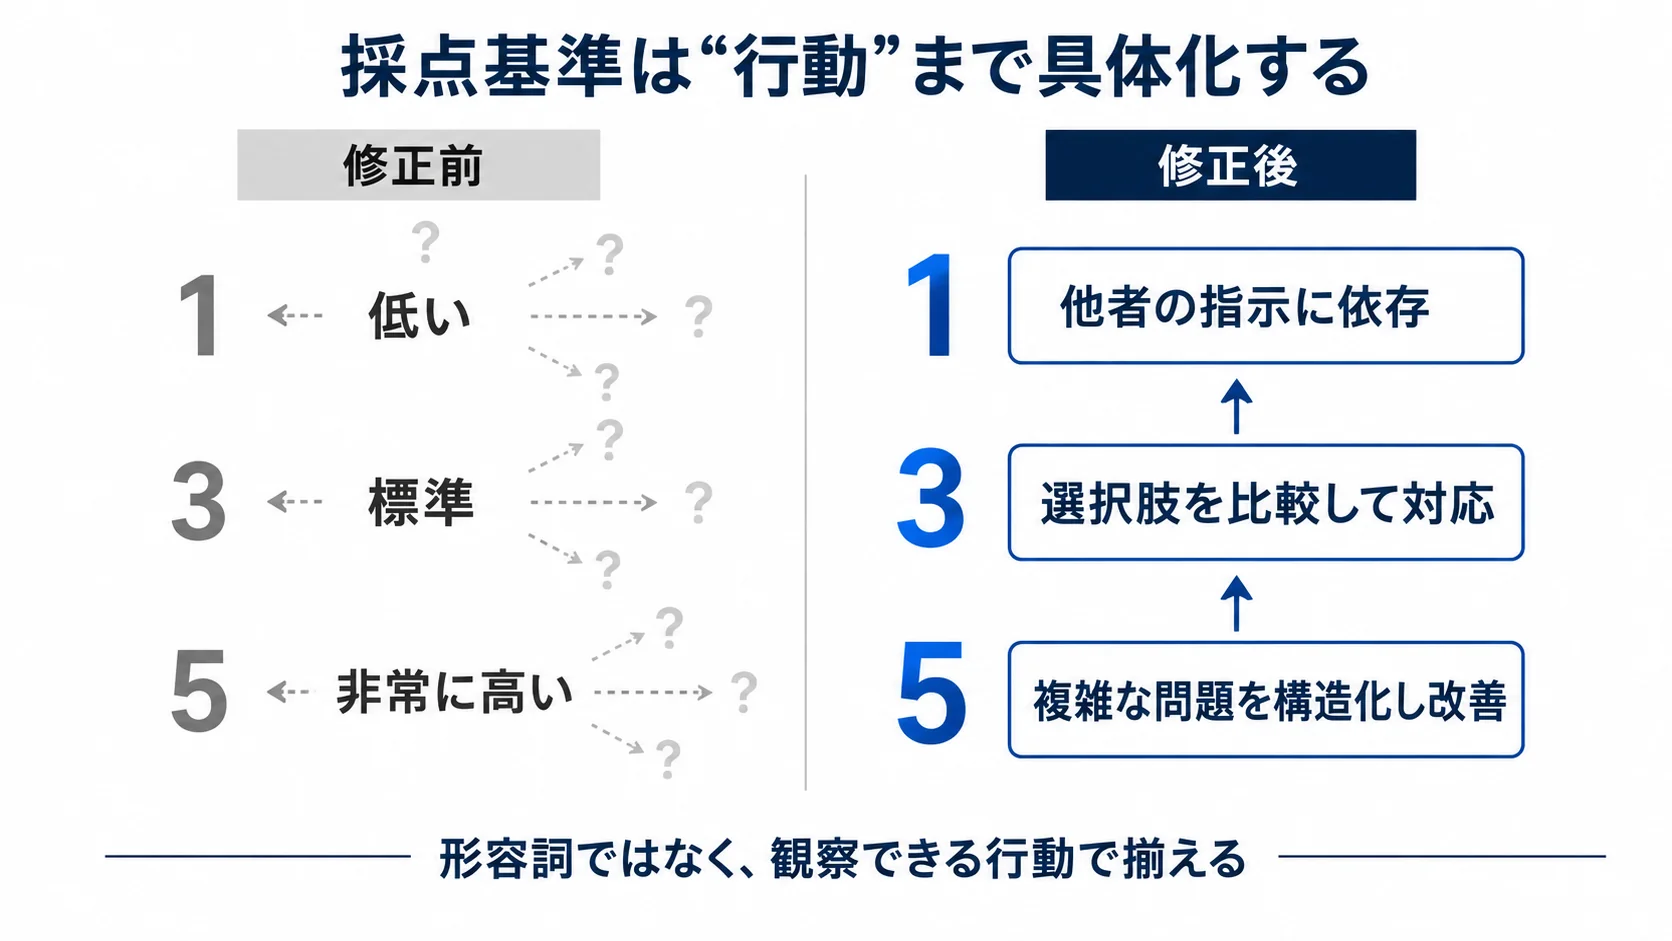
「低い」「標準」といった形容詞だけでは、解釈が分かれます。基準を観察できる行動に変えることで、点数の意味を揃えやすくなります。
この方向性は、研究でも示されています。Melchersらの研究では、評価者へ共通の判断枠組みを与えるFrame-of-Reference training(FOR訓練)と、具体的な記述を持つ評価尺度の双方が、評価精度と評価者間信頼性を改善しました。さらに両方を組み合わせることで、評価精度が追加的に改善しました。
STEP6|別の回答例を使って再採点する
評価基準を書き換えたら、その場で終わらせません。別の回答例や模擬面接を使い、もう一度各面接官が独立して採点します。
最初の回答例をそのまま再採点すると、直前の議論内容を覚えているため、表面的に点数が一致しやすくなります。可能であれば、次の順番で進めます。
- 回答例Aを採点
- 評価差を議論
- 基準を修正
- 回答例Bを採点
- 評価差を再確認
キャリブレーションは「話し合って納得した」で終わらず、別のケースで評価差が縮んだか確認して完了です。
評価基準を揃えた後は、その評価項目が実際に入社後の活躍を予測できていたかまで検証すると、採用要件そのものを改善できます。90日・180日データとの照合方法は「採用要件を入社後データで見直す方法」で解説しています。
採点例で確認する|主体性の評価差を基準の文章に反映する
ここまでの流れを、「主体性」を5段階で評価する例で確認します。質問は、「これまで、自分から課題を見つけて改善した経験を教えてください」とします。
候補者が次のように回答したとします。
「問い合わせ対応に時間がかかっていたので、過去の問い合わせを分類しました。多かった質問をFAQ化する案を上司へ出し、自分でたたき台を作りました。その後チームで修正し、運用を変更しました」
この回答に、次のように差が出たとします。
- 面接官A:4点
- 面接官B:2点
ここで「Aさんは甘い」「Bさんは厳しい」と判断してはいけません。それぞれが何を根拠にしたかを確認します。
面接官Aは「自ら課題を発見し、改善案まで動かした」点を評価しています。面接官Bは「上司へ提案しており、最終判断を自分でしていない」点を低く評価しているかもしれません。
この場合、「主体性」の定義に、次の内容を追記すれば、評価差を減らせます。
本人が課題を発見し、自ら必要な働きかけを開始していること。最終決裁権の有無は問わない
キャリブレーション会議の価値は、面接官を説得することではなく、点数の裏にある暗黙の判断ルールを言語化することにあります。
模擬面接では「質問する力」と「採点する力」を分けて確認する
評価差が大きい場合、採点基準だけが原因とは限りません。面接官によって取得している情報そのものが違う場合があります。
例えば同じ主体性を評価していても、面接官Aは「その課題には誰が最初に気づいたのですか」「あなた自身が最初に行ったことは何ですか」まで確認している一方、面接官Bは最初の回答だけで評価している場合があります。この状態では、採点表を揃えても評価は安定しません。
そこで模擬面接では、質問する力を「面接実施のキャリブレーション」、採点する力を「評価のキャリブレーション」として、次の2つを分けて確認します。
面接実施のキャリブレーション
- 共通質問を使えているか
- 必要な事実を深掘りできているか
- 誘導質問になっていないか
- 職務と関係のない情報を評価していないか
評価のキャリブレーション
- 回答事実と評価を分けているか
- 同じ行動アンカーを使っているか
- 他項目の印象を混ぜていないか
- 総合印象で点数を修正していないか
質問方法と採点方法を分けて見ることで、改善対象を特定しやすくなります。
キャリブレーション後は評価差を再測定する
研修を実施した回数ではなく、評価差が実際にどう変わったかを確認します。最低限、次の3指標から始めると運用しやすくなります。
| 指標 | 計算・確認方法 | 分かること |
|---|---|---|
| 平均評価差 | 面接官間の点数差の絶対値を平均 | 全体的なずれの大きさ |
| 1点以内一致率 | 評価差が0〜1点だった割合 | 実務上近い評価になっている割合 |
| 大幅乖離率 | 2点以上差が出た割合 | 再キャリブレーション対象 |
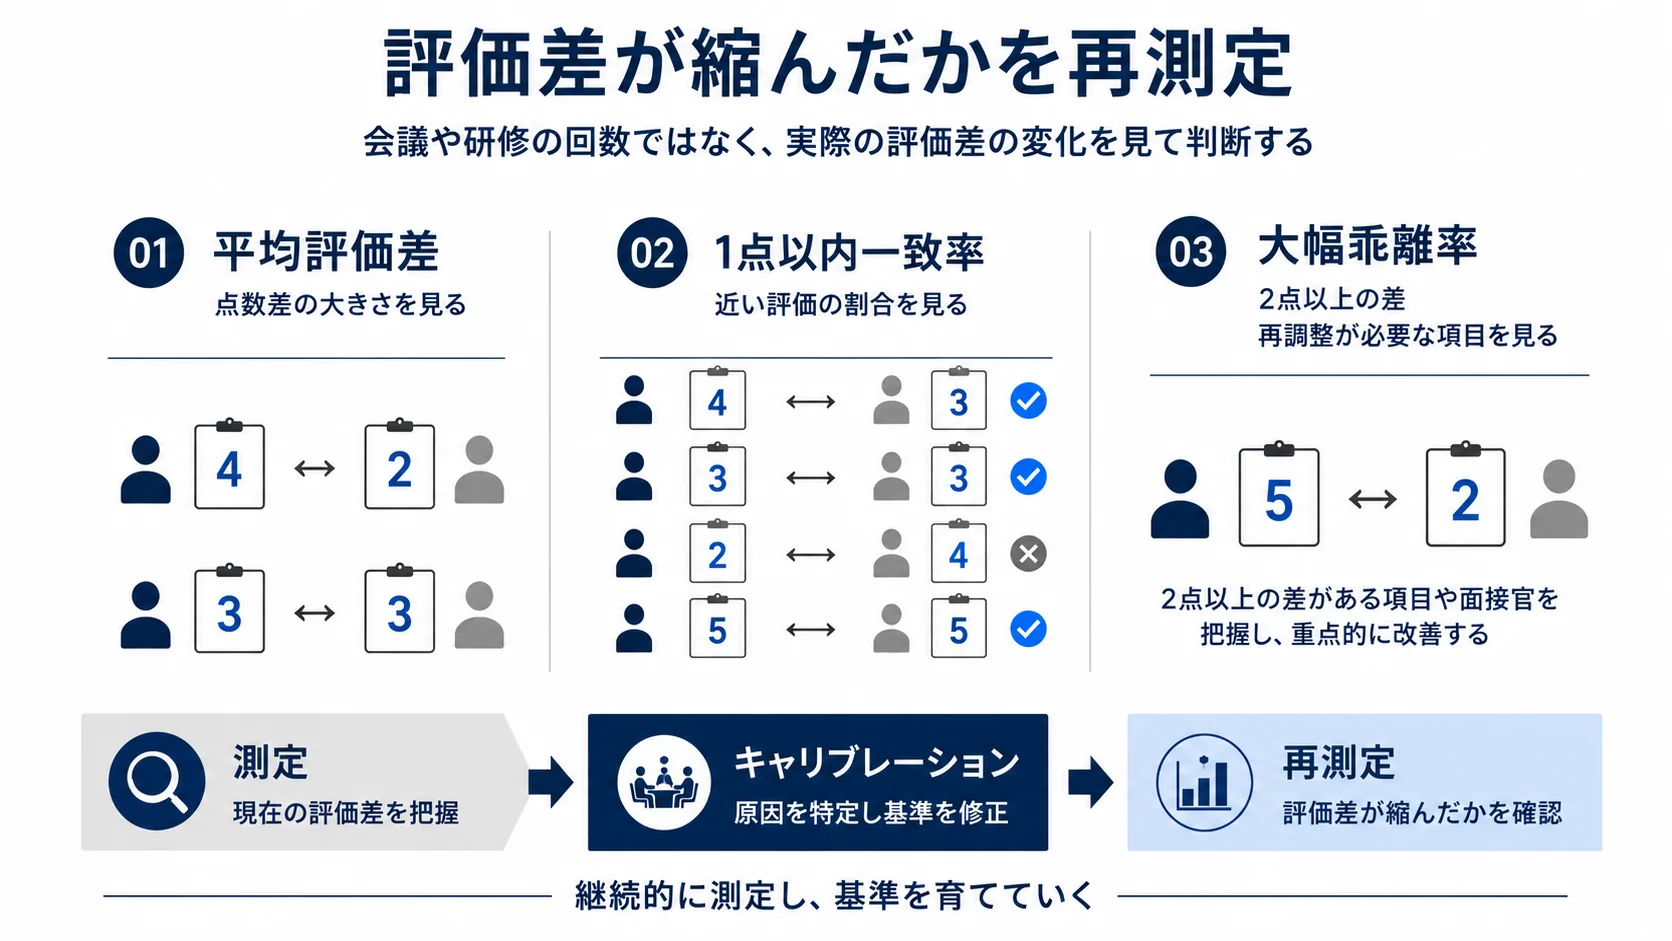
3つの指標は、評価差の大きさ、実務上近い評価の割合、再キャリブレーションが必要な割合を、それぞれ示します。効果は研修回数ではなく、評価差の変化で確認します。
評価データが十分に蓄積している場合は、ICC(級内相関係数)や重み付きカッパなどを使い、評価者間の一致度を確認する方法もあります。
ただし、候補者数が少ない採用では、1回の数値だけで面接官を評価しないようにします。目的は「厳しい面接官ランキング」を作ることではありません。次の3点を時系列で確認します。
- どの評価項目で差が出ているか
- 誰と誰の組み合わせで差が大きいか
- 評価基準を改定した後に差が縮んだか
測定で差が縮んだ例として、Gardnerらの研究があります。45人の面接官を対象に構造化面接と面接官教育を導入した研究で、評価者間一致度を示すICCは、導入前の0.51・0.49から、導入後は0.71・0.66へ上昇しました。また、大きな採点差が生じる候補者の割合も減少しています。一方、研究者は継続的な再研修の必要性も指摘しています。
キャリブレーションは「一度研修して終了」にしない
評価基準は、時間とともにずれる可能性があります。新しい面接官が加わる、採用ポジションが変わる、求める能力が変わる、評価シートが改定される。こうした変化が起きれば、以前キャリブレーションした面接官でも評価がずれる可能性があります。
そのため、次のタイミングを再キャリブレーションの起点にします。
- 新しい面接官が選考へ参加するとき
- 新職種の採用を開始するとき
- 評価項目・採点基準を変更したとき
- 2点以上の評価差が繰り返し発生したとき
- 面接段階ごとの通過判断が大きく食い違うとき
- 一定期間運用した後の定期点検
定期的な会議に加えて、「評価差が一定以上発生したら実施する」というトリガー方式を組み合わせると運用しやすくなります。
45分で行うキャリブレーション会議のテンプレート
事前採点が終わっていれば、会議そのものは長時間である必要はありません。次の表のように進められます。
| 時間 | 内容 |
|---|---|
| 0〜5分 | 今回確認する評価項目と差分を共有 |
| 5〜20分 | 評価差が大きい項目の回答事実を確認 |
| 20〜30分 | 評価基準・行動アンカーを修正 |
| 30〜40分 | 別の回答例を各自で再採点 |
| 40〜45分 | 残った差、変更内容、次回確認事項を記録 |
進行役は、「何点に統一しますか」ではなく、「3点と4点を分けている回答事実は何ですか」「今の評価基準のどの文章を読んで、その判断になりましたか」と確認します。これによって、議論を人の評価から基準の評価へ移せます。
キャリブレーションで避けたい5つの失敗
手順を形だけなぞると、次の5つの失敗が起きやすくなります。
失敗1|合否会議をキャリブレーションの代わりにする
合否会議は候補者を判断する場で、キャリブレーションは評価基準そのものを改善する場です。目的が違うため、会議を分けます。
失敗2|会議前に他の面接官の点数を見せる
他者の点数を見た後で採点すると、本来の評価差が見えなくなります。必ず独立採点を先に行います。
失敗3|総合点だけを見る
主体性は高いが問題解決力は低い候補者と、その逆の候補者が同じ総合点になることがあります。評価項目単位で差を確認します。
失敗4|点数だけ修正して評価基準を直さない
「今回は3点にしましょう」と決めても、次の候補者で同じ問題が発生します。判断基準の文章まで書き換えます。
失敗5|一致率を面接官の人事評価に使う
一致度の測定は、面接官を順位付けするためのものではありません。評価基準、質問、記録、研修のどこを改善するかを見つけるために使います。
公正な採用選考の観点でも、評価基準をそろえる必要がある
日本で面接を標準化する際は、採用精度だけでなく、公正な採用選考の観点も欠かせません。
厚生労働省は、応募者本人の職務遂行上必要な適性・能力を基準に選考し、面接では事前に質問項目・評価基準を決めることを示しています。本人に責任のない家族、出生地などの情報や、思想・信条などを採用判断へ持ち込まないことも重要です。
そのため、キャリブレーション会議でも、「この項目は本当に職務遂行能力を測っているか」「候補者の属性や第一印象を評価基準へ混ぜていないか」まで確認してください。評価基準を揃えることと、公正な評価基準を作ることはセットです。
まとめ|評価差を測り、基準に戻し、もう一度測る
面接官キャリブレーションは、評価差が発生した後に「平均点を取って終わる」ための会議ではありません。会議の6ステップと、会議後の継続測定を合わせた、次の7つの工程で進めます。
- 同じ回答例を各面接官が独立して採点する
- 評価差が大きい項目を抽出する
- 回答事実まで戻って判断理由を比較する
- 基準・質問・記録のどこに原因があるか分類する
- 行動ベースの採点基準へ修正する
- 別の回答例や模擬面接で再採点する
- 実際の採用データで評価差を継続測定する
評価シートを作っただけでは、面接官間の判断は自動的には揃いません。評価差を測定し、差が生じた理由を評価基準へ戻し、もう一度測定する。この改善ループまで設計することで、面接評価を個人の経験や感覚から、組織として再現できる採用判断へ近づけられます。
最初の一歩としては、同じ回答例を1件選び、会議前に各面接官が独立して採点するところから始められます。
参考文献・データ元
この記事で参照した情報を確認できます。
- 「公正な採用選考の基本」厚生労働省。面接時に職務遂行上必要な適性・能力を評価する質問項目・評価基準を事前に設定する考え方を参照。厚生労働省「公正な採用選考の基本」
- 「事業主の皆様へ 採用選考の具体的な方法」厚生労働省。面接評価を事前に決めた基準で客観的・公平に行う考え方を参照。厚生労働省「採用選考の具体的な方法」
- “Structured Interviews” U.S. Office of Personnel Management。共通質問・共通評価尺度による構造化面接の設計を参照。U.S. OPM Structured Interviews
- “Use fair and structured interview techniques” Office for Equality and Opportunity, 2026年3月4日。個別採点後にパネルで議論する運用を参照。GOV.UK structured interview guidance
- Melchers, K. G., Lienhardt, N., von Aarburg, M., & Kleinmann, M. (2011). “Is More Structure Really Better? A Comparison of Frame-of-Reference Training and Descriptively Anchored Rating Scales to Improve Interviewers’ Rating Quality.” Personnel Psychology, 64, 53–87. FOR訓練と記述的評価尺度による評価精度・評価者間信頼性の改善を参照。DOI: 10.1111/j.1744-6570.2010.01202.x。Wiley掲載ページ
- Gardner, A. K., Costa, P., & Willis, R. E. (2022). “Getting on the Same Page: The Impact of Interviewer Education and Structured Interviews on Interrater Agreement in Residency Interviews.” Journal of Surgical Education, 79(6), e12–e16. 45人の面接官を対象とした教育・構造化面接導入前後の評価者間一致度を参照。DOI: 10.1016/j.jsurg.2022.05.013。PubMed掲載ページ
‹ 親記事: 採用改善の効果測定は何をどう見ればいい?指標体系とPDCAの全体像
関連記事
- › 採用KPIの目標値の決め方|採用人数から応募・面接・内定数を逆算する方法
- › 採用ファネルの歩留まりを診断する方法|応募・面接・内定・承諾のボトルネック特定
- › 採用チャネルの実績を評価する方法|面接率・内定率・承諾率・採用単価で運用後に比較
- › 選考リードタイムを短縮する方法|工程別の滞留と対応期限を改善
- › 採用チャネルと入社後定着率をつなげて評価する方法|90日・180日で見る採用KPI設計
- › 採用施策のA/Bテストを設計する方法|求人訴求・スカウト文面・応募導線を検証
- › 候補者体験アンケートの設計方法|応募・面接・内定後の離脱理由を定量化
- › 面接官ごとの評価ばらつきを確認|採点差・通過率・コメントを比較
- › 採用A/Bテストの実験ログを作る方法|仮説・変更点・結果・学びを再利用する
- › 候補者アンケートの自由記述を分析する方法|不満・辞退理由・改善要望を分類
- › 採用要件を入社後データで見直す方法|90日・180日で面接評価を検証
- › スカウト返信率が低い原因と改善方法|対象者・件名・文面・送信タイミングを診断
- › 求人条件の変更が応募率に与える影響を検証する方法|給与・勤務地・勤務形態を前後比較
- › 企業口コミの評価変化と応募率の関係を測る方法|指名検索・採用サイト・応募を時系列で比較
- › 採用サイトの行動分析をGA4で行う方法|求職者の閲覧・回遊・応募をつなげて見る
- › 求人条件の市場差を定点観測する方法|給与・勤務地・勤務形態と応募率を競合求人で比較
- › 採用チャネルの重複応募を分析する方法|候補者ID・応募経路・採用単価の集計ルール
- › 面接後の選考辞退要因を調査する方法|候補者の不安・追加検索・他社比較を可視化
- › 応募数はあるのに内定承諾率が低いときの情報接点診断|採用サイト・口コミ・検索結果・選考説明を点検
- › 内定辞退理由の記録・分析方法|理由分類・面談メモ・改善内容
- › 採用CX(候補者体験)とは?認知から入社までの体験設計と改善方法
- › 採用コストの相場と計算方法|新卒・中途・媒体別の採用単価を比較
- › 採用データ分析の方法|応募・通過率・辞退率・採用単価を改善につなげる
- › 離職率を下げる方法|離職理由の分析・定着施策・採用へのフィードバック