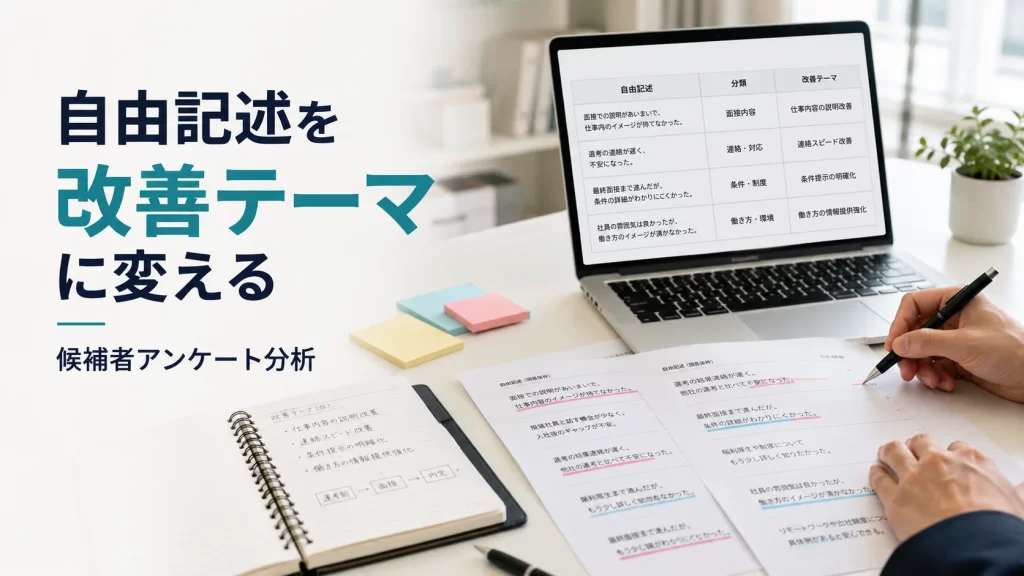
候補者アンケートで5段階評価や満足度を集計しても、「なぜ不満だったのか」「どこで辞退したくなったのか」までは分からないことがあります。その理由を知る手がかりが自由記述です。ただし、コメントを読んで印象をまとめるだけでは、改善の根拠として不十分になりがちです。
自由記述は、単なるコメント集ではなく、改善テーマへ変換する分析にしてはじめて役に立ちます。具体的には、意味のある記述にコード(回答の意味を短く表すラベル)を付け、似たコードをテーマへまとめ、選考フェーズや定量評価と組み合わせて優先順位を決めます。
この記事では、人事・採用担当者が表計算ソフトでも実行できる形で、自由記述の整理から改善施策への接続までを解説します。
なお、候補者体験を含む採用ファネル全体の指標体系と、測定結果から改善対象を特定する考え方は、採用改善の効果測定とPDCAの全体像で整理しています。
候補者アンケートの自由記述は「件数」ではなく「原因」を見つけるために分析する
候補者アンケートの自由記述は、満足度スコアだけでは分からない「なぜ」を把握するために使います。選択式設問が採用プロセスの状態を数値で示すのに対し、自由記述は、候補者がどの接点で何を感じ、何が不満や辞退意向につながったのかを具体化する材料になります。
たとえば「面接の満足度が3.2点」と分かっても、原因が面接官の態度なのか、質問内容なのか、仕事内容の説明不足なのかは判断できません。自由記述を分類すると、「説明不足」「日程調整」「連絡速度」「面接官対応」といった、改善に取り組める単位へ分解できます。
分析で見るべき中心は、次の4点です。
- どの選考フェーズで問題が起きたか
- 候補者は何に不満・不安を感じたか
- 辞退や志望度低下に関係しそうな記述は何か
- 同じ問題が複数の候補者で繰り返されているか
こうした使い方は、外部の資料でも紹介されています。SurveyMonkeyは、候補者体験アンケートを採用・面接方法へのフィードバック収集と改善に用いるものとして紹介しています。HRBrainも、候補者アンケートなどを使って採用プロセスのボトルネックを特定し、改善を繰り返すことを採用CX(候補者体験)設計の基本としています。
自由記述分析は7ステップで進める
自由記述は、全文を眺めて印象をまとめるだけでは担当者の主観が入りやすくなります。そこで、回答を同じ基準で分類できるように、分析を次の7つの工程に分けます。
| ステップ | 作業 | 成果物 |
|---|---|---|
| 1 | データを整える | 分析用回答一覧 |
| 2 | 全体を読み込む | 初期メモ |
| 3 | コードを付ける | コード付き回答 |
| 4 | コードをテーマ化する | テーマ一覧 |
| 5 | 選考フェーズと紐づける | フェーズ別課題表 |
| 6 | 定量結果と突き合わせる | 原因仮説 |
| 7 | 改善優先順位を決める | 改善バックログ |
表の「成果物」は、各ステップの終わりに手元に残すものです。改善バックログとは、改善施策の候補を優先順に並べた一覧のことです。多くのステップでは、前のステップの成果物が次のステップの材料になります。
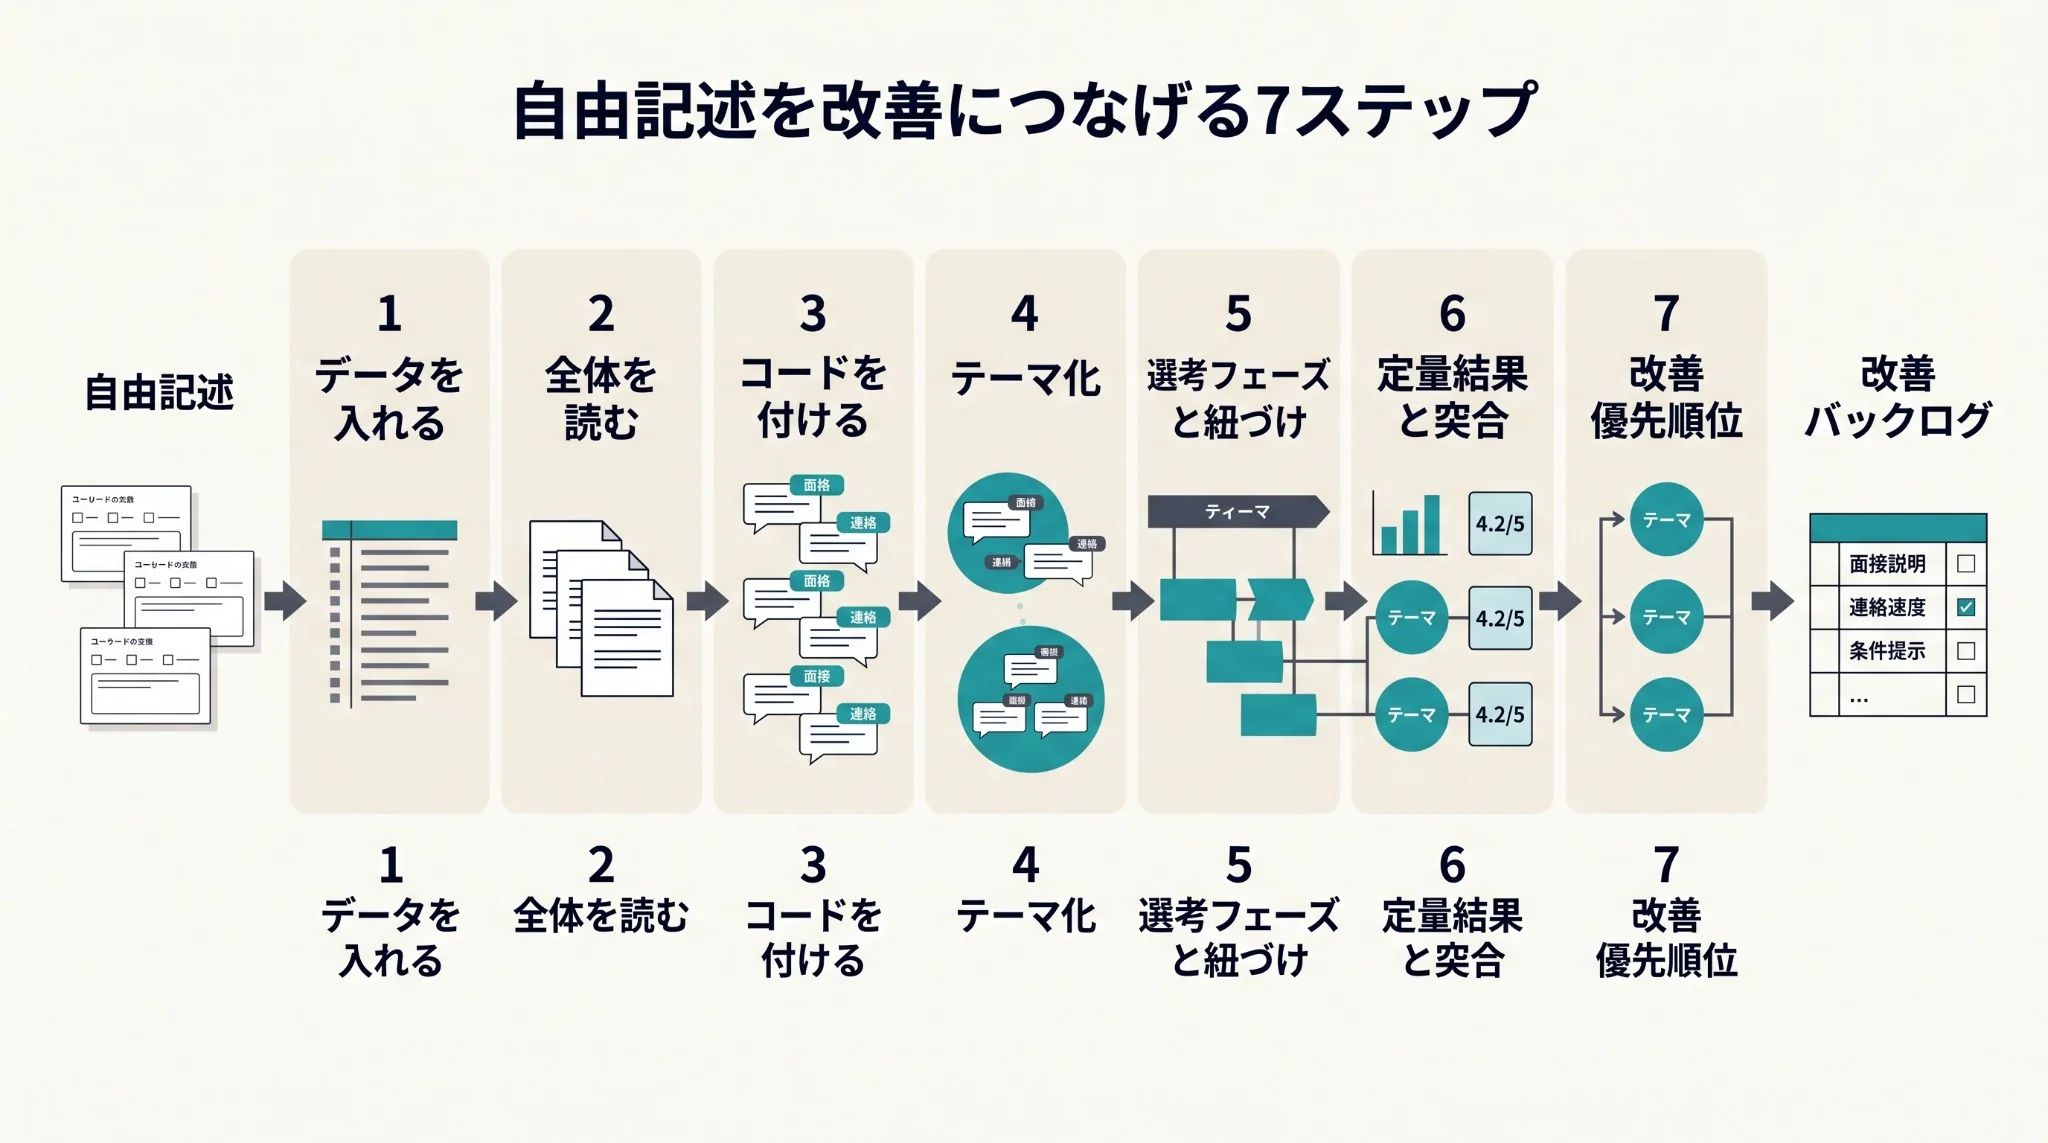
図のとおり、コメントを読むだけで終わらせず、コード化・テーマ化・定量結果との突き合わせを経て、改善バックログへつなげます。
この進め方は、質的データの代表的な分析方法であるテーマ分析と整合します。BraunとClarkeは、データへの習熟、コード生成、テーマ探索、テーマの見直し、定義・命名、報告という段階的な分析手順を示しています。候補者アンケートで研究目的の分析をそのまま再現する必要はありませんが、「生のコメントからいきなり結論を出さず、コードとテーマを介して整理する」という考え方が役立ちます。
この節では、分析の土台になるSTEP1〜3を順に見ます。STEP3で使うコードの設計は次の節で、STEP4以降はその後の節で説明します。
STEP1|回答データを分析できる形に整える
最初に、自由記述と選択式回答を同じ行で見比べられる表を作ります。最低限、回答ID、選考フェーズ、満足度などの定量設問、自由記述を持たせます。
氏名やメールアドレスなどは、分析に不要であれば分析表から外すほうが安全です。自由記述には、候補者が自発的に会社名、担当者名、学校名、現職などを書き込む可能性もあります。個人情報の取り扱いについて、個人情報保護委員会は、アンケートで本人から個人情報を直接取得する場合、原則として利用目的の明示が必要と説明しています。また、氏名のように単体で個人を識別できる情報を匿名加工する場合は措置が必要としています。
分析用データでは、「誰が書いたか」より「どの体験について何が書かれたか」を残す設計にします。
STEP2|先に全体を読み、分類を早く固定しすぎない
コードを付ける前に、自由記述全体を読みます。最初の数件だけを見て分類項目を決めると、その後の回答を最初の分類へ無理に当てはめてしまう危険があるためです。
この段階では、正式な分類は作りません。「連絡が遅いという声が複数ある」「面接官の説明への評価が分かれている」といった初期メモにとどめます。
回答数が多い場合も、いきなりAIやテキストマイニングだけに任せず、人が回答の文脈を把握する工程を残します。Maedaらが2025年にComputers in Human Behaviorへ掲載した研究では、テキスト分析の手法の一つであるトピックモデリングは、手作業のコーディングで見つかる多くのテーマを捉えられる一方、抽象度の高い概念では人のコーディングと一致しない場合があると報告されています。
STEP3|1回答に複数コードを付ける
STEP3では、回答の意味をコードで表します。1回答を1分類へ押し込める必要はありません。
たとえば、次の回答を考えます。
「面接官の方は丁寧でしたが、面接後の連絡が1週間なく、選考状況が分からず不安になりました。」
この回答には、少なくとも次のコードを付けられます。
- 面接官対応:肯定
- 結果連絡:遅い
- 選考状況:不透明
- 感情:不安
1つの回答から、良かった点と、改善すべき点と、そのときの感情が分けて取り出せます。「ポジティブ」「ネガティブ」だけにすると、改善できる具体的な原因が消えてしまいます。そのため、候補者が何を経験し、それをどう評価し、どのような感情や行動意向につながったかを分けて記録します。
コードは「どこで・何が・どう受け取られ・何につながったか」の4軸で作る
採用実務では、自由記述のコードを4つの軸で持つと、改善施策へつなげやすくなります。軸は、選考フェーズ、事象、評価・感情、影響です。次の表は、各軸の例と、分析で分かることをまとめたものです。
| 軸 | 例 | 分析で分かること |
|---|---|---|
| 選考フェーズ | 応募、日程調整、一次面接、最終面接、内定後 | どこで起きたか |
| 事象 | 連絡速度、説明、質問、面接官対応、条件提示 | 何が起きたか |
| 評価・感情 | 満足、不満、不安、安心、違和感 | どう受け取られたか |
| 影響 | 志望度上昇、志望度低下、辞退検討、改善要望 | 採用成果へどう影響したか |
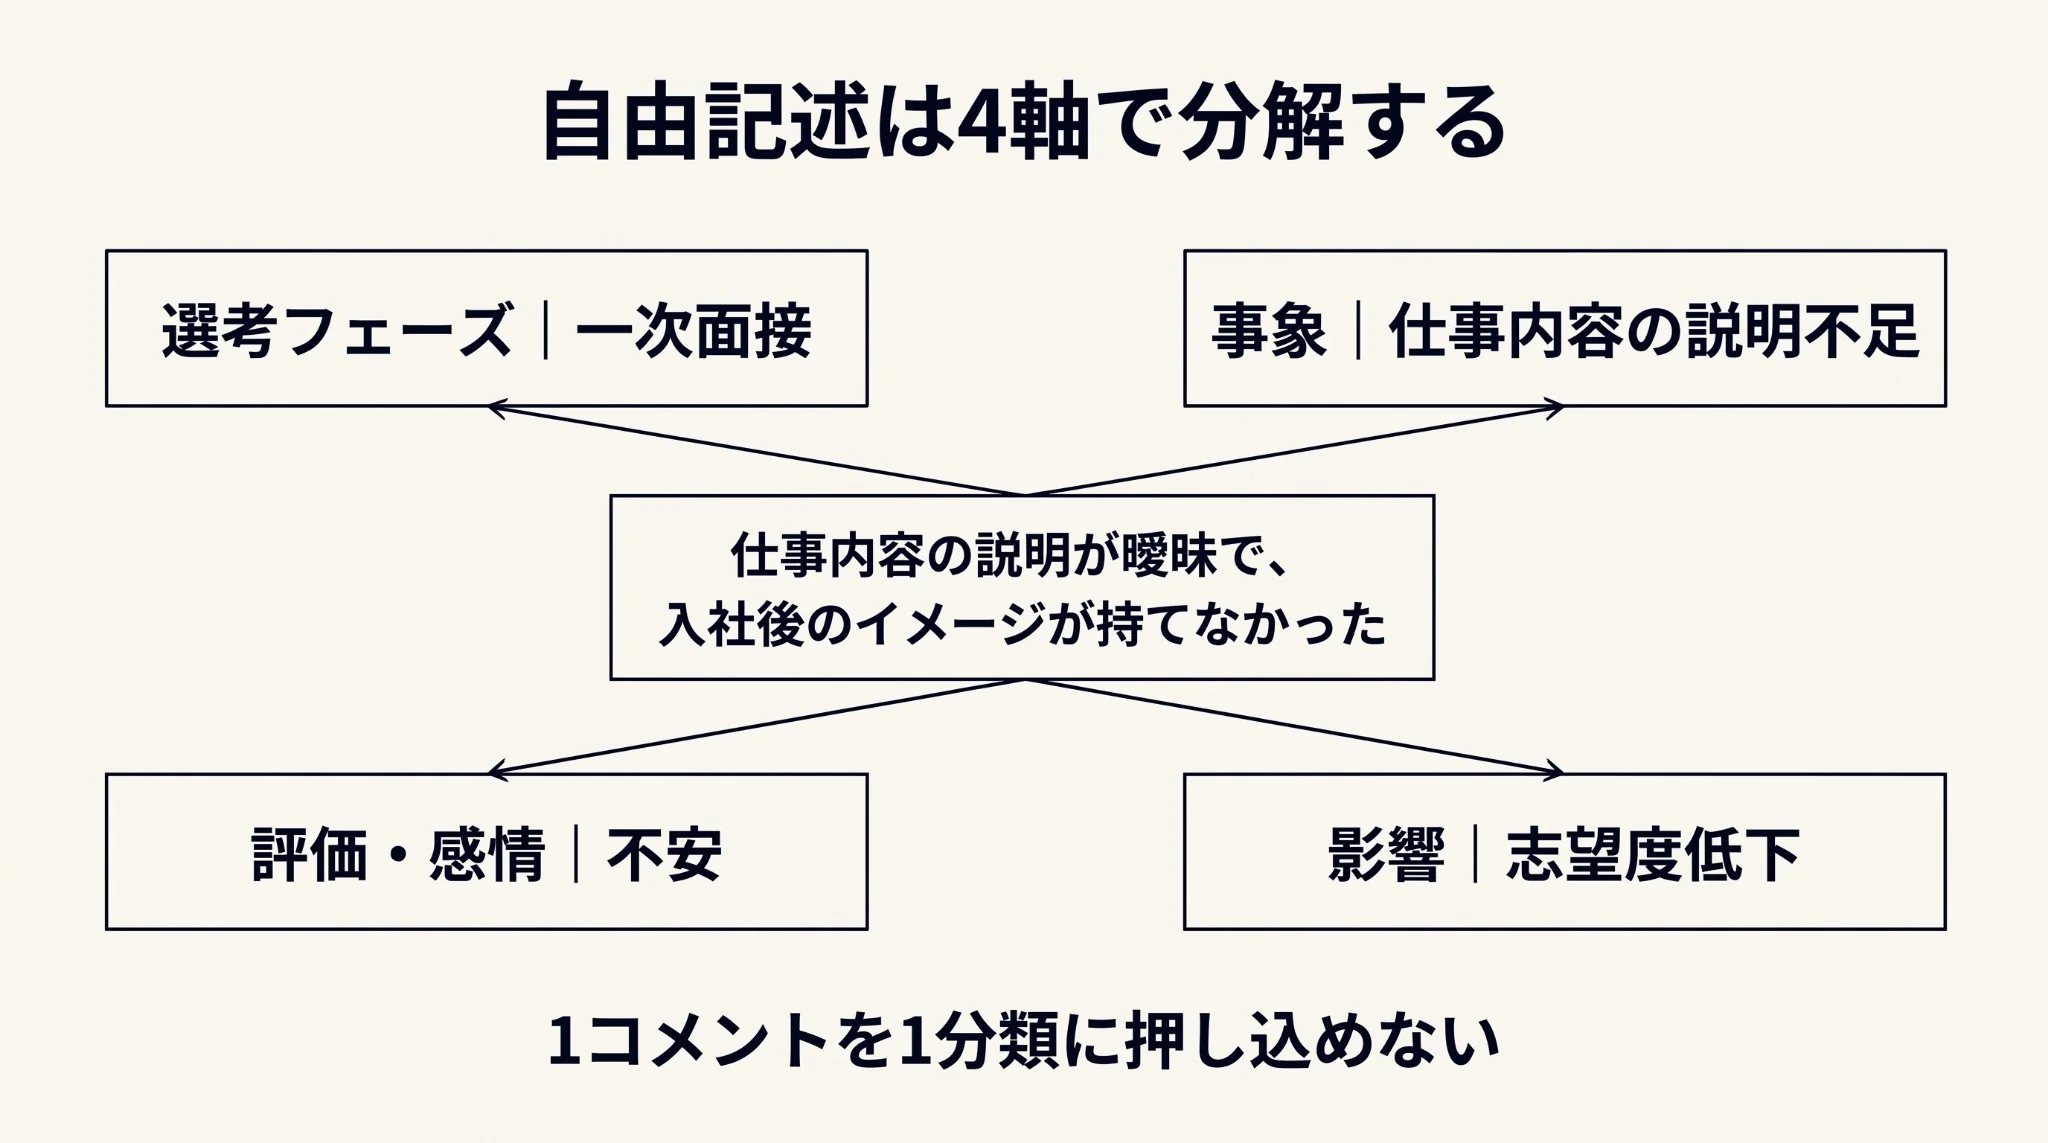
1つの自由記述には複数の意味が含まれます。4つの軸へ分解すると、改善対象を具体化できます。
たとえば「仕事内容の説明が曖昧で、入社後のイメージが持てなかった」という回答が一次面接後のアンケートに書かれていたとします。この回答は、「一次面接」「仕事内容説明不足」「不安」「志望度低下」と分解できます。
この形にすると、単純な単語頻度よりも、「一次面接×説明不足×志望度低下」のように、改善対象を具体化できます。
最初から細かすぎるコードを作らない
「面接官が早口」「面接官の説明が長い」「面接官が専門用語を使う」をすべて別コードにすると、回答数が少ないうちは傾向が見えにくくなります。
最初は「面接官の説明方法」のような上位コードを置き、必要に応じて下位コードへ分けます。逆に「面接」という1コードだけでは粗すぎます。改善担当者がコードを見て「何を変えればよいか」を判断できる粒度を目安にします。
コードを「不満・辞退理由・改善要望」のテーマへまとめる
STEP4では、付け終えたコードのうち似たものをまとめて、改善テーマを作ります。テーマは単なる話題ではなく、採用活動で対応可能な問題として定義すると使いやすくなります。次の表は、コードをテーマにまとめ、対応する施策を並べた例です。
| 自由記述から得たコード | 改善テーマ | 想定する施策 |
|---|---|---|
| 返信が遅い、結果待ちが長い、状況が不明 | 連絡速度・透明性 | 連絡SLA、進捗連絡の標準化 |
| 仕事内容が曖昧、期待役割が不明 | 職務理解不足 | 面接説明項目、求人票の見直し |
| 面接官ごとに説明が違う | 面接品質のばらつき | 面接ガイド、面接官研修 |
| 給与条件が終盤まで不明 | 条件提示の遅れ | 条件説明タイミングの前倒し |
| 質問しづらい、圧迫感がある | 対話品質 | 質問時間の確保、NG行動共有 |
表の「連絡SLA」は、連絡までの期限を決めた社内基準のことです。
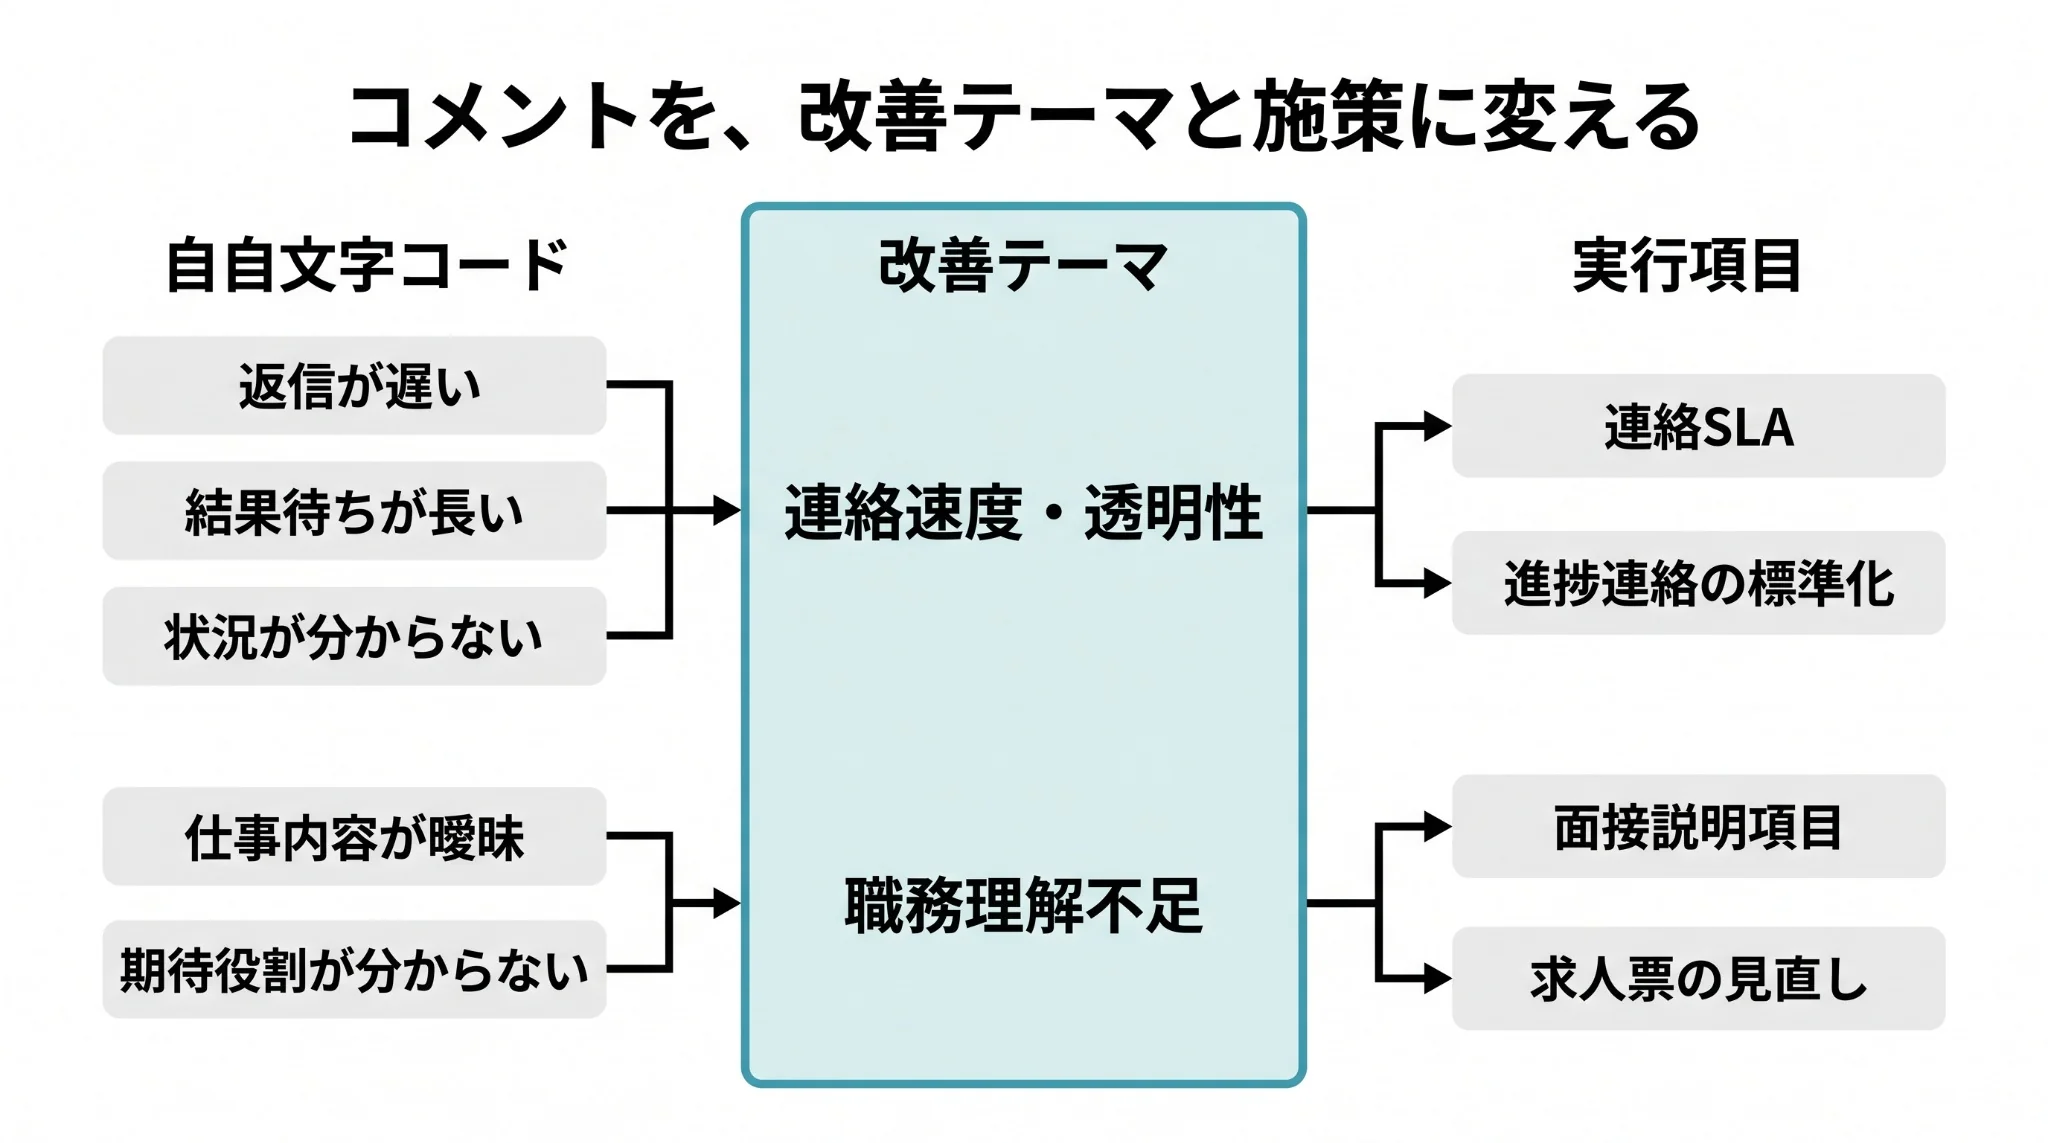
図のとおり、コードは改善テーマにまとめ、具体的な施策へ接続します。
ここで注意したいのは、回答数が多いテーマだけを問題と決めないことです。たとえば「日程調整が面倒」という声が10件あり、「面接官の発言で強い不信感を持った」という声が2件だったとしても、後者のほうが候補者体験や採用ブランドへの影響が大きい場合があります。件数は判断材料の一つにとどめ、影響の大きさは別に見ます。
自由記述は定量結果と組み合わせると改善原因を特定しやすい
自由記述だけでは、そのテーマが全体でどの程度広がっているか判断しづらいことがあります。そこでSTEP5・6では、コードに付けた選考フェーズごとに課題を整理し、満足度、選考辞退率、内定承諾率などの定量データと突き合わせて、原因の仮説を立てます。
たとえば「一次面接の満足度が低い」という定量結果が出ている場合、一次面接の自由記述をテーマ別に集計します。集計の結果が次のようになったとします。
- 面接官の態度への不満が多い
- 仕事内容の説明不足が多い
- 面接時間が短すぎるという声が多い
ここまで分かれば、「一次面接の満足度を上げる」という抽象的な施策ではなく、「仕事内容の説明項目を面接ガイドへ追加する」のように、改善内容を決められます。
自由記述は定量データの代わりではありません。定量データで見つかった変化や差の理由を探るために使うと効果的です。
改善優先順位は「頻度×影響度×改善可能性」で決める
STEP7では、抽出したテーマをすべて同時に改善するのではなく、優先順位を付けます。実務では、次の3軸で評価すると判断しやすくなります。
- 頻度:同じテーマがどれだけ繰り返されているか
- 影響度:辞退・志望度低下・企業への不信につながる可能性が高いか
- 改善可能性:採用チームが短期間で変更できるか
各項目を1〜3点で評価し、合計点の高いテーマから着手する方法でも構いません。
たとえば「面接結果の連絡が遅い」は頻度3、影響度3、改善可能性3で9点。一方、「オフィスの立地が遠い」は頻度2、影響度2、改善可能性1で5点、といった形です。この例では、9点の連絡の遅れから着手し、5点の立地は優先度を下げる判断になります。
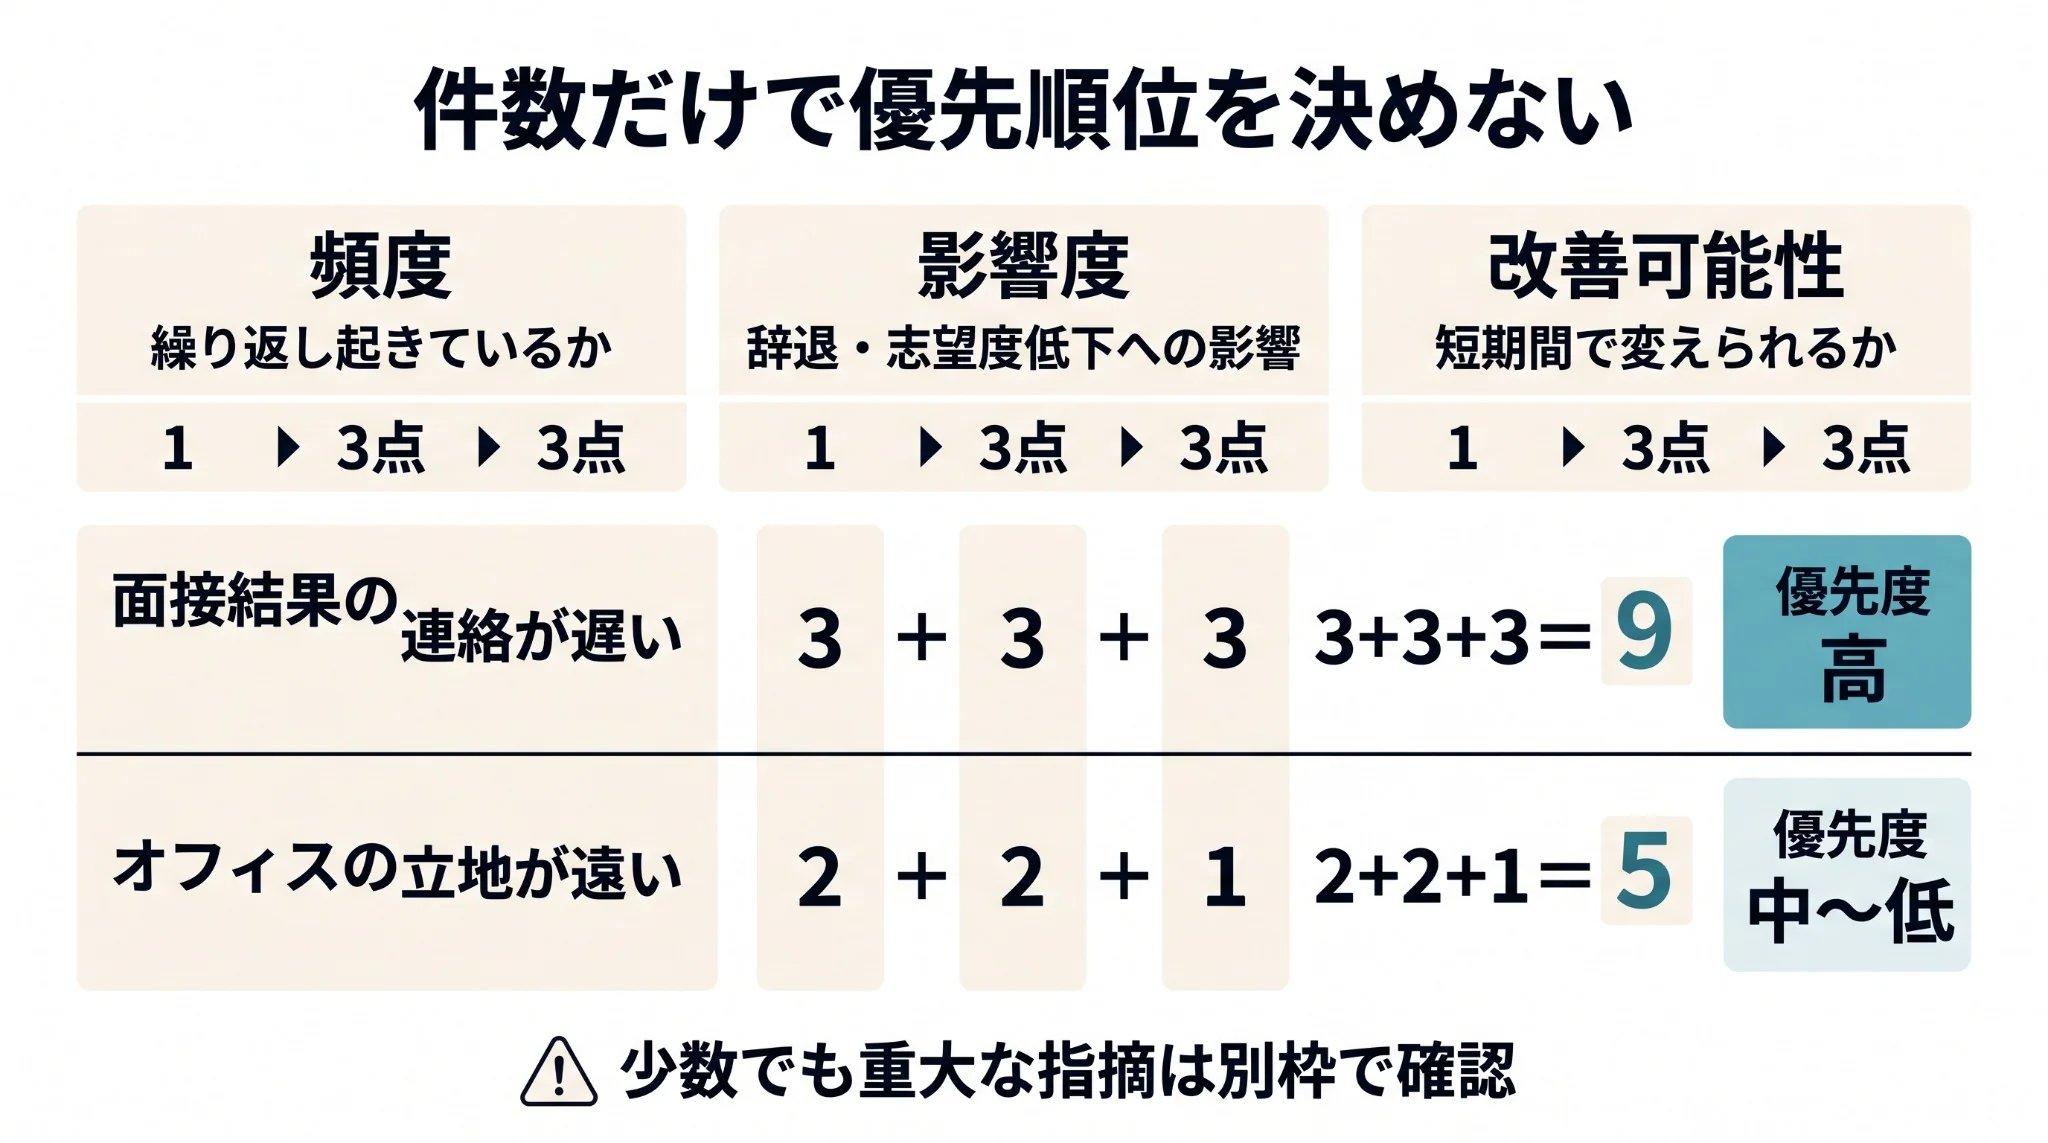
改善テーマは、件数だけでなく、頻度・影響度・改善可能性を分けて評価します。
これは統計的な効果測定ではなく、改善会議で着手順を決めるための実務上の判断表です。点数そのものを絶対視せず、重大なハラスメント懸念や不適切対応などは、件数が少なくても別枠で確認します。
自由記述分析でよくある5つの失敗
自由記述は柔軟なデータだからこそ、分析ルールがないと結論がぶれやすくなります。ここでは、起こりやすい5つの失敗と、その防ぎ方を挙げます。
1.単語の出現回数だけで結論を出す
「面接」という単語が多くても、良かったのか悪かったのかは分かりません。単語数ではなく、文脈と意味をコード化します。
2.1回答を1テーマだけに分類する
候補者の文章には複数の体験が含まれます。複数コードを許容し、情報を落とさないようにします。
3.件数が多いテーマだけを優先する
少数でも辞退や企業不信に直結するテーマは見逃せません。頻度と影響度を分けて評価します。
4.担当者の感覚だけでコードを変える
月ごとに分類基準が変わると比較できません。コード名、定義、含める例、含めない例を、簡単なコードブックとして残します。
5.自由記述だけで因果関係を断定する
「連絡が遅かったので不満」という記述が多くても、それだけで連絡速度が辞退の唯一の原因だとは断定できません。辞退者と継続者の差、満足度、選考フェーズなどを合わせて、原因の仮説として検証します。
AIで自由記述を分類する場合も、人が基準と例外を確認する
回答数が増えると、AIやテキスト分析ツールを使って、初期分類や要約を効率化できます。ただし、AIへ全件を渡して出てきたテーマをそのまま採用するのではなく、人がコードの定義と例外回答を確認する運用が必要です。
特に確認すべきなのは、次の点です。
- 同じ意味の表現が別テーマへ分かれていないか
- 皮肉や遠回しな不満を誤判定していないか
- 1回答に複数テーマがある場合に情報を落としていないか
- 少数だが重大な指摘を「その他」へ埋めていないか
- 個人情報や機微な記述を外部ツールへ不必要に送っていないか
STEP2で紹介したMaedaらの2025年の研究でも、トピックモデリングは手作業の分析を補完し、効率化に役立つ可能性が示される一方、人のコーディングとの不一致も確認されています。AIは「分析者の代わり」ではなく、「候補コードの作成や大量回答の一次整理を支援するもの」と位置付けるほうが安全です。
月次の改善会議では「テーマ→原因仮説→施策→再測定」まで管理する
自由記述を分析して一覧表を作るだけでは、候補者体験は改善しません。最終的には、改善バックログへ接続します。
改善バックログには、最低限、次の項目を持たせます。
- 改善テーマ
- 対象選考フェーズ
- 該当件数
- 代表的な回答要旨
- 定量指標の状態
- 原因仮説
- 改善施策
- 担当者
- 実施期限
- 次回確認日
施策を実施した後は、同じコード体系で自由記述を再分析します。「連絡速度」の不満が減ったか、面接満足度が改善したか、辞退率に変化があったかを確認します。
候補者体験の改善は、アンケートを一度実施して終わるものではありません。HRBrainやパーソルビジネスプロセスデザインも、候補者アンケートやKPIを継続的に測定し、改善前後を比較する重要性を示しています。
まとめ
候補者アンケートの自由記述は、感想を読むための欄ではなく、定量スコアだけでは見えない不満・辞退理由・改善要望を特定するためのデータです。
実務では、回答を整え、全体を読み、複数コードを付け、テーマへまとめ、選考フェーズと定量結果を突き合わせます。そのうえで「頻度×影響度×改善可能性」で優先順位を付け、改善施策と再測定まで管理すると、自由記述を採用改善へつなげられます。
最初から高度なテキストマイニングを導入する必要はありません。まずは表計算ソフトでコードブックと改善バックログを作り、同じ基準で継続的に分析できる状態を整えましょう。
参考文献・データ元
この記事で参照した情報を確認できます。
- 「採用CX(候補者体験)とは?重要性・メリット・改善方法を徹底解説」HRBrain、2026年4月27日
https://www.hrbrain.jp/media/recruitment/candidate-experience-guide - 「採用CX(候補者体験)とは|選考辞退を防ぎ内定承諾率を高める設計と改善方法」パーソルビジネスプロセスデザイン株式会社
https://www.persol-bd.co.jp/service/hrsolution/s-hr/column/candidate-experience/ - 「候補者体験」SurveyMonkey
https://jp.surveymonkey.com/templates/candidate-experience-survey-template/ - Braun, V. & Clarke, V. (2006). Using thematic analysis in psychology. Qualitative Research in Psychology, 3(2), 77-101.
DOI: 10.1191/1478088706qp063oa
https://doi.org/10.1191/1478088706qp063oa - Maeda, Y., Wang, X., Zhang, Y., Banks, J. B., & Kenney, R. H. (2025). Balancing human and machine coding: Evaluating the credibility and potential of topic modeling for open-ended survey responses. Computers in Human Behavior, 172, 108703.
DOI: 10.1016/j.chb.2025.108703
https://doi.org/10.1016/j.chb.2025.108703 - 「個人情報の保護に関する法律についてのガイドライン(通則編)」個人情報保護委員会
https://www.ppc.go.jp/personalinfo/legal/guidelines_tsusoku/ - 「氏名や住所、年齢、性別などの記述が含まれていた場合は必ず全ての記述について削除等の措置が必要になりますか」個人情報保護委員会
https://www.ppc.go.jp/all_faq_index/faq1-q15-11/
‹ 親記事: 採用改善の効果測定は何をどう見ればいい?指標体系とPDCAの全体像
関連記事
- › 採用KPIの目標値の決め方|採用人数から応募・面接・内定数を逆算する方法
- › 採用ファネルの歩留まりを診断する方法|応募・面接・内定・承諾のボトルネック特定
- › 採用チャネルの実績を評価する方法|面接率・内定率・承諾率・採用単価で運用後に比較
- › 選考リードタイムを短縮する方法|工程別の滞留と対応期限を改善
- › 採用チャネルと入社後定着率をつなげて評価する方法|90日・180日で見る採用KPI設計
- › 採用施策のA/Bテストを設計する方法|求人訴求・スカウト文面・応募導線を検証
- › 候補者体験アンケートの設計方法|応募・面接・内定後の離脱理由を定量化
- › 面接官ごとの評価ばらつきを確認|採点差・通過率・コメントを比較
- › 採用A/Bテストの実験ログを作る方法|仮説・変更点・結果・学びを再利用する
- › 面接官キャリブレーション会議の進め方|採点例・模擬面接で評価差を揃える
- › 採用要件を入社後データで見直す方法|90日・180日で面接評価を検証
- › スカウト返信率が低い原因と改善方法|対象者・件名・文面・送信タイミングを診断
- › 求人条件の変更が応募率に与える影響を検証する方法|給与・勤務地・勤務形態を前後比較
- › 企業口コミの評価変化と応募率の関係を測る方法|指名検索・採用サイト・応募を時系列で比較
- › 採用サイトの行動分析をGA4で行う方法|求職者の閲覧・回遊・応募をつなげて見る
- › 求人条件の市場差を定点観測する方法|給与・勤務地・勤務形態と応募率を競合求人で比較
- › 採用チャネルの重複応募を分析する方法|候補者ID・応募経路・採用単価の集計ルール
- › 面接後の選考辞退要因を調査する方法|候補者の不安・追加検索・他社比較を可視化
- › 応募数はあるのに内定承諾率が低いときの情報接点診断|採用サイト・口コミ・検索結果・選考説明を点検
- › 内定辞退理由の記録・分析方法|理由分類・面談メモ・改善内容
- › 採用CX(候補者体験)とは?認知から入社までの体験設計と改善方法
- › 採用コストの相場と計算方法|新卒・中途・媒体別の採用単価を比較
- › 採用データ分析の方法|応募・通過率・辞退率・採用単価を改善につなげる
- › 離職率を下げる方法|離職理由の分析・定着施策・採用へのフィードバック