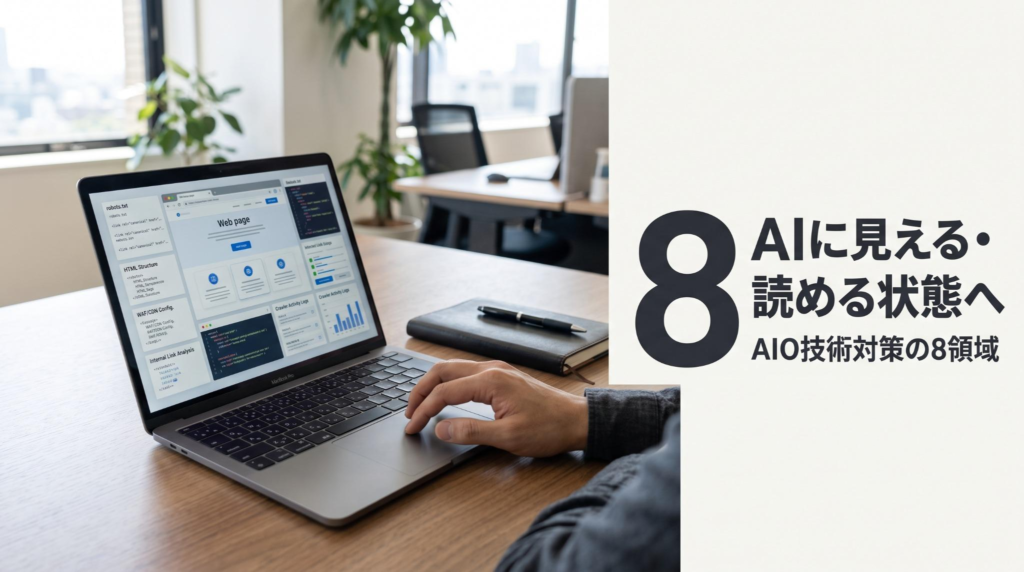
AIO対策では、記事の内容を改善する前に確認したいことがあります。検索エンジンやAIがページを取得し、内容を理解できる状態にあるかどうかです。どれだけ良いコンテンツでも、クロール(検索エンジンがページを巡回して内容を取得すること)を妨げる設定がある、重要情報の取得にレンダリング上の問題がある、内部リンクから孤立しているといった技術的な問題があれば、検索・AI回答の候補になる前の段階で不利になります。
本記事では、AIOの技術対策を8領域に分け、企業担当者が「どの領域を、どの順番で確認するか」を整理します。先に答えを言うと、AI専用の施策から始めるのではなく、取得やインデックス登録(検索エンジンにページ情報が登録されること)を妨げる原因から順に確認するのが基本です。読み終えると、自社サイトの技術課題がどの領域にあり、何を先に直すべきかが判断できます。詳しい調査が必要な領域も見分けられます。
なお、ここでいうAIOの技術対策は、検索エンジンやAIサービスがページを取得・理解できる状態を整える、技術面の対策を指します。個別の設定値やコード、ログ抽出、原因診断までを網羅する記事ではありません。
AIクローラーのUser-Agent・IP確認や、アクセスログを使ったCDN・WAF・オリジンの阻害診断は「AIクローラーをアクセスログで確認する方法|主要ボットの識別とクロール阻害の診断」に、構造化データのSchema選定・JSON-LD実装・検証・監査は「AIOの構造化データ実装ガイド|何をマークアップし、どこを監査するか」に分けます。Core Web Vitalsについても、本記事ではAIO技術対策における位置付けと確認項目までを扱い、LCP・INP・CLSごとの原因特定や具体的な改善手順は専門記事に委ねます。llms.txtの扱いと設置の判断は、llms.txtとは?Googleでの扱いと設置を判断するポイントで整理しています。
結論|最初に直すのは「AI専用施策」ではなく、取得・理解を妨げる原因
AIOの技術対策で最優先にするのは、「構造化データを追加する」「AI向けに特殊な設定を入れる」といった個別施策ではありません。まず取り除くのは、ページを取得できない原因や、正規URLの判断・コンテンツ理解を妨げる原因です。取得できない状態のままでは、後から追加した対策が検索エンジンやAIに届かないためです。
確認と対応を進める順番は、次のとおりです。
- クロール・インデックスの状態を確認する
- robots.txtやWAF・CDNで、必要なクローラーを誤って遮断していないか確認する
- 重要情報がクローラーから取得・レンダリングできるか確認する
- canonical・サイトマップ・内部リンクを整理する
- ページ体験や表示速度を改善する
- 必要な構造化データを正しく実装する
- 多言語・多地域サイトでは、hreflangなどを確認する
- 変更後のログ・表示・流入状況を継続して計測する
前半の1〜4は、ページを取得してもらい、正しいURLとして扱ってもらうための基礎です。5以降は、その基礎の上で利用体験や理解を高め、結果を確かめる作業にあたります。
多言語・多地域サイトで翻訳、hreflang、企業情報まで一体で整える場合は、多言語AIOの実装方法で実装順を確認できます。
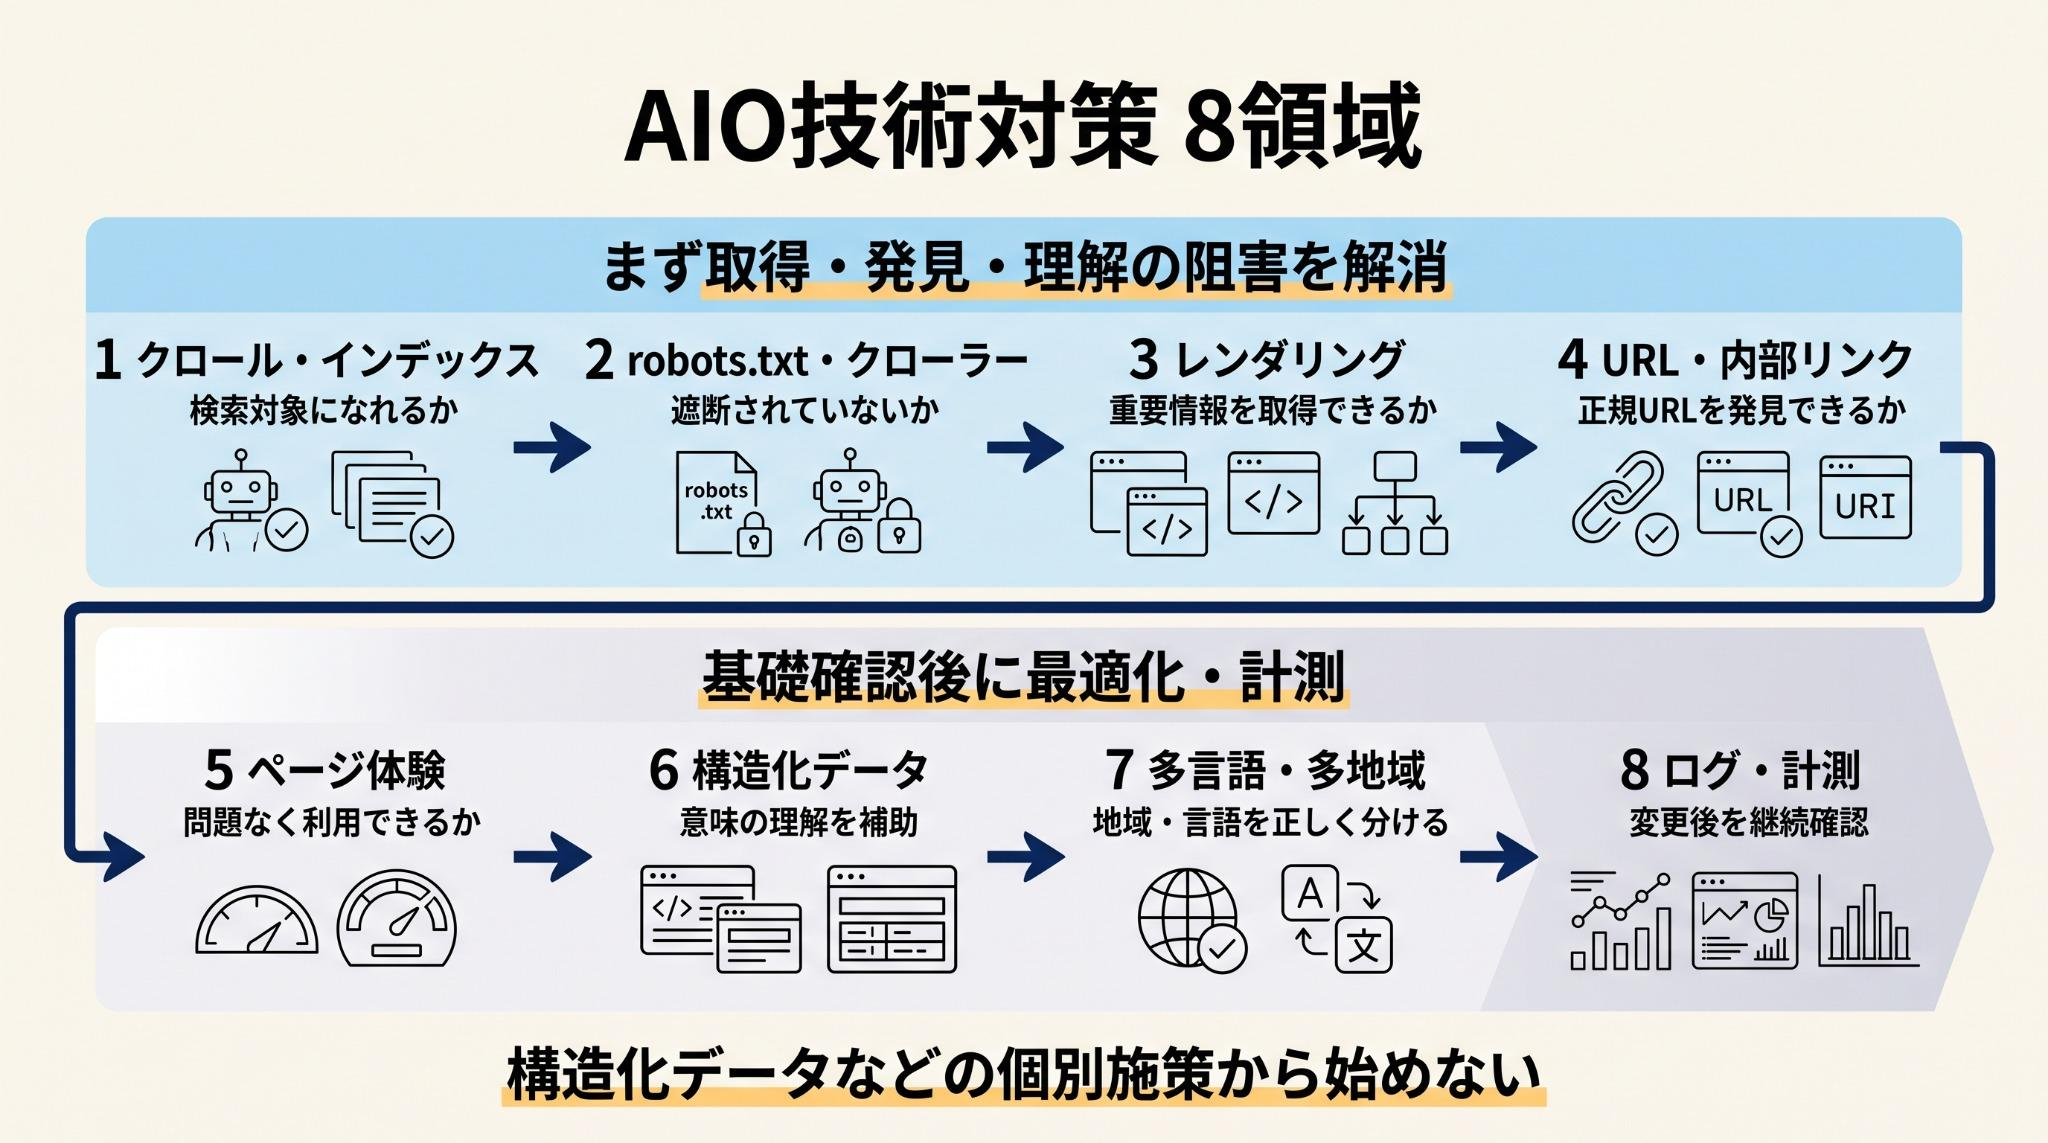
AIOの技術対策8領域|何をどこまで確認するか
ここでは、8領域それぞれで確認する内容と、本記事で扱う範囲を説明します。個別の診断が必要になる領域は、判断の目安だけを示して専門記事へ案内します。
1.クロール・インデックス|重要ページは検索対象になっているか
最初に、重要ページがGoogle検索でインデックス登録できる状態にあり、意図どおり検索対象になっているかを確認します。Search Consoleのインデックス登録状況やURL検査、XMLサイトマップなどを使い、意図しないnoindex、404、重複URL、誤ったcanonicalがないかを点検します。Googleも、robots.txt、サイトマップ、HTTPステータス、canonicalなどを、クロール・インデックス管理の主要項目として案内しています。
すべてのURLを同じ優先度で調べる必要はありません。新規公開・大幅更新したページや、流入・問い合わせにつながる重要ページから確認すると効率的です。
この論点に関連して、「AIO完全ガイド」もあわせてご覧ください。
2.robots.txt・AIクローラー|必要なクローラーを遮断していないか
robots.txtだけでなく、CDN、WAF、Bot Managementなどの設定でも、検索・AI関連のクローラーを意図せず遮断していないかを確認します。robots.txtで許可していても、WAFやCDN側で403などが返されていれば、実際にはアクセスできないためです。OpenAIも、robots.txtに加えて、WAF、CDN、ボット対策、認証、レート制限など複数のレイヤーを確認するよう案内しています。
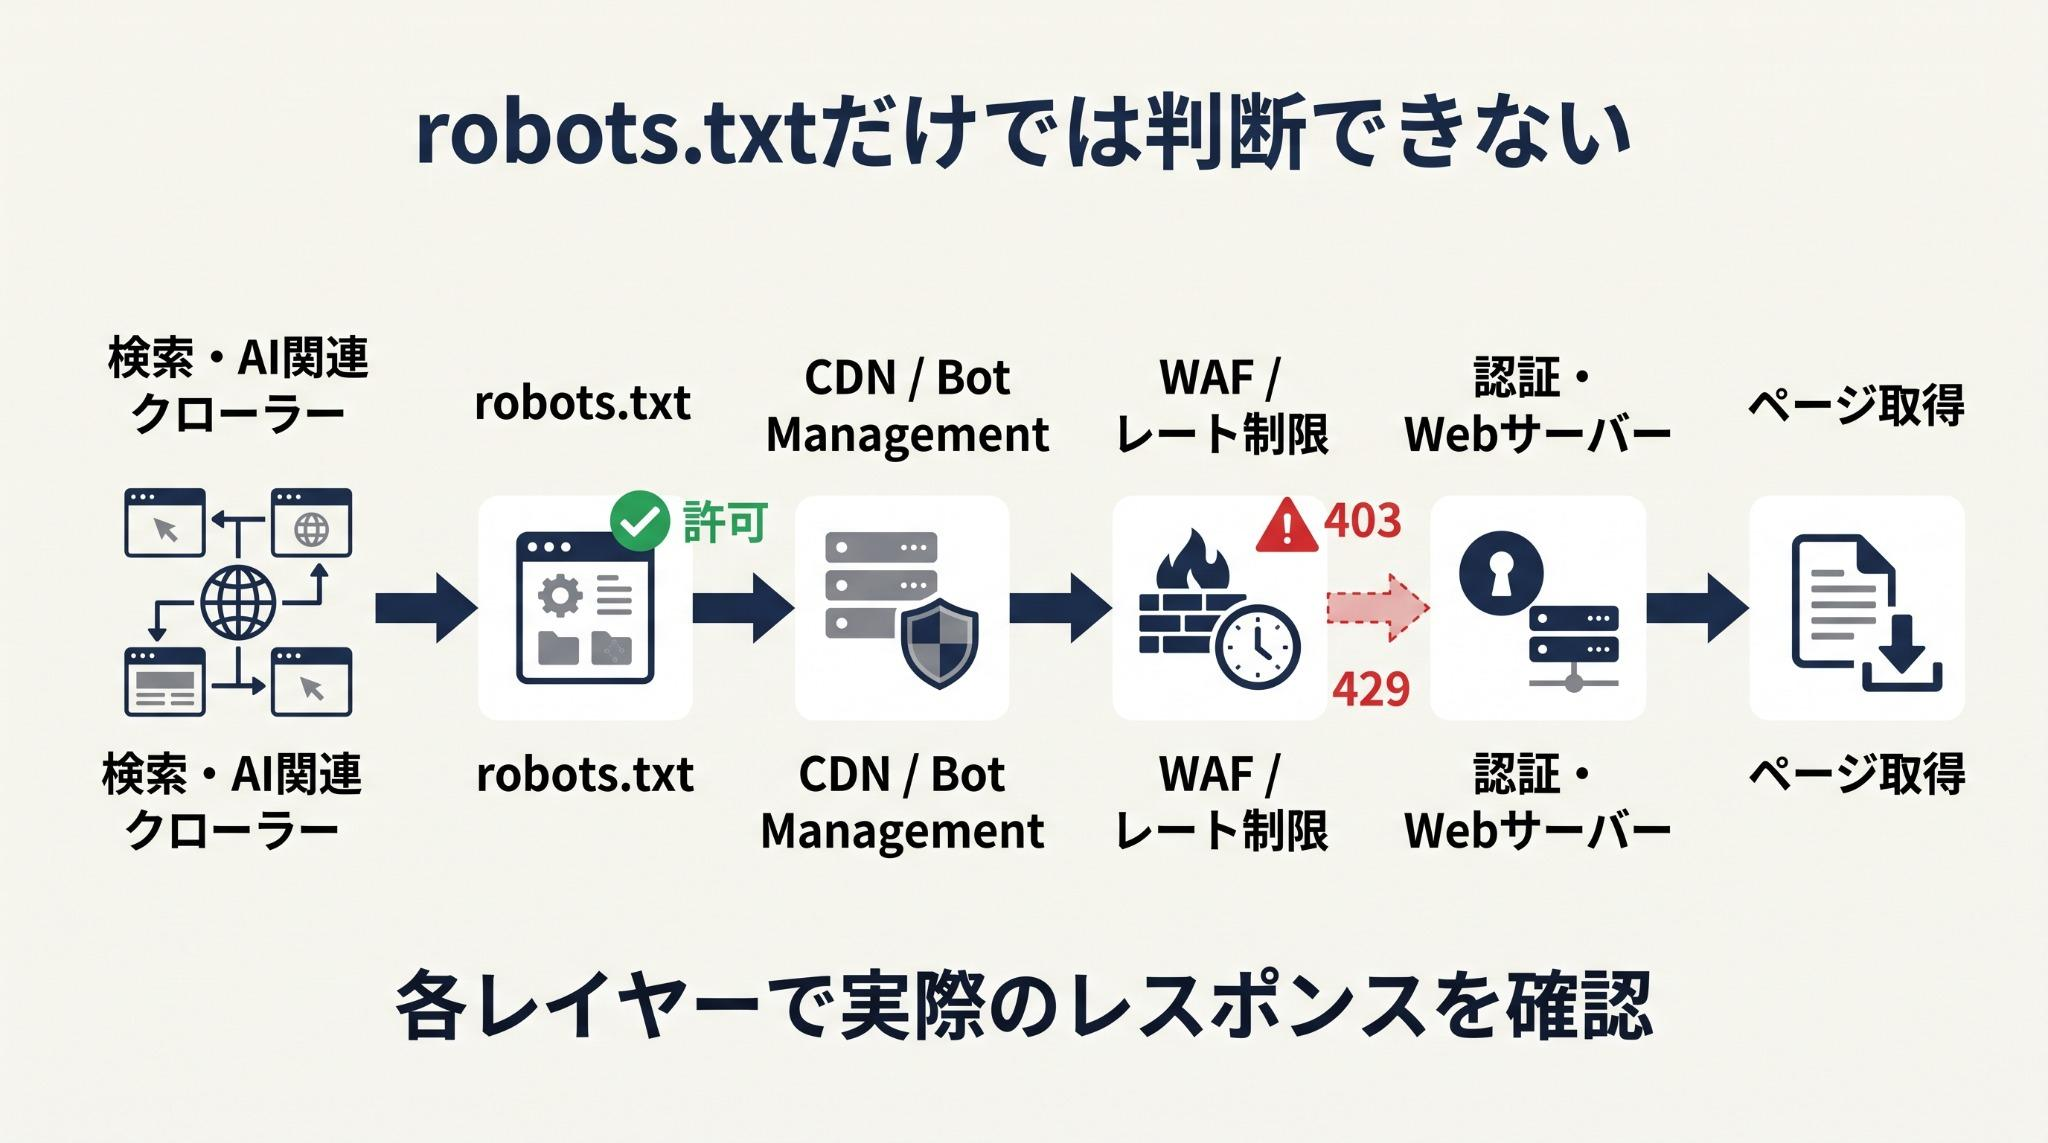
また、「AIクローラー」は一括りにできません。サービスによって、検索結果への掲載に使うクローラー、モデル改善・学習に関係するクローラー、ユーザー操作をきっかけにページへアクセスするUser-Agentなど、役割が分かれている場合があります。
たとえばOpenAIでは、OAI-SearchBotは検索機能向け、GPTBotは生成AI基盤モデルの改善・学習用途に関係するクローラー、ChatGPT-Userはユーザー操作を起点とするアクセスとして区別されています。設定も独立しているため、「AIを許可する/拒否する」という二択ではなく、用途ごとに自社の方針を決める必要があります。
主要ボットのUser-Agentや送信元IPの検証、CDN・WAF・Webサーバーのログ抽出、403・429・5xxなどHTTPステータス別の原因切り分け、修正後の再測定については「AIクローラーをアクセスログで確認する方法|主要ボットの識別とクロール阻害の診断」で詳しく扱います。
3.JavaScriptレンダリング|重要な情報を取得できるか
JavaScriptを使っていること自体は問題ではありません。確認すべきなのは、重要な本文・見出し・価格・FAQ・会社情報などを、対象となるクローラーが取得し、適切にレンダリングできるかどうかです。ここでのレンダリングは、JavaScriptを実行して表示内容のHTMLを組み立てる処理を指します。
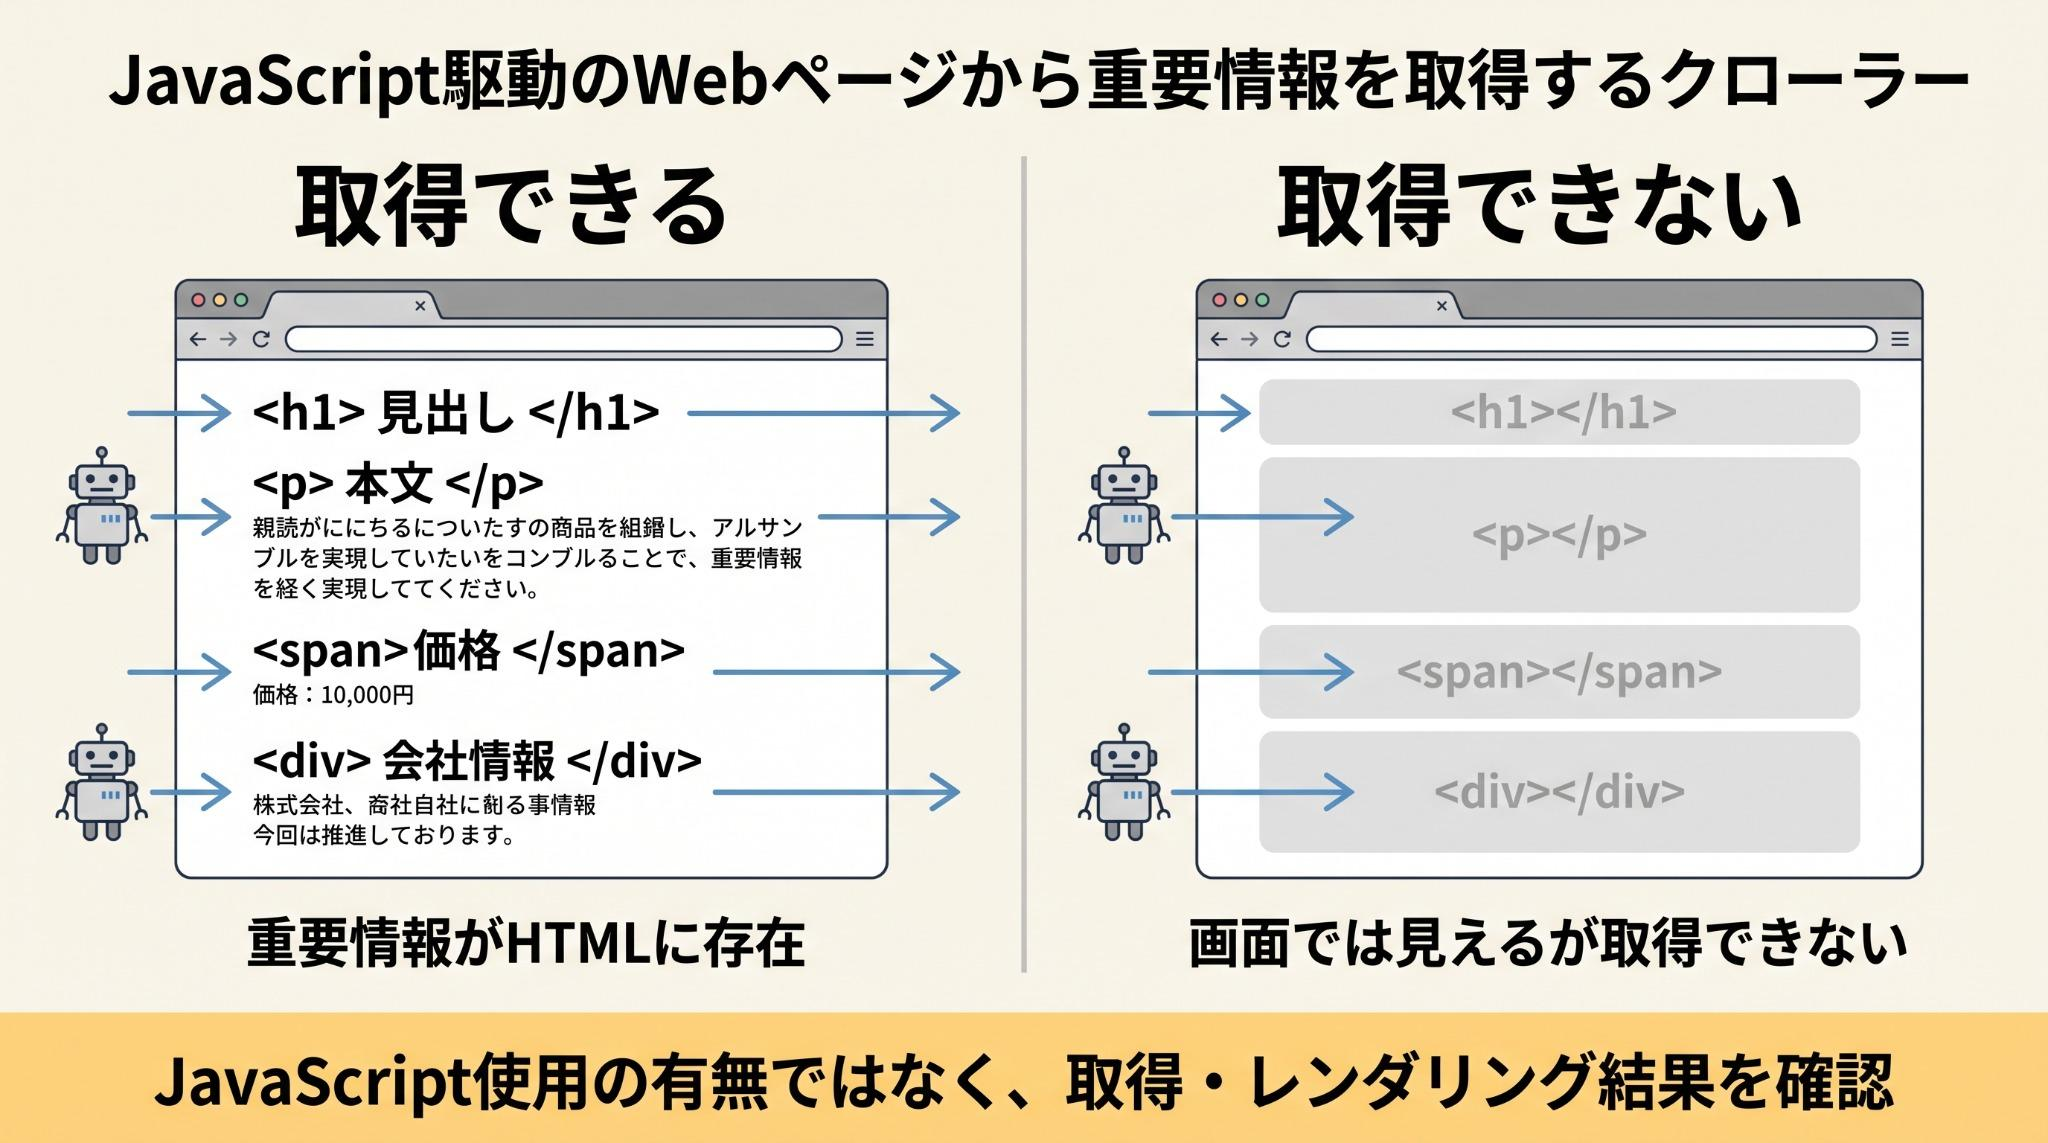
GoogleはJavaScriptを実行してレンダリングしたHTMLも、インデックス処理に利用します。ただし、レンダリングはクロールの後に行われる仕組みであり、すべてのボットがGooglebotと同じようにJavaScriptを処理するわけでもありません。Google自身も、サーバーサイドレンダリングやプリレンダリングを、ユーザーとクローラー双方の観点で有効な方法としています。
SSR、SSG、プリレンダリングなどの方式選定や、フレームワーク別の具体的な実装方法は、本記事の主題にはしません。本記事での判断ポイントは次の2点です。
- 重要コンテンツが、対象クローラーから取得できるか
- 初期HTMLまたはレンダリング後HTMLに、必要な情報が存在するか
この2点を確認し、問題があれば、開発側の詳細診断へつなぎます。
4.canonical・XMLサイトマップ・内部リンク|重要なURLを一貫して示せているか
同一・類似内容のURLが複数ある場合は、canonicalが意図した代表URLを示しているかを確認します。XMLサイトマップには、原則として検索対象にしたい正規URLを載せ、削除済みURLや不要なリダイレクトURLが残っていないかを点検します。
重要記事が孤立していないかも確認します。トップページ、カテゴリページ、関連する上位テーマの記事や同じテーマの記事などから自然な内部リンクがあり、サイト内をたどって発見できる状態を作ることが目標です。
canonical、サイトマップ、内部リンクは、個別のテクニックというより、「どのURLを重要ページとして発見・評価してほしいか」をサイト全体で一貫して示すための要素です。Googleもcanonicalやサイトマップ、クロール可能なリンクを、クロール・インデックス管理の主要項目として案内しています。
5.ページ体験・表示速度|利用に支障はないか
Core Web Vitalsやモバイル表示は、AI専用の評価指標ではありません。ただ、ユーザーがページを問題なく利用できる環境を作るうえでは見落とせない項目です。LCP、INP、CLSなどを確認し、特に主要ランディングページで、著しい読み込み遅延や操作遅延、レイアウト崩れがないかを見ます。
画像・JavaScript・外部タグの読み込み過多、不要なプラグイン、重い埋め込みコンテンツなどがある場合は、実際のユーザー体験とサイト運用への影響を見ながら改善します。
位置付けとしては、AIO対策だから速度を改善するのではなく、検索・AI経由で訪れたユーザーがコンテンツを問題なく利用できる状態を作る、と考えるのが適切です。LCP・INP・CLSのどこに問題があるかをフィールドデータとラボデータで切り分け、リソース読み込み、JavaScript実行、レイアウトシフトなどの原因を特定する具体的な診断・改善手順は「Core Web Vitals改善ガイド|LCP・INP・CLSの原因特定と優先順位付け」で扱います。
したがって、この段階ではスコアを細かく改善すること自体を目的にせず、主要ページに明らかな利用上の問題がないか、専門的な原因診断へ進む必要があるかを判断できれば十分です。
6.構造化データ|実装は必要か、優先順位はどこか
構造化データはAIO技術対策の一部ですが、実装しただけでAI回答への引用や検索順位の上昇が保証されるものではありません。基本は、Article、Organization、Breadcrumbなど、ページ内容と検索エンジン側の対応状況に合う構造化データを選び、画面上の本文とマークアップの内容を一致させることです。
企業ブログで記事向け構造化データがどこまで使われているかは、「企業ブログ19,748記事の構造化データ調査」で、Article系構造化データの設定率や未設定パターンを実測しています。
特に注意したいのがFAQPageです。Google Searchでは、FAQリッチリザルトの表示は2026年5月7日に終了しています。そのため、「FAQがあるからFAQPageを追加すれば検索結果で有利になる」という前提での実装は適切ではありません。
本記事では、構造化データを「検索エンジンなどがページ上の情報を解釈するための補助情報」と位置付け、AIO技術対策8領域の一つとして、実装要否と優先順位を判断するところまでを扱います。
どのページにどのSchemaを使うか、JSON-LDをHTMLやCMSの情報とどう整合させるか、Schema Markup ValidatorとRich Results Testをどう使い分けるか、テンプレート単位でどのように監査するかといった実装・検証手順は「AIOの構造化データ実装ガイド|何をマークアップし、どこを監査するか」で詳しく扱います。
7.多言語・多地域|言語別ページの対応関係は保たれているか
複数言語・複数地域向けのサイトでは、hreflang、URL構造、canonicalなどの整合性を確認します。言語・地域別ページの対応関係が崩れていると、意図しないページが検索結果に表示されるなど、対象ユーザーへの出し分けに問題が生じる可能性があります。
国内向けのみのサイトであれば、優先度は低くなります。一方、海外展開を予定している場合は、URL構造や言語別ページの管理方法を後から付け足すより、初期設計の段階で方針を決めておくほうが管理しやすくなります。
8.ログ・効果測定|変更の結果をどう確かめるか
技術対策は、一度直して終わりではありません。Search Console、アクセス解析、必要に応じてサーバーログなどを使い、検索表示、クロール状況、AI系クローラーのアクセス、AIサービス経由の流入、問い合わせなどを継続して確認します。
ただし、「AIに引用されたか」を単一の指標だけで完全に把握できるとは限りません。サービスごとに取得できるデータや参照方法が異なるため、自社で確認できる指標を決め、同じ条件で継続して観測します。あわせて、変更前の状態を記録しておくと、変更後との差を比べられます。
本記事で扱うログ・効果測定の目的は、技術変更によって「取得できるようになったか」「阻害が解消したか」を確認するところまでです。AI回答内での表示・引用・言及、AIサービス経由の流入、問い合わせなどをどのKPIで継続評価するかというAIO全体の効果測定設計は、技術監査とは役割を分けて考えます。
アクセスログから分かるのは、クローラーがどのURLへアクセスし、サイト側がどのレスポンスを返したかという技術的な事実です。「クロールされたこと」と「AI回答で引用されたこと」は、同じ成果指標として扱わないようにします。
見つかった課題はどの順番で直すか|優先順位の決め方
課題が複数見つかったときは、「影響度」と「修正難易度」に加えて、「重要ページが検索・AIから取得できない状態になっていないか」を最初の判断基準にします。前の節の1〜8は進める流れで、次の表は、見つかった課題を直す順番をA〜Dで示したものです。
| 優先度 | 影響度 | 修正難易度 | 代表例 |
|---|---|---|---|
| A | 高 | 低〜中 | noindex・robots・誤canonical・404など取得やインデックスを阻害する問題 |
| B | 高〜中 | 中 | 重要コンテンツのレンダリング問題・内部リンク・サイトマップ |
| C | 中 | 中〜高 | ページ速度・構造化データ・多言語対応 |
| D | 低 | 高 | 効果が不明確な個別最適化・将来施策 |
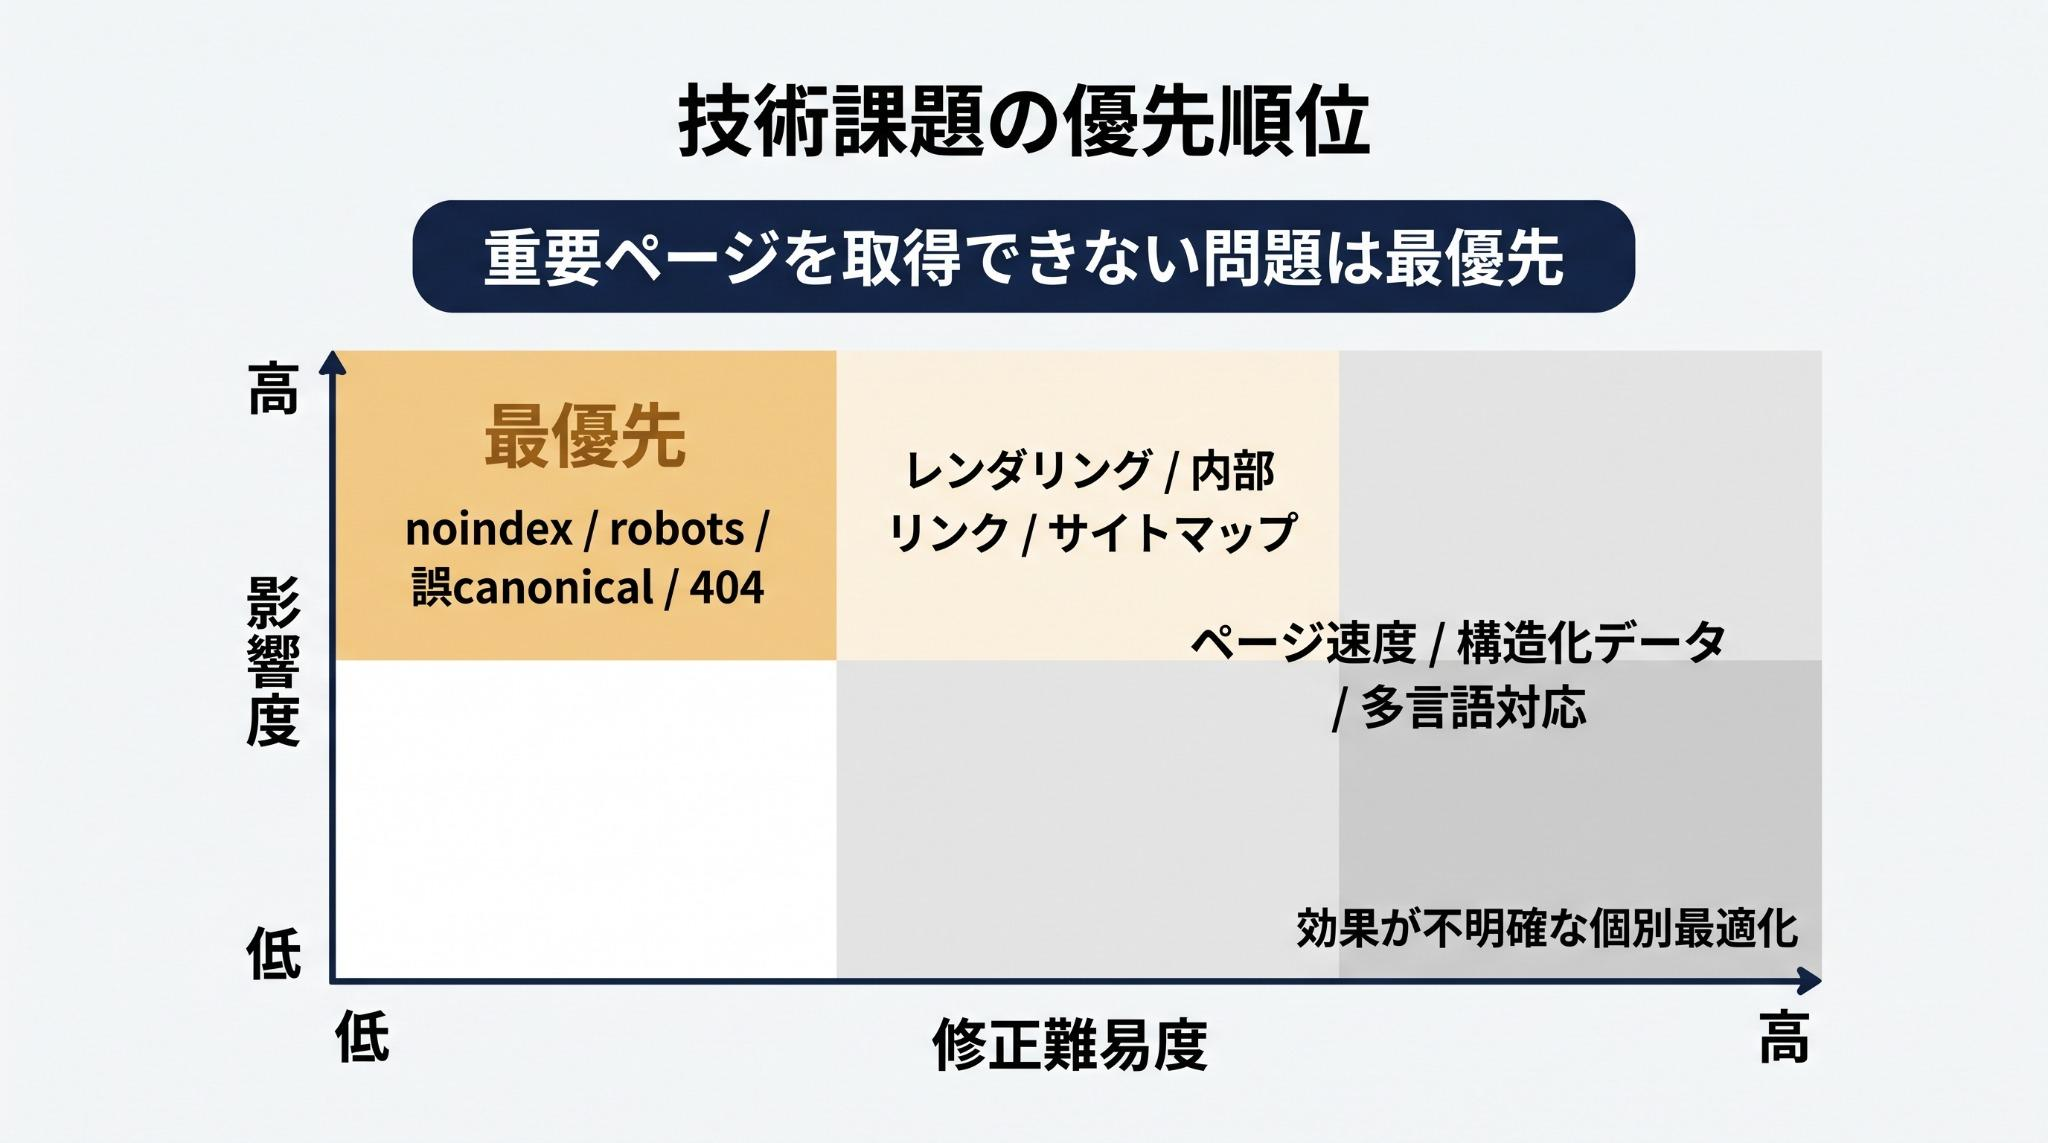
最優先のAは、noindex、robots.txt、誤canonical、404など、ページは存在しているのに検索・AI側から適切に扱えない問題です。取得やインデックス登録を妨げるため、ほかの施策より先に直します。
次のBでは、重要コンテンツのレンダリング問題、内部リンク、サイトマップなど、発見や理解を妨げる問題に対応します。ページ速度、構造化データ、多言語対応のCは、取得性や正規化などの基礎を確認したうえで、ページ内容と目的に応じて実装・改善します。効果が不明確な個別最適化や将来施策のDは、最後に回します。
AIO技術対策の実務チェックリスト
8領域の確認内容を1つの表にまとめると、次のとおりです。担当者間で、確認の抜けがないかを見るときに使えます。
| No. | 領域 | 確認内容 |
|---|---|---|
| 1 | クロール・インデックス | noindex・404・誤canonicalなどを確認 |
| 2 | robots.txt・AIクローラー | robots.txt・WAF・CDNなどによる誤遮断を確認 |
| 3 | JavaScriptレンダリング | 重要情報が取得・レンダリングできるか確認 |
| 4 | canonical・XMLサイトマップ・内部リンク | 正規URL・サイトマップ・孤立ページを確認 |
| 5 | ページ体験・表示速度 | LCP・INP・CLS・モバイル表示を確認 |
| 6 | 構造化データ | 対応状況と本文に合うSchemaを正しく実装 |
| 7 | 多言語・多地域 | hreflang・URL構造・canonicalの整合性 |
| 8 | ログ・効果測定 | 変更後のクロール・表示・流入などを同じ条件で継続して確認 |
表のNo.は、「AIOの技術対策8領域」の節の1〜8の番号に対応しています。
技術対策で陥りやすい4つの失敗
ここでは、技術対策を進めるときに起こりやすい失敗を、4つ挙げます。
構造化データから先に着手してしまう
サイトがクロール・インデックスできない状態でSchemaだけ追加しても、根本的な問題は解決しません。まず取得、インデックス登録、正規化、レンダリングを確認します。
また、検索エンジンが提供する構造化データの対応機能は変更されることがあります。特定のSchemaを「実装すれば効果が出るもの」と固定的に考えず、公式仕様を確認したうえで採用します。
AIクローラーをすべて許可すればよいと考える
許可と制限の考え方は領域2で見たとおりです。一律に許可せず、用途ごとにどれを許可し、どれを制限したいのかを自社の方針として決めます。
robots.txtの確認だけで終える
robots.txtの許可だけで安心せず、CDNやWAFなどによる遮断がないかも、領域2の内容に沿って確認します。詳しい診断の手順は、領域2で紹介した専門記事で扱います。
複数の変更を一度に実施する
複数の大規模な変更を同時に行うと、改善や悪化の原因を切り分けにくくなります。重要な変更は優先順位を付け、変更前の状態を記録しながら、段階的に進めます。
まとめ|技術対策は「見える・読める・正しく理解できる」状態を作ること
AIOの技術対策は、AI向けの特殊な裏技を追加する作業ではありません。検索エンジンやAI関連サービスが重要ページへ到達し、必要なコンテンツを取得し、正しいURLやページ内容を解釈できる状態を整えることが中心です。
そのため、最初にクロール・インデックス、robots.txt、HTTPレスポンス、レンダリング、canonical、内部リンクなどを確認し、その後にページ体験や構造化データへ進みます。
本記事の役割は、個別の実装テクニックを並べることではなく、8領域を見渡して、「何を先に確認し、どの問題を専門的な診断へ回すべきか」を判断できるようにすることです。
最初の一歩は、重要ページから、インデックス登録の状態とクローラーの遮断の有無を確認することです。企業担当者は、まず本記事で技術課題の位置と優先順位を特定し、問題が見つかった領域だけを専門記事で深掘りする流れで進めると、不要な施策を増やさずに改善できます。
PDF・ホワイトペーパーなど非HTML資料が本文・出典・更新情報までAI検索から参照できる状態かを確認する場合は、PDF・ホワイトペーパーのAIO監査方法で確認できます。
‹ 親記事: AIO対策完全ガイド|AIOとは?SEO・GEOとの違いからAI検索に引用・推薦される方法まで解説【2026年版】