「ChatGPTやClaudeのクローラーは自社サイトに来ているのか」「robots.txtでは許可しているのに、なぜ巡回されないのか」。こうした疑問を確かめるには、GA4ではなく、CDN・WAF・Webサーバーのアクセスログを確認します。
ただし、ログの確認は、User-Agent(アクセスしてきたブラウザやボットが名乗る識別用の文字列)を検索して終わりではありません。送信元IP、HTTPステータス、取得されたURL、robots.txtの応答を順番に照合して、はじめて「来ていない」のか「来ているが止められている」のかを区別できます。本記事では、主要なAIクローラーの識別方法から、阻害箇所の切り分け、修正後の検証までを、実務の手順として説明します。なお、本記事ではAIサービスが情報収集に使うクローラーを「AIクローラー」と呼び、個別のボットは名称で示します。
AIクローラーの確認では、どのログを見るべきか
最初に確認するのは、AIクローラーからのHTTPリクエストが記録されるアクセスログです。人間のブラウザと違い、一般的なAIクローラーはGA4の計測用JavaScriptを実行するとは限りません。そのため、GA4にアクセスがないことだけでは「AIクローラーが来ていない」と判断できません。
AI向けの技術対策の全体像から確認したい場合は、「AIOの技術対策とは?企業担当者が押さえるべき8領域の実務チェックリスト」を参照してください。
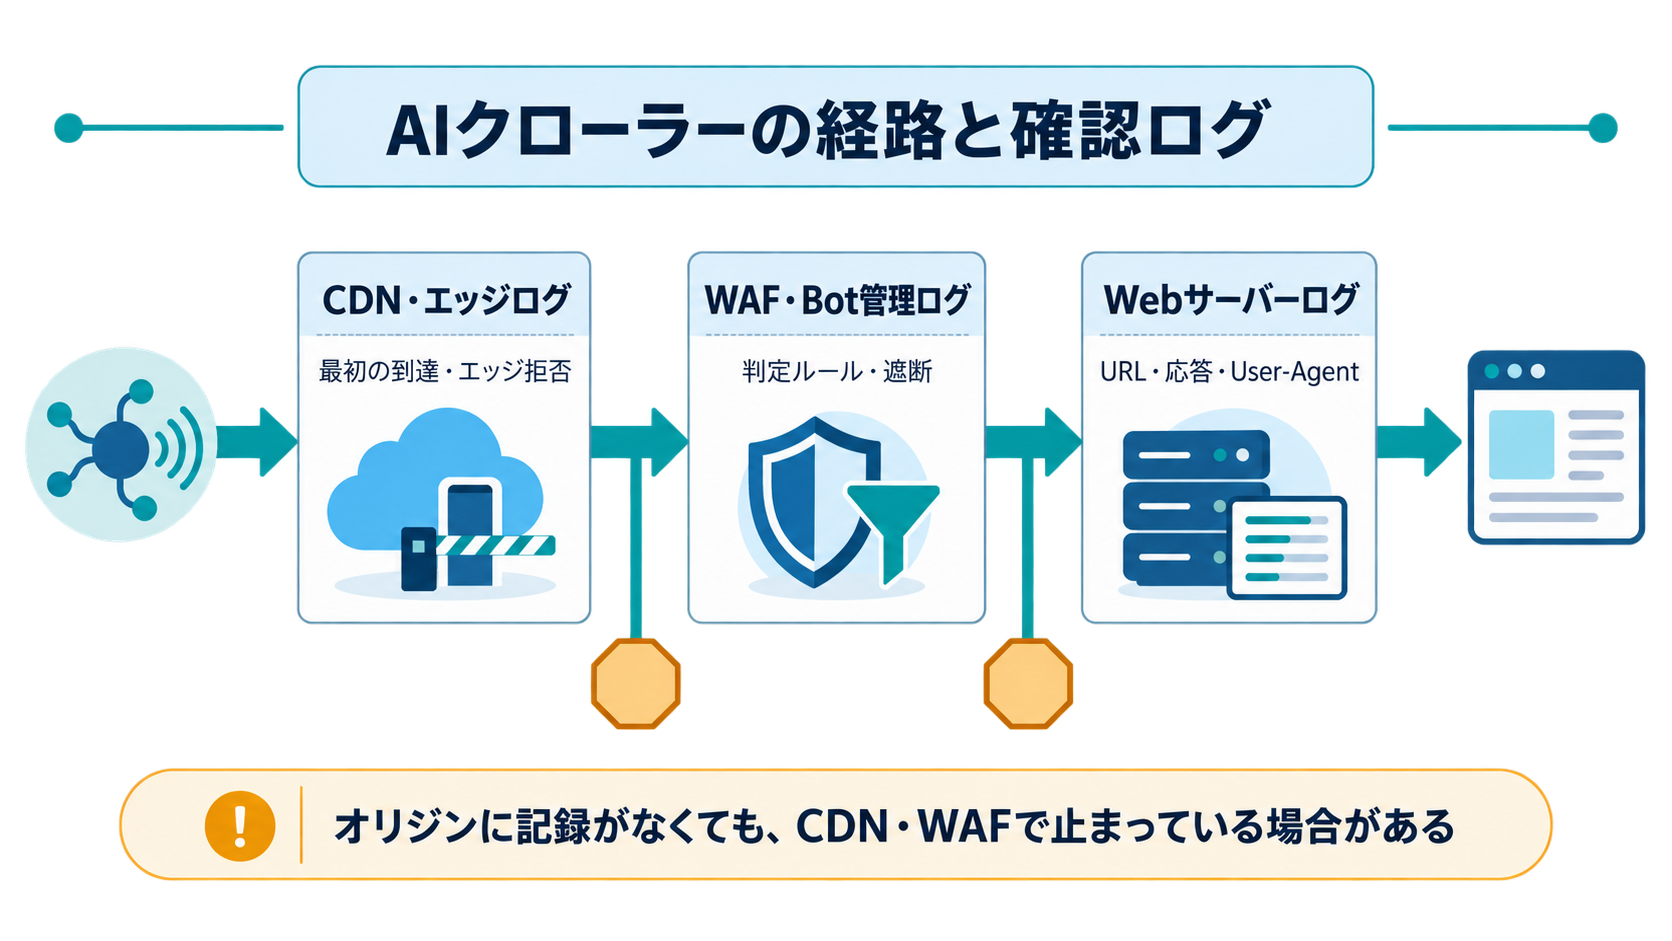
オリジンサーバーに記録がなくても、CDNやWAFまで到達し、そこで遮断されている可能性があります。
確認するログは、サイト構成に応じて次の3層に分かれます。表の「主な注意点」で、層ごとの見落としやすい点を確認してください。
| 確認するログ | 分かること | 主な注意点 |
|---|---|---|
| CDN・エッジログ | CDNまで到達したリクエスト、エッジ側の拒否 | オリジンサーバーへ転送されない403・429も確認できる |
| WAF・Bot管理ログ | セキュリティルール、Bot判定、チャレンジの結果 | User-Agentだけでなく、適用ルール名も確認する |
| Nginx・Apacheなどのアクセスログ | URL、日時、ステータス、転送量、User-Agent | CDN経由では送信元IPがCDNのIPになることがある |
CDNを利用している場合は、オリジンサーバー(CDNの背後にある、元のコンテンツを持つサーバー)のログだけでは足りません。CDNやWAFで遮断されたリクエストは、オリジンサーバーまで届かないためです。
あとで層ごとに照合できるよう、ログには最低限、次の項目を保存します。
- リクエスト日時
- クライアントIP
- HTTPメソッド
- ホスト名
- リクエストURL
- HTTPステータスコード
- User-Agent
- 応答時間
- 応答サイズ
- CDN・WAFの判定結果
- オリジンサーバーの応答コード
主要なAIクローラーは目的別に分けて識別する
AI関連のアクセスは、学習用、検索用、ユーザー操作による取得に分けて集計します。同じ会社のボットでも用途が違うため、一括して許可・拒否すると、意図しない範囲まで制限する可能性があります。
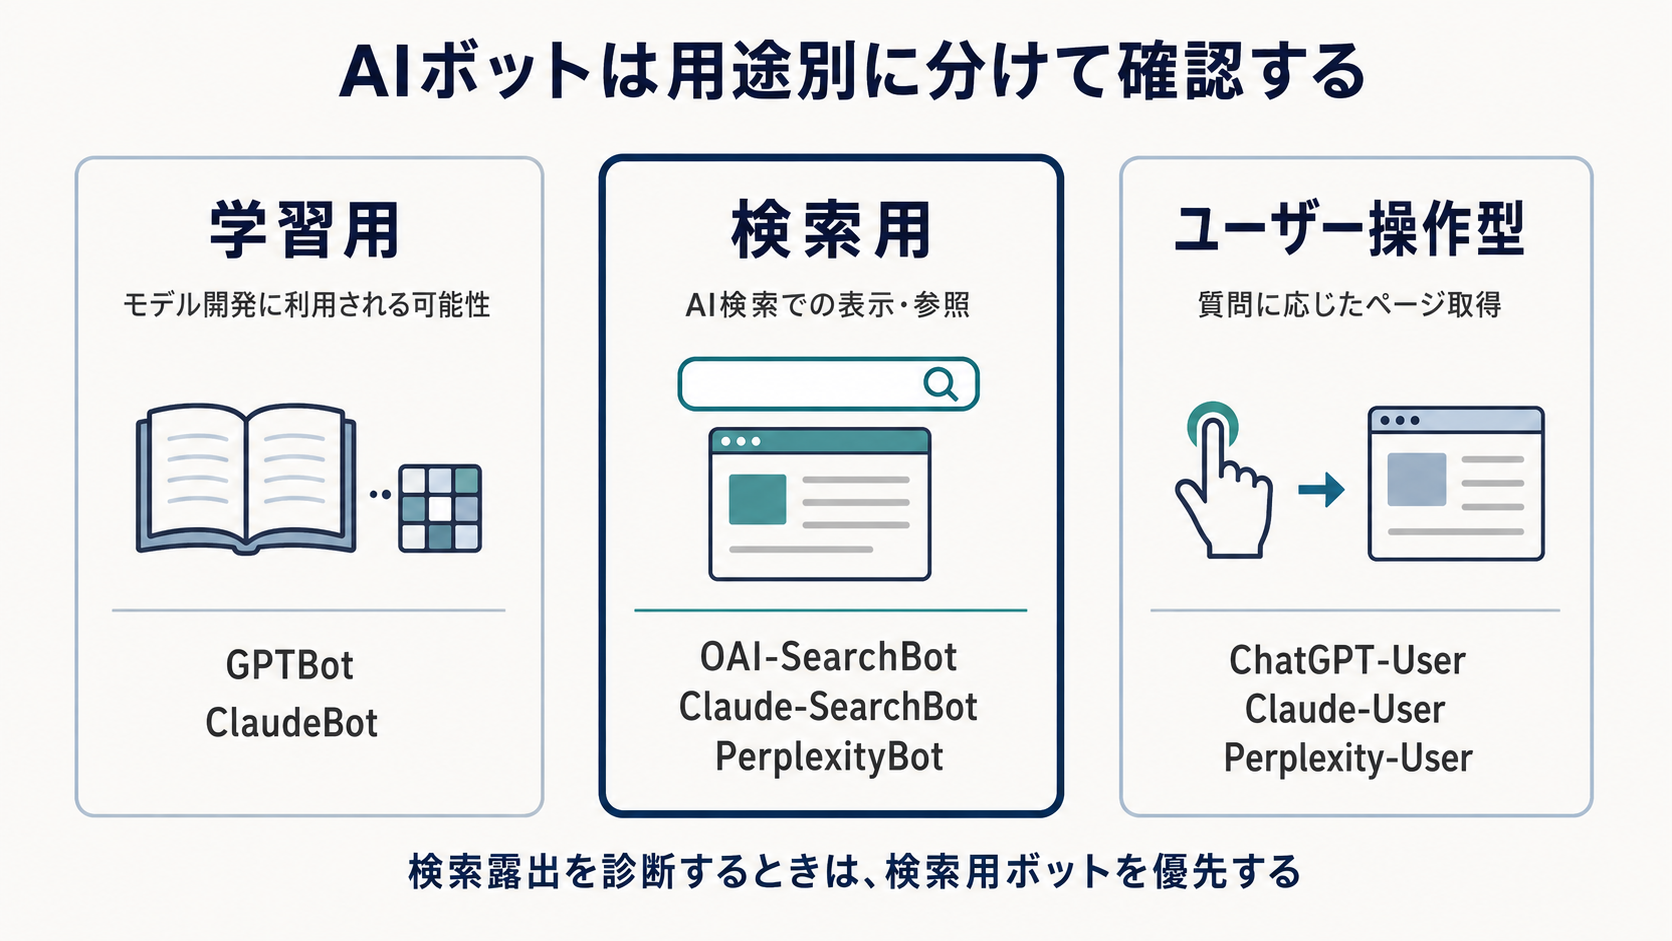
同じAI事業者のアクセスでも用途は異なります。検索露出の障害を調べる場合は、検索用ボットを優先して確認します。
2026年8月時点で優先的に確認したい名称は次のとおりです。「ログで探す文字列」の列が、検索に使う識別トークンです。
| 運営者 | ログで探す文字列 | 主な用途 | 診断上の扱い |
|---|---|---|---|
| OpenAI | GPTBot | 生成AIモデルの学習候補となるコンテンツの収集 | 検索表示用ボットと分ける |
| OpenAI | OAI-SearchBot | ChatGPT検索でサイトを表示するためのクロール | AI検索への露出に直接関係 |
| OpenAI | ChatGPT-User | ユーザー操作に応じたページ取得 | 自動クロールではない |
| Anthropic | ClaudeBot | モデル開発用の収集 | 検索用ボットと分ける |
| Anthropic | Claude-SearchBot | Claudeの検索品質向上 | 検索露出の診断対象 |
| Anthropic | Claude-User | ユーザー操作に応じた取得 | 件数が少なくても個別確認 |
| Perplexity | PerplexityBot | Perplexity検索結果への表示・リンク | 検索用クローラー |
| Perplexity | Perplexity-User | ユーザー質問に応じた取得 | 自動クロールと分離 |
| Googlebot | Google検索のクロール | AI Overviewsを含む検索基盤の確認に使用 |
OpenAIは、OAI-SearchBotを検索用、GPTBotをモデル学習用、ChatGPT-Userをユーザー操作に伴う取得用と説明しています。OAI-SearchBotを拒否したサイトは、ナビゲーションリンクを除き、ChatGPT検索の回答へ表示されないとされています。
Google系では、Google-Extendedの扱いに注意が必要です。Google-Extendedはrobots.txtで利用する制御用トークンであり、アクセスログに現れる独立したHTTP User-Agentではありません。そのため、GoogleのAI機能に関係するクロール状況は、GooglebotのログとGoogle Search Consoleのクロール統計で確認します。
アクセスログからAIクローラーを抽出する
ここからは、ログの抽出と集計の手順です。まず対象期間のログを用意し、主要な名称を部分一致で抽出します。バージョン番号は変更される可能性があるため、完全なUser-Agent文字列ではなく、GPTBotなどの識別トークンで検索します。
ログの抽出と合わせて、ページ側の構造化データも整えたい場合は、「AIOの構造化データ実装ガイド」で詳しく解説しています。
NginxやApacheの一般的なテキストログでは、次のコマンドで抽出できます。出力にボット名を含む行が表示されれば、そのボット名を名乗るアクセスがログに記録されています。名乗りが正規かどうかは、次の節で確認します。
grep -iE ‘gptbot|oai-searchbot|chatgpt-user|claudebot|claude-searchbot|claude-user|perplexitybot|perplexity-user’ access.log
ローテーションされた圧縮ログも含める場合は、zgrepを使います。
zgrep -hiE ‘gptbot|oai-searchbot|chatgpt-user|claudebot|claude-searchbot|claude-user|perplexitybot|perplexity-user’ access.log*.gz
ボット別の件数を集計する
単純な来訪有無だけでなく、ボット別、日別、URL別、ステータス別に集計します。最初のステップとして、次のコマンドでボット別の件数を出します。
for bot in GPTBot OAI-SearchBot ChatGPT-User ClaudeBot Claude-SearchBot Claude-User PerplexityBot Perplexity-User do printf ‘%-20s ‘ "$bot" grep -ic "$bot" access.log done
件数が0のボットがあっても、直ちに「来ていない」とは言えません。0件のときの確認順は、後述の「ログにない」場合の節で説明します。
ステータスコードと取得URLを確認する
次に、特定のボットが何を取得し、サーバーが何を返したかを見ます。一般的なcombined形式でHTTPステータスが9列目、URLが7列目にある場合は、次のように集計できます。ここではOAI-SearchBotを例に、1行目でステータス別、2行目でURL別(多い順の上位20件)の件数を出します。
grep -i ‘OAI-SearchBot’ access.log | awk ‘{print $9}’ | sort | uniq -c | sort -rn
grep -i ‘OAI-SearchBot’ access.log | awk ‘{print $7}’ | sort | uniq -c | sort -rn | head -20
ただし、列位置はログ形式によって異なります。JSON形式のログや、空白を含む独自形式では、固定列を前提にしたawkが誤集計することがあります。最初にログの定義と実際の1行を照合してください。
User-Agentだけで正規のAIクローラーと判断しない
User-Agentは送信者が自由に設定できるため、GPTBotと記録されていてもOpenAIからのアクセスとは限りません。正規のボットとして集計するときは、公式IPレンジまたは運営者が指定する認証方法と照合します。
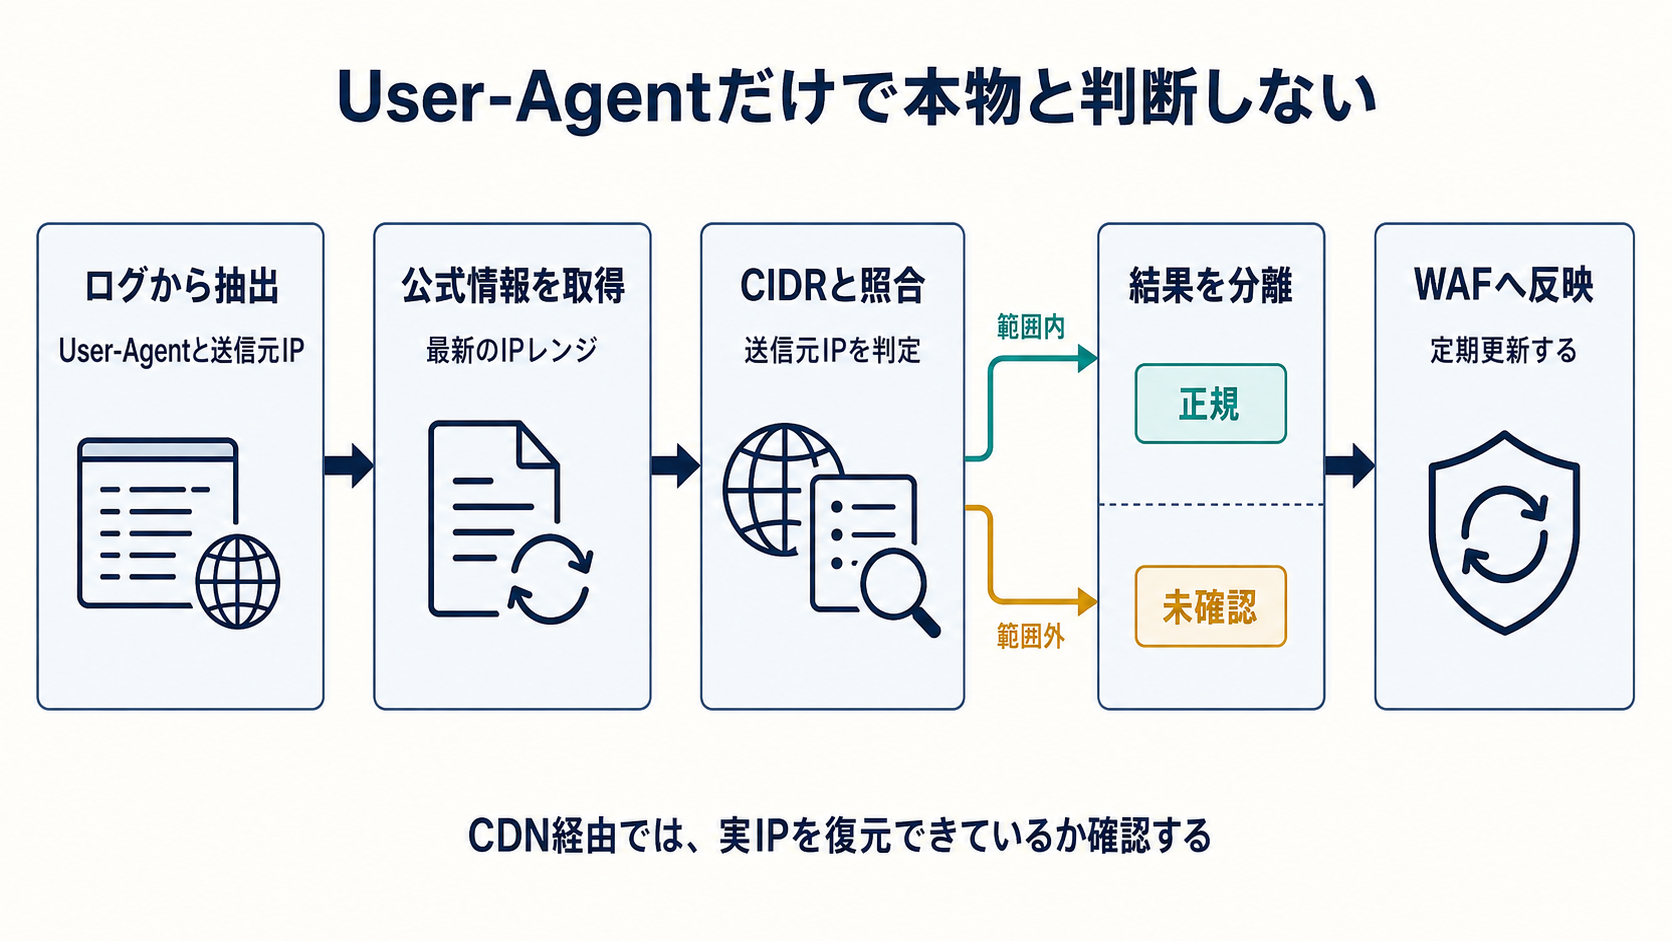
User-Agentは偽装できるため、送信元IPを最新の公式IPレンジと照合し、正規アクセスと未確認アクセスを分けます。
OpenAIは、GPTBot、OAI-SearchBot、ChatGPT-Userについて、それぞれ公式IPレンジのJSONを公開しています。AnthropicとPerplexityも公式の送信元IP情報を案内しています。
確認手順は次のとおりです。
- ログからUser-Agentと送信元IPを抽出する
- 該当事業者の最新IPリストを取得する
- 送信元IPが公式CIDR内に含まれるか判定する
- 一致しないアクセスは「未確認・偽装疑い」として分ける
- CDN経由の場合は、CDNが付与する実IPを正しく復元できているか確認する
公式IPリストは更新されます。WAFへ手作業で固定登録したままにせず、定期的に更新する仕組みを用意しましょう。
Googlebotについては、Googleが逆引きと正引きを組み合わせる検証方法を案内しています。次の2つのコマンドは、その例です(1つ目が逆引き、2つ目が正引き)。
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com
逆引き結果が所定のGoogleドメインであり、そのホスト名を正引きした結果が元のIPへ戻ることを確認します。逆引き結果のドメイン名だけを信用してはいけません。
ステータスコードからクロール阻害を診断する
AIクローラーがログに存在しても、目的のページを正常に取得できているとは限りません。ボット別・URL別にレスポンスを確認し、次の表の基準で原因を切り分けます。
| ログの状態 | 主な意味 | 優先して確認する場所 |
|---|---|---|
| 200 | HTMLを正常に返した | 本文内容、canonical、内部リンク |
| 301・302 | 別URLへ転送した | リダイレクト先、ループ、ホスト統一 |
| 304 | キャッシュ済み内容を再利用できる状態 | 通常は異常ではない |
| 401 | 認証が必要 | 公開対象URLへ認証が誤適用されていないか |
| 403 | アクセス拒否 | WAF、Bot対策、IP制限、CDNルール |
| 404・410 | URLが存在しない、または削除済み | サイトマップ、内部リンク、旧URL |
| 429 | リクエスト過多として制限 | レート制限、Bot管理ルール |
| 5xx | サーバー・ネットワーク側の失敗 | オリジン障害、タイムアウト、負荷、WAF |
| ログなし | 未訪問とは限らない | CDN遮断、ログ欠損、保存期間、検索条件 |
ステータスを見るときは、200の割合だけを見るのではなく、「公開・引用してほしい重要URLが200になっているか」を基準にします。画像、CSS、存在しないURLへの200が多くても、重要な記事やサービスページが403なら、目的を達成できていません。
robots.txt・CDN・WAFのどこで阻害されているか切り分ける
クロール阻害は、robots.txt、CDN・WAF、Webサーバー、アプリケーションの順に確認すると効率的です。
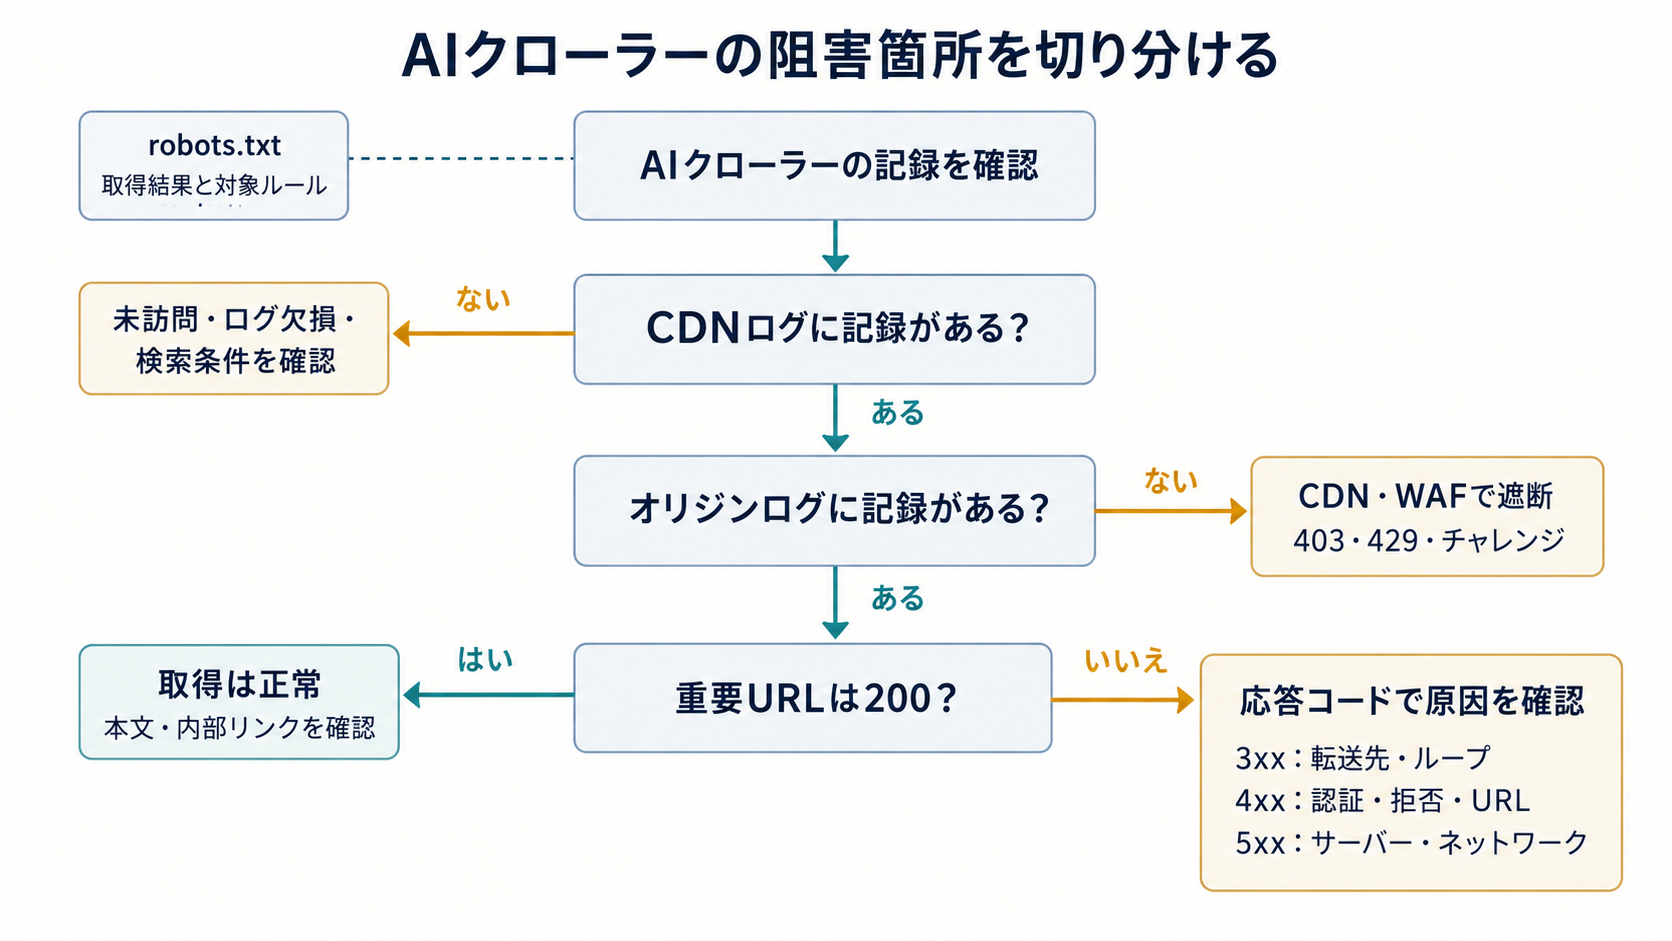
CDNログとオリジンログを順番に照合し、未訪問、エッジ側の遮断、正常取得、応答エラーを切り分けます。
1.robots.txtの取得とルールを確認する
最初の層はrobots.txtです。対象のUser-Agentを付け、robots.txtと重要URLの応答を確認します。
curl -I -A ‘OAI-SearchBot’ https://example.com/robots.txt
curl -I -A ‘OAI-SearchBot’ https://example.com/important-page/
-Iは応答ヘッダーだけを取得し、-AはUser-Agentを指定するオプションです。返ってきたステータスの意味は、前の節の表で確認できます。
あわせて、robots.txtの内容について次の点を確認します。
- https://対象ホスト/robots.txtが取得できる
- 200でtext/plainとして返される
- 対象ボットにDisallow: /が設定されていない
- ワイルドカードグループとの重複を確認した
- wwwあり・なしやサブドメインごとに確認した
- リダイレクトループや5xxが発生していない
robots.txtを取得できないときの扱いは、ステータスによって変わります。IETFのRFC 9309では、robots.txtが4xxの場合、クローラーはリソースへのアクセスを許可されたものとして扱うことがあります。一方、ネットワーク障害や5xxで取得不能な場合は、原則として一時的に全面拒否として扱います。robots.txtが503を返している状態を「拒否設定は書いていないから問題ない」と判断するのは危険です。
2.CDN・WAFの判定を確認する
CDNログにはリクエストがあるのにオリジンログにない場合、リクエストはエッジ側で止まっています。次の設定を確認します。
- Bot Fight ModeなどのBot対策
- マネージドルール
- IPレピュテーション判定
- 国・ASN・地域による制限
- JavaScriptチャレンジやCAPTCHA
- レート制限
- User-Agentの部分一致による拒否
- 公式IPレンジの許可設定
- ルールの優先順位
許可ルールは、User-Agentだけで作らず、公式IPレンジとのAND条件(両方に当てはまるときだけ許可する条件)を基本にします。これにより、正規ボットを許可しながらUser-Agent偽装を除外できます。
3.Webサーバーとアプリケーションを確認する
オリジンまで到達している場合は、Nginx・Apache・CMS・セキュリティプラグインを確認します。
特定のUser-Agentを拒否する設定、Basic認証、メンテナンス設定、IP制限、過剰なレート制限、アプリケーションエラーが代表的な原因です。ヘッドレスCMSやJavaScript中心のサイトでは、ステータス200でも初期HTMLに主要本文が含まれているか確認してください。
「ログにない」場合は5つの可能性を順番に確認する
ログ検索が0件でも、直ちに「AIサービスに無視されている」とは判断できません。次の5つの可能性があります。確認の順番は、リストの後の段落で示します。
- 対象期間中に実際の来訪がなかった
- ログの保存期間が短く、過去の記録が消えている
- CDN・WAFで止まり、オリジンログに残っていない
- User-Agent検索の名称や大文字・小文字が誤っている
- CDN経由でIPやログ形式が変換され、抽出に失敗している
最初にログ保存期間と記録項目を確認し、次にCDN、WAF、オリジンの各層を照合します。robots.txtを変更した直後は、各事業者の反映時間や次回クロールまで待ってから再測定します。
修正の優先順位は「全体拒否・重要ページ・効率低下」の順に決める
検出した問題は、影響範囲と検索露出への近さで優先順位を付けます。次の表を目安に、上の行から対応します。
| 優先度 | 状態 | 対応 |
|---|---|---|
| 最優先 | robots.txtが5xx、検索用ボットを全面拒否、WAFで全件403 | 全体障害を修正し、公式IPで再検証 |
| 高 | 重要記事・サービスページだけ403、404、5xx | URL単位のルールとアプリを修正 |
| 中 | 429が多い、応答が遅い、リダイレクトが連続 | レート制限と処理性能を調整 |
| 中 | 低価値URLばかり取得される | 内部リンク、サイトマップ、URL設計を改善 |
| 低 | 一部の偽装ボットが正規ボット名を使用 | 公式IP外をWAFで分離・制限 |
AI検索への掲載を重視する場合は、学習用ボットよりもOAI-SearchBot、Claude-SearchBot、PerplexityBotなど検索用途のアクセス障害を先に確認します。
修正後は同じ条件で再測定する
設定変更後は、変更前後を比較できる形で検証します。最低限、次の指標を週次または月次で記録します。
- 正規ボット別のリクエスト数
- 200、3xx、4xx、5xxの割合
- 重要URLのクロール有無
- 初回取得日と最終取得日
- 403・429・5xxが発生したURL
- robots.txtの取得結果
- ユーザー操作型アクセスの対象URL
- 設定変更日
ログで分かるのは、「どのボットが、いつ、どのURLへ来て、サーバーが何を返したか」までです。クロールされたことだけでは、AI回答への引用、モデル学習への採用、ブランドの推薦を証明できません。引用状況は、主要な質問でAI回答を定点観測し、参照URLやブランド言及を別途測定します。
AIクローラー確認の流れと最初の一歩
AIクローラーの来訪と阻害を確認するには、GA4ではなく、CDN・WAF・Webサーバーのアクセスログを使います。User-Agentで主要ボットを抽出した後、公式IPレンジで真正性を確認し、URL別のHTTPステータスから阻害箇所を切り分けてください。
診断は「ログの取得範囲」「正規ボットの識別」「robots.txt」「CDN・WAF」「オリジン」「修正後の再測定」の順で進めると、来訪がない状態と、来訪しているが拒否している状態を区別できます。最初の一歩は、直近30〜90日分のログを保存し、検索用AIクローラーが重要ページから200を受け取れているか確認することです。
参考文献・データ元
この記事で参照した情報を確認できます。
- 「Overview of OpenAI Crawlers」OpenAI、2026年8月17日確認。OAI-SearchBot、GPTBot、ChatGPT-Userの用途、User-Agent、公開IPレンジの確認に使用。https://developers.openai.com/api/docs/bots
- 「Does Anthropic crawl data from the web, and how can site owners block the crawler?」Anthropic、2026年4月7日。ClaudeBot、Claude-User、Claude-SearchBotの用途とrobots.txtへの対応確認に使用。https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
- 「Perplexity Crawlers」Perplexity、2026年8月17日確認。PerplexityBot、Perplexity-User、公式IPレンジ、WAF設定の確認に使用。https://docs.perplexity.ai/docs/resources/perplexity-crawlers
- 「Verify requests from Google crawlers and fetchers」Google、2026年8月17日確認。GooglebotのIPレンジおよび正引き・逆引きによる検証方法の確認に使用。https://developers.google.com/crawling/docs/crawlers-fetchers/verify-google-requests
- 「Verified bots」Cloudflare、2026年7月1日更新。検証済みボットの認証方法、検索・エージェント・学習の分類確認に使用。https://developers.cloudflare.com/bots/concepts/bot/verified-bots/
- 「RFC 9309: Robots Exclusion Protocol」IETF、2022年9月。robots.txtの標準仕様、4xx・5xx・リダイレクト時の扱いの確認に使用。https://www.rfc-editor.org/rfc/rfc9309
- 「RFC 9110: HTTP Semantics」IETF、2022年6月。HTTPステータスコードの意味の確認に使用。https://www.rfc-editor.org/rfc/rfc9110
‹ 親記事: AIOの技術対策とは?企業担当者が押さえるべき8領域の実務チェックリスト