「ボタンの色を変えたら、問い合わせが増えた気がする。本当に変更の効果なのだろうか」。Webサイトを改善していると、数字が動いた理由を確かめたくなる場面があります。 A/Bテストは、その確認のための方法です。ただし、始める前に決めておくことがいくつかあります。結論から言うと、仮説と判断基準を先に決め、必要な訪問数を見積もり、終了条件を決めてから始めれば、結果を信頼しやすくなります。実装では、検索エンジン向けの注意も欠かせません。 この記事では、Webサイト全体を対象にしたA/Bテストの進め方を、仮説、サンプルサイズ、検定、実装、判断の順に整理します。コンバージョン率(CVR。サイトを訪れた人のうち、問い合わせなどの成果に至った人の割合)の水準ごとに、必要な訪問数の目安も計算して示します。
A/Bテストとは|2つ以上のパターンを比べて、反応の差を確かめる方法
Googleの検索セントラルは、ウェブサイトのテストを「さまざまなバージョンのウェブサイト(またはウェブサイトの一部)を試し、各バージョンへのユーザーの反応に関するデータを収集します」と説明しています。そのうえで、A/Bテストは変更のパターンを2つ以上テストするもの、多変量テストは複数の変更を一度にテストし、それぞれの影響と変更間の相乗効果を確認するもの、と区別しています。
たとえば、現在の申し込みボタンをAパターン、文言や色を変えたものをBパターンとして、訪問者に振り分けて表示します。振り分けでは、役割の違う2つのことを分けて考えます。1つは、どちらのパターンを見せるかを訪問者ごとに無作為(ランダム)に決めることです。時期、流入元、端末などの違いが両パターンに同じように混ざるため、差をパターンの違いによるものとして比べやすくなります。もう1つは、各パターンに何割の訪問者を割り当てるかという人数配分です。均等(50%ずつ)にするのが基本で、同じ訪問数で差を見つけやすいためです。配分を偏らせると、必要な訪問数は増えます。また、AとBは同じ期間に並行して表示します。期間を分けると、時期の違いによる影響が混ざります。
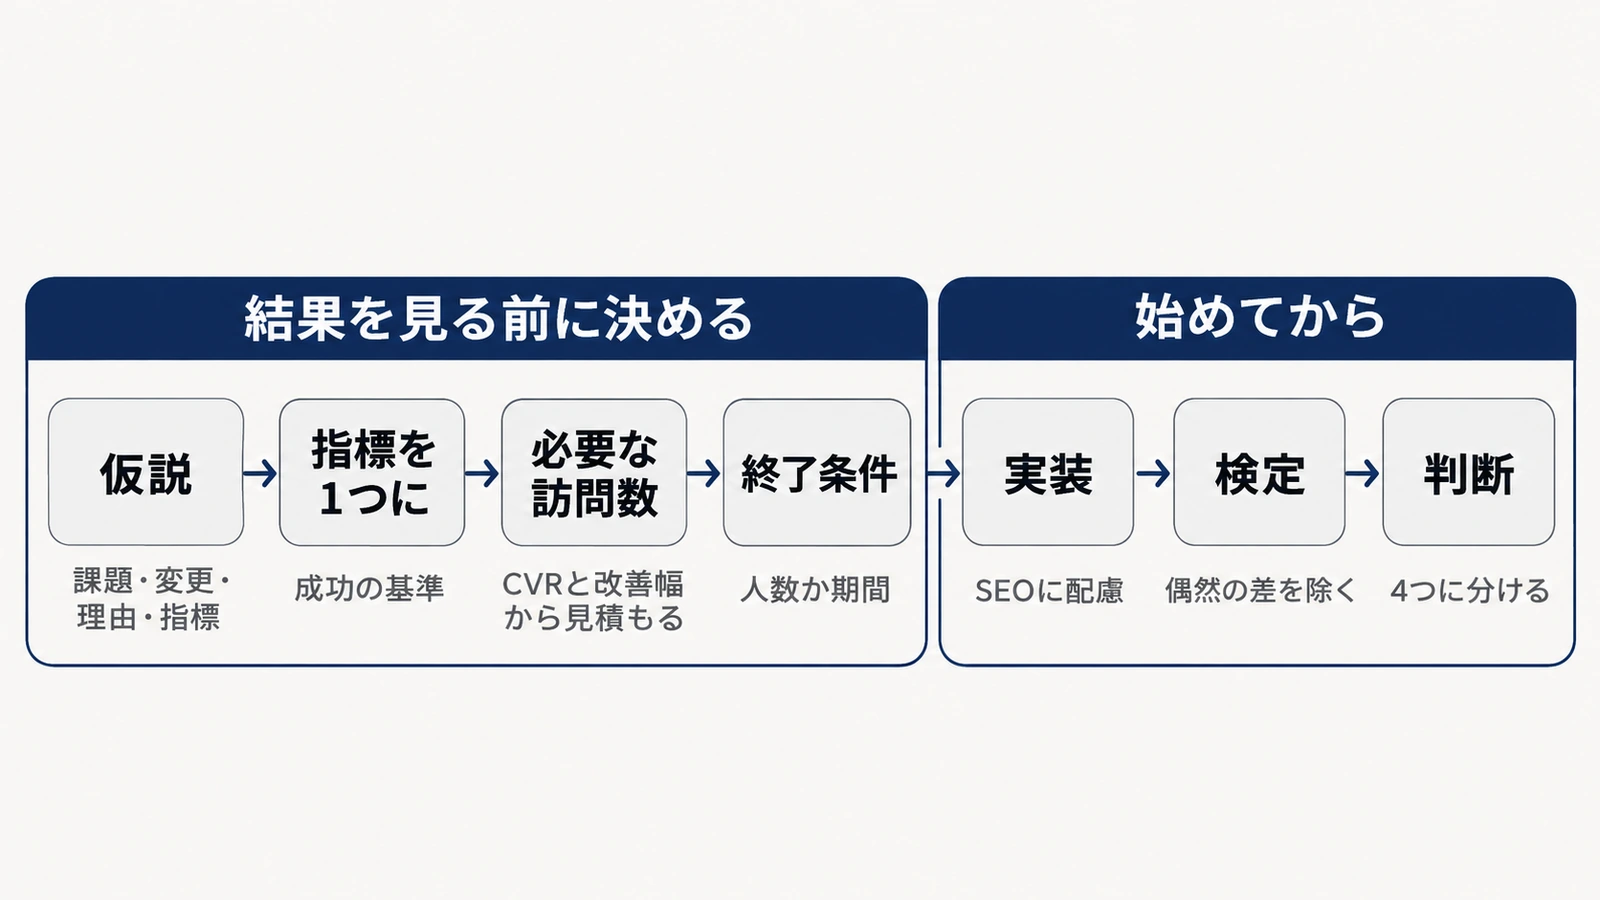
前半の4つは結果を見る前に決めておき、後半の3つはテストを始めてから進めます。
この記事は、Webサイト全体の標準的な進め方を扱います。採用施策や特定のCTAに特化した検証の設計は、対象にしていません。記事のCTAを検証する場合は、記事CTAのA/Bテストを設計する方法を参照してください。
仮説の立て方|課題・変更・理由・指標をひと続きで書く
仮説は、思いつきではなく、データ分析から見つけた課題にもとづいて立てることが重要です。たとえば、「資料請求ページでボタンが目立たず、クリック率が低い」という課題に対して、「ボタンの色を青から緑に変更することで、視覚的な訴求力が高まり、クリック率が向上する」と仮説を立てる、という形です。
この例のように、仮説には次の4つが入っているかを確認します。
- 課題:どのページの、どこで離脱しているか。
- 変更:何を、どう変えるか。
- 理由:なぜ、その変更で行動が変わると考えるか。
- 指標:何の数字が、どちらへ動けば成功とみなすか。
指標は、最初に1つに絞ります。何を基準に成否を判断するのかを、結果を見る前に決めておくためです。補助的に見る数字(直帰率や滞在時間など)も、最初に決めておきます。
サンプルサイズ|始める前に必要な訪問数を見積もる
結果を信頼できるかどうかは、集まった訪問数に左右されます。必要な訪問数は、現在のCVR、最小検出可能効果(見つけたい最小の改善幅)、有意水準、検出力の4つから決まります。
この記事では、次の条件で必要な訪問数を計算しました。有意水準5%と検出力80%は、ブリティッシュコロンビア大学の統計学科が公開する、二つの割合を比べる標本数の計算ページの初期値と同じです。
- 有意水準:5%(両側)
- 検出力:80%
- 訪問者をランダムに振り分け、2つのパターンの人数配分は均等(50%ずつ)にする
- 成果の有無(コンバージョンしたか)を、訪問者ごとに数える
ここでの有意水準は、実際には差がないのに「差がある」と判断してしまう誤りを、どの程度まで許すかの基準です。検出力は、実際に差があるときに、それを見つけられる確率です。両側は、改善する方向と悪化する方向の両方の差を調べる、という意味です。
計算には、二つの割合を比べるときの標本数の式を使いました。1パターンあたりの人数をn、現在のCVRをp₁、改善後のCVRをp₂として、n=(1.96+0.84)²×(p₁(1−p₁)+p₂(1−p₂))÷(p₁−p₂)²です。1.96は有意水準5%(両側)、0.84は検出力80%に対応する値で、2つのパターンの人数は同じとします。小数点以下は切り上げています。医学統計の解説論文にある例(p₁=0.2、p₂=0.3)では各群約291例とされており、この式で計算しても同じ数になります。
条件別の、1パターンあたりの必要訪問数は次のとおりです(この記事の計算)。「改善幅」は、現在のCVRに対する相対的な増加を表します。
| 現在のCVR | 改善幅 +10% | 改善幅 +20% | 改善幅 +30% |
|---|---|---|---|
| 1.0% | 162,908 | 42,642 | 19,802 |
| 2.0% | 80,588 | 21,082 | 9,784 |
| 5.0% | 31,196 | 8,146 | 3,773 |
表の読み方を、現在のCVRが2.0%のサイトで確認します。CVRを2.0%から2.4%(+20%)に上げる変更を検出するには、1パターンあたり21,082人、2パターン合計で42,164人の訪問が要ります。1日にテストの対象になる新しい訪問者(同じ人を重ねて数えない)が3,000人なら、必要な期間は約14日です。
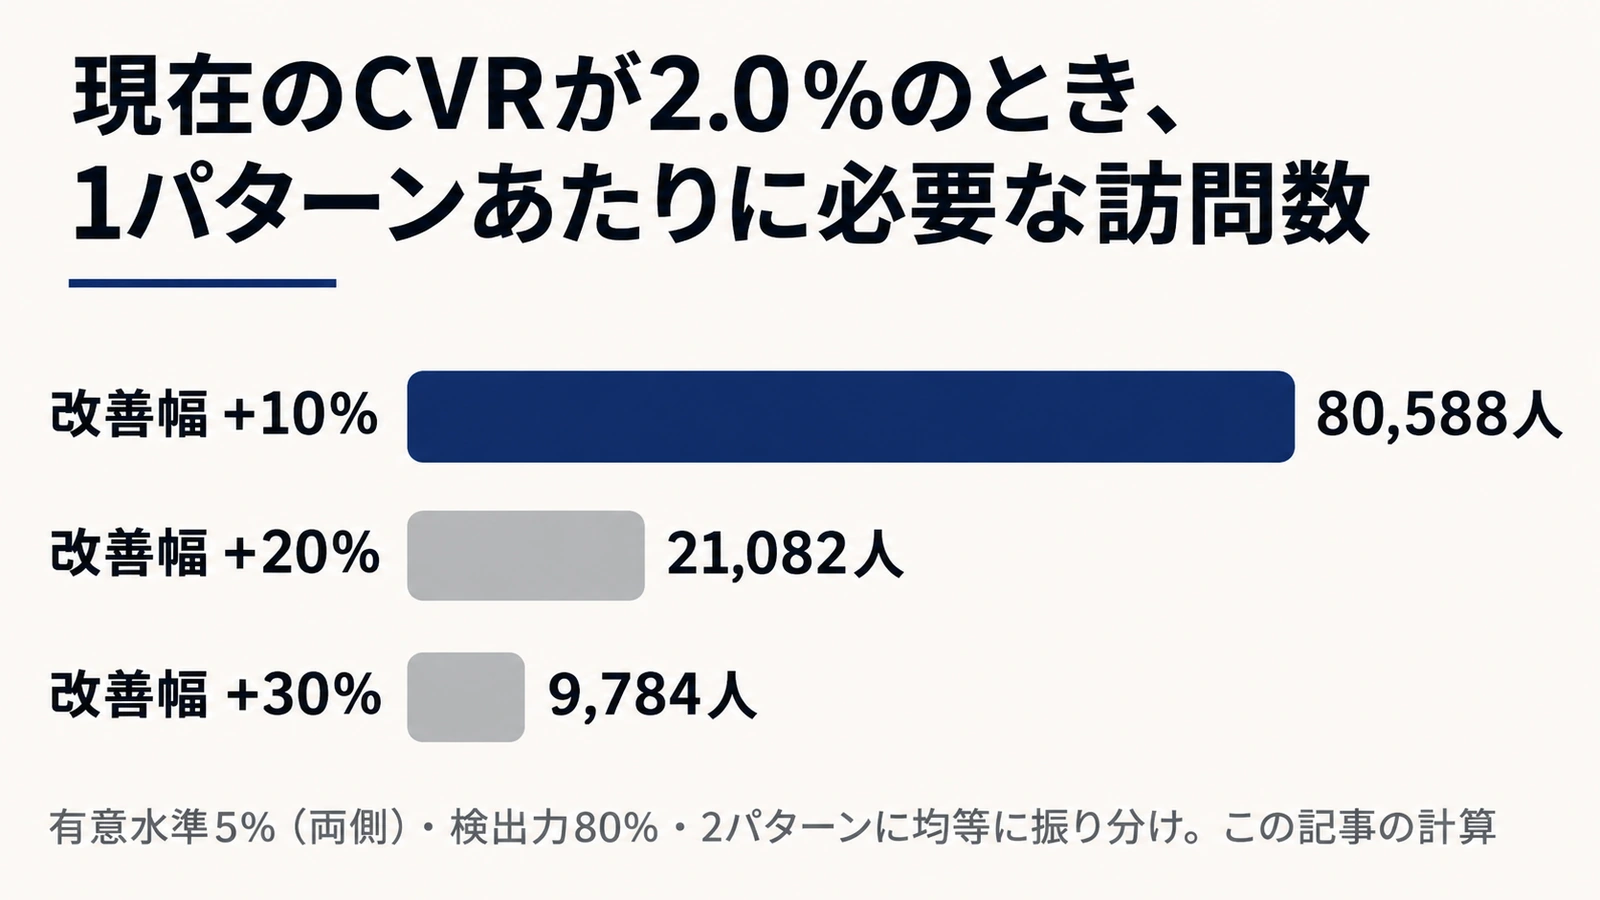
この記事の計算による値です。見つけたい改善幅が小さいほど、必要な訪問数が大きく増えます。
この表は、有意水準5%、検出力80%、均等な2分割、指標は1つという条件での計算です。条件を変えれば数字は変わります。複数の指標を同時に判定する場合や、パターンが3つ以上の場合は、この前提に当てはまらないため、別に計算する必要があります。式は、割合の差を正規分布で近似して標本数を求める形のもので、検定の方法や補正の有無によって、計算ツールの結果と異なることがあります。重要な判断に使う場合は、お使いの計算ツールの結果と照らし合わせてください。
この表から分かるのは、見つけたい改善幅が小さいほど、必要な訪問数が急に増えることです。訪問数が少ないサイトで小さな変更を検証しようとすると、結論が出ないまま長引きます。その場合は、変更の幅を大きくするか、成果に近い指標ではなく手前の指標(クリックなど)を使うか、検証を見送る判断も要ります。
期間の目安は、一般に2週間から4週間程度とされています。必要訪問数から逆算した日数と照らし合わせて、期間を決めてください。
検定と終了条件|偶然の差を除いて判断する
集まったデータの差が、偶然ではないかを確かめるのが検定です。有意差の確認には、t検定やχ²検定(カイ二乗検定)が用いられます。実際にどの検定が使われるかは、お使いのテストツールの説明で確認してください。
判定の基準は、始める前に決めておきます。判定の目安の一例は、AとBの差について「p < 0.05 かつ、差の信頼区間が0をまたがない」ことです。終了条件の一例は、「必要サンプル数の達成、または設定期間の経過」です。p値は、差がないと仮定したときに、観測した結果と同じか、それより極端な結果が得られる確率です。検討している仮説が正しい確率ではない点に注意してください。信頼区間は、真の値を含むと考えられる下限と上限を示す範囲です。
期間が過ぎても、必要訪問数に届かないことがあります。その場合は「結論を出せなかった」と扱います。必要訪問数に届かないときの選択肢には、テスト期間の延長、次回のテストで検出したい差を大きくすること、複数回のテスト結果を統合することなどがあります。ただし、結果を見てから検出したい差を変えたり、条件の違う結果を単純に足したりしてはいけません。期間を延ばす場合の条件も、始める前に決めておきます。
もうひとつ、結果を見る前に確認したいのが、振り分けの偏りです。設計した比率と実際の訪問者数の比率の間に、統計的に有意なずれがある状態を、サンプル比率のミスマッチ(SRM)と呼びます。ランダム化や計測の不具合で起こり、χ²検定で検出できます。eBayの実験基盤を扱った研究(arXivのプレプリントで、査読の有無は確認できていません)は、1日に数百件のA/Bテストが動く環境で、ランダム化の検証とSRMの検出を自動で監視する方法を論じています。
簡単な例で確認します。1,000人を50対50に振り分ける設計で、実際の人数が600人と400人だったとします。期待される人数は500人ずつなので、χ²値は(600−500)²÷500+(400−500)²÷500=40です(この記事の計算)。設計の比率から、これだけ離れた結果です。ずれがどの大きさから警告になるかは、お使いのツールの基準に従ってください。比率に大きなずれがあるときは、振り分けの実装や計測に問題がないかを先に点検し、点検が済むまでは、その結果を成果の根拠に使うのは避けます。
実装|SEOを損なわないための4つの注意
テストの実装では、検索エンジンへの配慮が欠かせません。Googleは、次の方法をすすめています。
- クローキングをしない:「Googlebot と人間のユーザーに対して、異なる URL のセットを提示しないでください」と書かれています。
- rel="canonical"を使う(テストで複数のURLを使う場合):代替URLのすべてに rel="canonical" のリンク属性を付け、元のURLが優先されるバージョンであることを示します。Googleは、noindexのmetaタグではなく、こちらをすすめています。
- 301ではなく302を使う(元のURLからパターンのURLへ転送する場合):「301 (permanent) リダイレクトではなく、302 (temporary) リダイレクト」を使います。
- 必要な期間だけ実行する:Googleは、必要以上に長くテストを続けているサイトを、検索エンジンを欺く意図があるものとみなして措置を取ることがある、としています。テストが終わったら、選んだバージョンをサイトに反映し、代替URLやテスト用のスクリプトなどを、できるだけ早く外します。
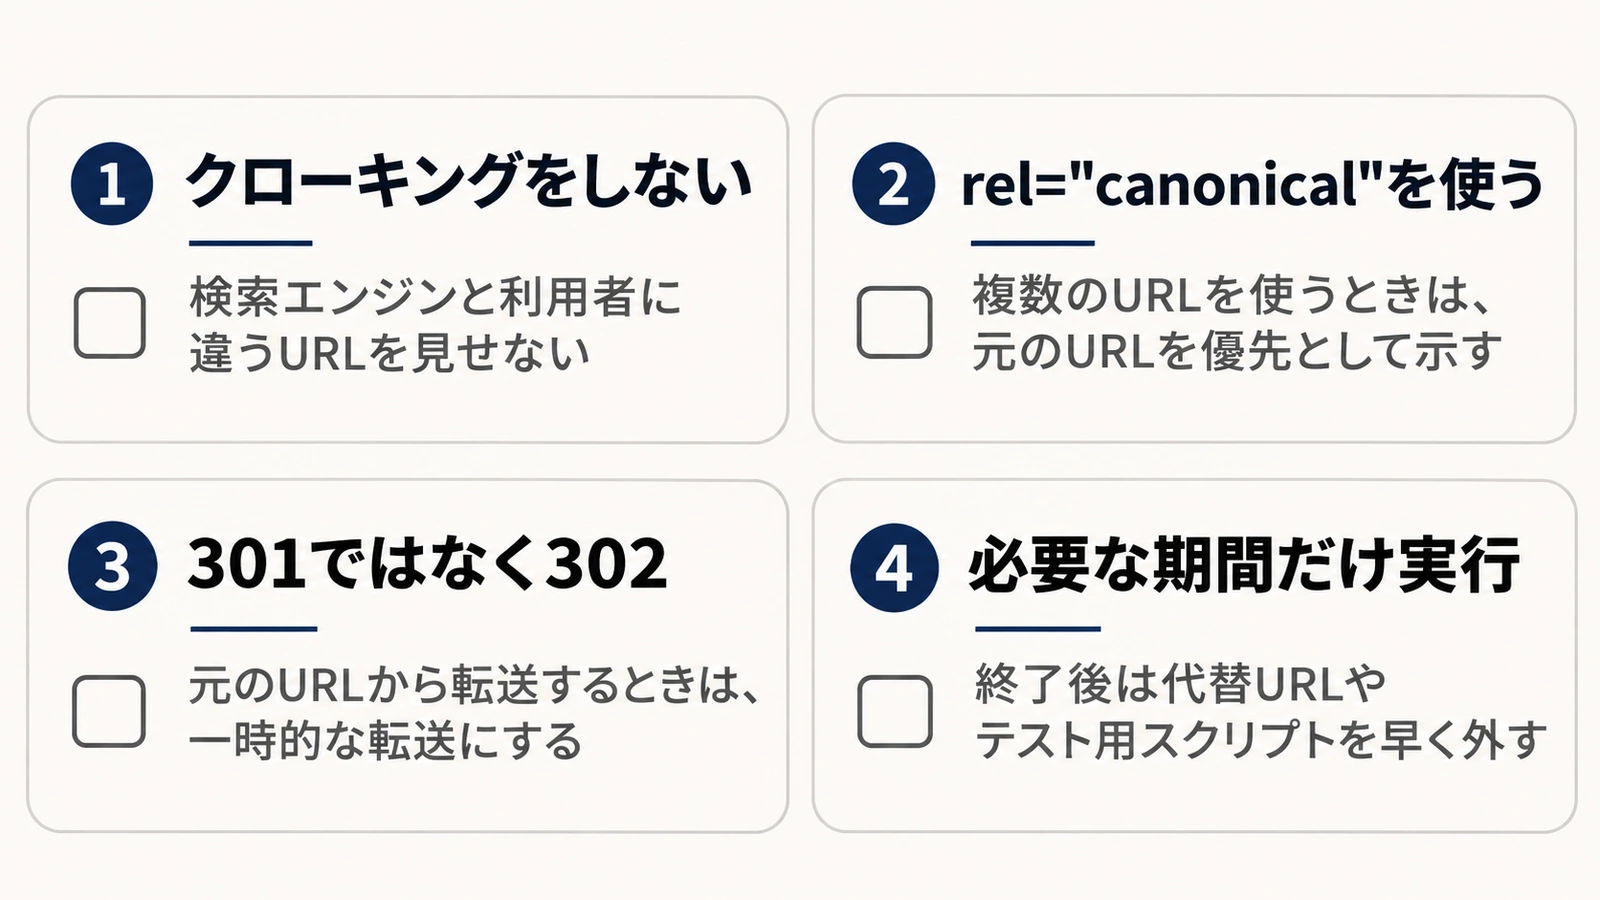
いずれもGoogle検索セントラルの説明にもとづく注意点です。
Googleは、テストの長さはコンバージョン率やトラフィックなどで変わるとしています。終了条件は、サンプルサイズの計算で決めた期間と、この「必要な期間だけ」の考え方を両方満たす形にします。ここで示したのは、テストと検索結果の関係についての注意点です。使うテストツールごとの設定方法や、サイトの仕組みによる違いは扱っていません。
判断の方法|結果を4つに分けて、次の動きを決める
結果が出たら、始める前に決めた基準にそって、次の4つのどれに当たるかを見ます。
| 結果 | 見方 | 次の動き |
|---|---|---|
| 基準を満たして改善した | 採用の候補 | サイト全体へ反映し、反映後も指標を見る |
| 判定基準を満たさない(差が小さい場合や、低下した場合を含む) | 差がないか、検出できなかった | 変更の幅や仮説を見直して再テストする |
| 基準を満たして悪化した | 悪化を示す結果 | 元に戻すかを判断し、原因を考える |
| 振り分けの比率が設計から大きくずれている | 結果を信頼できない | 実装と計測を点検して、やり直す |
仮説が外れた場合は、原因を分析して新たな仮説で再テストします。「差がなかった」という結果は、「効果がない」と断定できる結果ではなく、「今回のテストでは差を検出できなかった」という結果です。次の仮説を考える材料として扱います。成果の数字だけでなく、なぜそうなったのかを次の仮説につなげることが、改善を続ける土台になります。改善全体の進め方は、CROの考え方とKPI・改善サイクルで解説しています。
始める前に確認したい6つの項目
- 仮説:課題、変更、理由、指標が1つの文で書けているかを確認する。
- 指標:成功を判断する数字を1つに絞り、補助的に見る数字も決める。
- 必要訪問数:現在のCVRと見つけたい改善幅から、必要な訪問数と日数を見積もる。
- 終了条件:必要訪問数の達成か、設定した期間の経過かを、始める前に決める。
- 実装:クローキングをしないこと、複数のURLを使う場合のcanonical、元のURLから転送する場合の302、終了後にテスト用の要素を外す手順を確認する。
- 振り分け:始める前に、振り分けの方法と偏りの点検方法を決める。始めたあと、結果を判定する前に、設計した比率どおりの人数になっているかを点検する。
まとめ
A/Bテストを始める前に、次の3つを決めます。成否を判断する指標を1つ、必要訪問数とそれを集められる日数、そして終了条件(必要訪問数の達成、または設定期間の経過)です。たとえば現在のCVRが2.0%のサイトで+20%の改善を見つけるには、1パターンあたり21,082人が必要で、1日にテストの対象になる新しい訪問者が3,000人なら約14日かかります。この日数が現実的でない場合は、変更の幅を大きくするか、クリックなど手前の指標に切り替えるか、検証を見送ります。
実装では、クローキングをしない、複数のURLを使うときはcanonicalを付ける、転送するときは302を使う、必要な期間だけ実行する、というGoogleが示す方法を守ります。結果は、改善・差なし・悪化・振り分けのずれの4つに分けて見ます。「差なし」は効果がないという意味ではないので、仮説を見直して次のテストにつなげてください。
参考文献・データ元
この記事で参照した情報を確認できます。
- Google検索セントラル「ウェブサイト テストと Google 検索」(最終更新 2025年12月31日) https://developers.google.com/search/docs/crawling-indexing/website-testing?hl=ja
- start-link「A/Bテスト完全ガイド」(公開 2026年3月3日、最終更新 2026年10月8日) https://start-link.jp/hubspot-ai/btob-marketing/website-cro/ab-test-complete-guide
- Hakky Handbook「ABテスト設計の基礎」(最終更新 2026年9月25日) https://book.st-hakky.com/data-analysis/ab-test-design-basics
- Keyu Nie, Zezhong Zhang, Bingquan Xu, Tao Yuan "Ensure A/B Test Quality at Scale with Automated Randomization Validation and Sample Ratio Mismatch Detection"(arXiv、2022年8月16日投稿) https://arxiv.org/abs/2208.07766
- Hae-Young Kim "Statistical notes for clinical researchers: Sample size calculation 2. Comparison of two independent proportions", Restorative Dentistry & Endodontics 41(2):154-156(2016年) https://pmc.ncbi.nlm.nih.gov/articles/PMC4868880
- ブリティッシュコロンビア大学統計学科「Sample size for comparing two proportions」 https://www.stat.ubc.ca/~rollin/stats/ssize/b2.html
- Wikipedia「Sample ratio mismatch」 https://en.wikipedia.org/wiki/Sample_ratio_mismatch
- Wikipedia「P-value」 https://en.wikipedia.org/wiki/P-value
- Wikipedia「Confidence interval」 https://en.wikipedia.org/wiki/Confidence_interval
‹ 親記事: オウンドメディアの集客導線とは?記事からリード獲得までを設計する全体像とCTA・リードマグネット・フォーム最適化の基本